
主题
第11章 大模型应用案例
大模型的技术底座归根结底还是计算机的程序,所有学过计算机程序的人都有一个共识:一个好的例子能起到事半功倍的作用。作为一个有 20 多年编程经历的人,我也支持这个共识。所以我们组织了一些具有代表性的案例来给大家演示从技术到应用的映射路径。当然这些例子都是基于大模型技术规律的高度抽象,并不代表在实际的应用中是有效且正确的。我们只是希望这些示例能够引导大家探索技术到实践的过程。所以在阅读本章的时候请注意:这些案例只用来演示过程,不代表该方案在实际应用中有效、可用。
本章代码说明:本章5个案例在真实系统中都是完整工程,实现动辄上千行(配置管理、日志、异常处理、并发控制、安全校验)。书中代码块只用来演示关键逻辑,多数经过精简,有的直接是伪代码——目的是让你看懂「这一层在干什么、为什么这么切」,不是提供可直接上线的实现。每个代码块前都有一行标记,含义与此相同。
11.1 视频识别游泳者溺水
上一章我们讨论了模型选型、推理架构、知识架构这些"基础设施"层面的决策。从这一章开始,我们把焦点从"怎么搭"转向"怎么用"——用五个真实案例展示大模型如何跨越比特与原子之间的鸿沟,在真实场景中落地。
第一个案例,我们来看计算机视觉中最紧迫的场景之一:溺水检测。
为什么是溺水
世界卫生组织(WHO, 2021)的数据显示,全球每年约有 23.6 万人死于溺水。在游泳池环境中,溺水者往往不会像影视剧里那样剧烈呼救——真实的溺水是安静的,人的本能反应是手臂下压、试图让口鼻露出水面,整个过程可能只有 20 到 60 秒。
救生员再专业,也只是人。人的注意力是有带宽上限的,尤其是在烈日下盯着水面八个小时后。摄像头不会累,但它需要被赋予"看懂溺水"的能力。这就是我们要解决的问题。
需求画像:这不是简单的目标检测
一开始你可能觉得,这不就是 YOLO 检测个人、判断他有没有乱动吗?实际远没有那么简单。游泳池的场景极其复杂:
- 光影干扰:阳光在水面上折射出的波纹会产生大量动态噪点,普通目标检测模型在这个场景下误检率极高。
- 多人互遮挡:游泳者在泳道中交错而过时,会产生严重的身体遮挡,同一个人可能在几帧内"消失"又"出现"。
- 溺水特征微妙:溺水者的运动模式区别于正常游泳——不是"不动",而是垂直挣扎、手臂快速划水但身体不下沉。这需要对连续帧中的骨骼关键点做时序分析。
- 实时性要求:从溺水发生到发出报警,延迟超过 5 秒就可能失去救援窗口。系统必须在每一帧上完成检测→追踪→行为分析→决策,延迟控制在 200ms 以内。
总结一下:我们要的不是一个"图里有没有人"的分类器,而是一个能理解游泳池中多目标时空行为的实时感知系统。这恰好是大模型擅长的领域——它负责视觉感知层的"看懂",而业务逻辑层(什么是溺水、什么不是)仍然由人的专家知识来定义。
架构设计:感知-追踪-分析三层管线
整个系统可以抽象为一条三阶段流水线:
严格来说,只有感知层用了大模型。追踪层和分析决策层用的是经典算法和专家规则。但这不是"大模型的失败"——恰恰相反,这是工程上最明智的架构选择。
大模型擅长视觉理解,但不擅长毫秒级的实时帧关联,也不具备游泳安全领域的业务知识。把这三者分开,各自用最合适的工具,才是落地的正确姿势。这也印证了本书一直强调的观点:大模型是能力体系中的一层,不是全部。
感知层:目标检测 + 姿态估计
感知层的核心技术是目标检测加人体姿态估计。每一帧视频经过两个并行模型:
- 检测模型:定位画面中所有游泳者的边界框,输出
[x1, y1, x2, y2, class_id, confidence]。 - 姿态模型:对每个检测到的人体输出 17 个关键点坐标(COCO 标准:鼻、眼、肩、肘、腕、髋、膝、踝等)。
这里有一个重要的技术选择:我们用 RTMDet 而不是更流行的 YOLO。原因是 YOLO 的预训练权重在游泳池场景下的泛化不够——它的训练数据主要是日常场景的行人,对游泳者这种呈现大量皮肤、非站姿的人体检出率偏低。RTMDet 在 COCO 上的 mAP 虽然与 YOLOv8 接近,但它的特征金字塔结构对部分遮挡目标的召回率更好,这对游泳池多人互遮挡的场景至关重要。
追踪层:从帧内检测到时序关联
感知层给每帧一堆边界框,但不知道"这帧里的人 A 和上帧里的人 B 是不是同一个"。
这里我们使用 DeepSORT 算法。核心逻辑是卡尔曼滤波预测 + 匈牙利匹配:
代码仅演示逻辑,非生产实现。
python
# 伪代码:追踪层的核心逻辑
for frame in video_stream:
    detections = detector(frame)        # [bbox, confidence, keypoints]
    # DeepSORT:卡尔曼滤波预测每个tracklet在当前帧的位置
    tracker.predict()
    # 匈牙利算法:将detections匹配到已有tracklets
    matches, unmatched = tracker.update(detections)
    for track_id, detection_id in matches:
        tracklet = tracker.tracklets[track_id]
        tracklet.add_observation(detections[detection_id])
每个游泳者被分配一个稳定的 track_id,这是后续行为分析的基础——没有稳定的 ID,你无法知道"这个人过去 30 帧在做什么"。
分析决策层:有限状态机 + 溺水规则
这一层才是真正的"溺水判断",也是人类专家知识的容器。
每个跟踪目标内部维护一个有限状态机(Finite State Machine, FSM),状态定义如下:
| 状态 | 含义 | 触发条件 |
|---|---|---|
NORMAL | 正常游泳 | 连续水平位移,姿态规律 |
SUSPECT | 疑似溺水 | 检测到垂直挣扎特征 |
ALERT | 确认溺水 | 疑似状态持续超过 N 帧 |
ABSENT | 暂离画面 | 目标消失(潜水/遮挡) |
状态转换规则是我们与游泳安全专家一起定义的。这里列出其中最关键的几条规则:
- 垂直位移检测:当躯干关键点(肩、髋)的垂直运动幅度超过水平运动幅度 2 倍,且持续 3 秒以上,进入
SUSPECT状态。 - 异常姿态检测:当手臂关键点(肘、腕)的运动频率超过 2Hz,同时头部关键点在水面以下(需水面线标定),进入
SUSPECT状态。 - 消失时间窗口:目标消失超过 30 秒 → 报警。
这些规则看起来简单,但在真实场景中极其有效。因为游泳池溺水者的行为模式是高度集中的——它不像公路交通事故那样花样百出。只要抓住了垂直挣扎和长时间下潜这两个核心特征,就能覆盖绝大多数溺水事件。
核心实现
下面是系统核心管线的精简实现。为了清晰展示原理,这里省略了完整的工程化处理(配置管理、日志、异常处理等),保留了可运行的调度与指令解析逻辑;感知层(目标检测、姿态估计)以接口形式留出,需要你自行接入相应模型才能跑完整链路。
代码仅演示逻辑,非生产实现。
python
"""
溺水检测核心管线(精简版)
环境要求:Python 3.10+
依赖:opencv-python, numpy
(本块只做后续处理,不含感知层推理;感知层若接入 mmdet+mmpose,另需 PyTorch 2.0+ 与 CUDA 12.1+)
"""

import cv2
import numpy as np
from dataclasses import dataclass, field
from typing import Dict, List, Tuple, Optional
from enum import Enum
import time


# ── 数据结构 ────────────────────────────────────────────

class SwimmerState(Enum):
    NORMAL = "normal"
    SUSPECT = "suspect"
    ALERT = "alert"
    ABSENT = "absent"


@dataclass
class Keypoint:
    """单个关键点(COCO 17点标准)"""
    x: float
    y: float
    confidence: float


@dataclass
class SwimmerTracklet:
    """单个游泳者的追踪记录"""
    track_id: int
    state: SwimmerState = SwimmerState.NORMAL
    state_counter: int = 0          # 当前状态持续帧数
    absent_counter: int = 0         # 消失帧数
    history: List[Dict] = field(default_factory=list)  # 最近N帧的姿态历史

    def update_state(self, new_state: SwimmerState):
        if new_state == self.state:
            self.state_counter += 1
        else:
            self.state = new_state
            self.state_counter = 1


# ── 感知层:目标检测 + 姿态估计 ──────────────────────────

class PerceptionLayer:
    """
    感知层封装:目标检测 + 人体姿态估计。
    实际项目中我们用 mmdet + mmpose,这里为可读性简化为接口。
    """

    def __init__(self):
        # 实际部署代码:
        # from mmdet.apis import init_detector, inference_detector
        # from mmpose.apis import init_model, inference_topdown
        # self.det_model = init_detector(config, checkpoint, device='cuda:0')
        # self.pose_model = init_model(config, checkpoint, device='cuda:0')
        raise NotImplementedError("实际部署需配置 mmdet/mmpose 模型路径,"
                                  "详见项目 README 的环境搭建章节")

    def detect_and_pose(self, frame: np.ndarray) -> List[Dict]:
        """
        输入一帧图像,输出所有检测到的人体及其姿态。

        返回: [
            {
                "bbox": [x1, y1, x2, y2],
                "confidence": 0.95,
                "keypoints": [Keypoint, ...]  # 17个COCO关键点
            },
            ...
        ]

        完整实现示例(需配置模型路径后方可运行):
            det_results = inference_detector(self.det_model, frame)
            persons = []
            for det in det_results:
                if det['category_id'] == 0:  # person class
                    pose = inference_topdown(self.pose_model, frame,
                                             [det['bbox']])
                    persons.append({
                        "bbox": det['bbox'],
                        "confidence": det['score'],
                        "keypoints": [Keypoint(k[0], k[1], k[2])
                                      for k in pose[0]['keypoints']]
                    })
            return persons
        """
        raise NotImplementedError(
            "detect_and_pose 需要配置 mmdet/mmpose 模型后运行"
        )


# ── 追踪层:DeepSORT 多目标追踪 ──────────────────────────

class TrackingLayer:
    """
    追踪层:将帧内检测结果关联为时序追踪序列。
    基于 DeepSORT 的卡尔曼滤波 + 匈牙利匹配。
    """

    def __init__(self, max_age: int = 900, min_hits: int = 3,
                 iou_threshold: float = 0.3):
        """
        Args:
            max_age: 追踪目标消失多少帧后从活跃列表移除(默认900≈30秒@30fps)。
                     需 ≥ DrowningAnalyzer.ABSENT_ALERT_TIME,否则 absent 报警不可达。
            min_hits: 新目标至少被连续检测到多少帧才确认为有效追踪。
            iou_threshold: IOU 匹配的最低阈值。
        """
        self.tracklets: Dict[int, SwimmerTracklet] = {}
        self.next_id = 0
        self.max_age = max_age
        self.MIN_AGE_FOR_DELETE = max(max_age, 1800)  # 从内存彻底删除的阈值
        self.min_hits = min_hits
        self.iou_threshold = iou_threshold

    def update(self, detections: List[Dict]) -> List[SwimmerTracklet]:
        """
        输入当前帧检测结果,更新追踪状态。
        返回当前活跃的所有 tracklet。

        简化实现:使用 IOU 贪心匹配关联检测与已有 tracklet。
        生产环境建议替换为 deep_sort_realtime 等库的完整实现
        (含卡尔曼滤波预测 + 匈牙利匹配 + ReID 外观特征)。
        """
        # ── Step 1: 计算检测与现有 tracklet 的 IOU 矩阵 ──
        active_tracks = [
            (tid, t) for tid, t in self.tracklets.items()
            if t.absent_counter < self.max_age
        ]
        matched_track_ids = set()
        matched_det_ids = set()

        for det_idx, det in enumerate(detections):
            det_bbox = det.get("bbox", [0, 0, 0, 0])
            best_iou = 0.0
            best_tid = None

            for tid, tracklet in active_tracks:
                if tid in matched_track_ids:
                    continue
                if not tracklet.history or 'bbox' not in tracklet.history[-1]:
                    continue
                last_bbox = tracklet.history[-1]['bbox']
                iou_val = self._iou(last_bbox, det_bbox)
                if iou_val > best_iou:
                    best_iou = iou_val
                    best_tid = tid

            if best_iou >= self.iou_threshold and best_tid is not None:
                # 匹配成功:更新已有 tracklet
                tracklet = self.tracklets[best_tid]
                tracklet.history.append(det)
                tracklet.absent_counter = 0
                matched_track_ids.add(best_tid)
                matched_det_ids.add(det_idx)

        # ── Step 2: 未匹配的检测 → 新建 tracklet ──
        for det_idx, det in enumerate(detections):
            if det_idx not in matched_det_ids:
                tracklet = SwimmerTracklet(track_id=self.next_id)
                tracklet.history.append(det)
                self.tracklets[self.next_id] = tracklet
                self.next_id += 1

        # ── Step 3: 未匹配的 tracklet → absent_counter++ ──
        for tid, tracklet in active_tracks:
            if tid not in matched_track_ids:
                tracklet.absent_counter += 1

        # ── Step 4: 清理消失过久的 tracklet(仅当超过 MIN_AGE_FOR_DELETE 才从内存删除)──
        for tid in list(self.tracklets.keys()):
            if self.tracklets[tid].absent_counter > self.MIN_AGE_FOR_DELETE:
                del self.tracklets[tid]

        # 返回当前活跃的 tracklet(含 absent 但未超过 max_age 的目标)
        return [
            t for tid, t in self.tracklets.items()
            if t.absent_counter < self.max_age
        ]

    def _iou(self, bbox_a: List[float], bbox_b: List[float]) -> float:
        """计算两个边界框的 IOU(交并比)。"""
        xa = max(bbox_a[0], bbox_b[0])
        ya = max(bbox_a[1], bbox_b[1])
        xb = min(bbox_a[2], bbox_b[2])
        yb = min(bbox_a[3], bbox_b[3])
        inter_area = max(0, xb - xa) * max(0, yb - ya)
        area_a = (bbox_a[2] - bbox_a[0]) * (bbox_a[3] - bbox_a[1])
        area_b = (bbox_b[2] - bbox_b[0]) * (bbox_b[3] - bbox_b[1])
        union_area = area_a + area_b - inter_area
        if union_area <= 0:
            return 0.0
        return inter_area / union_area


# ── 分析决策层:溺水行为分析 ──────────────────────────────

class DrowningAnalyzer:
    """
    分析决策层:对每个追踪目标做行为判断。
    核心逻辑:有限状态机 + 专家规则 + 滞回机制。
    """

    SUSPECT_DURATION = 90     # 疑似状态持续90帧(约3秒@30fps)→ 报警
    ABSENT_ALERT_TIME = 900   # 消失900帧(约30秒)→ 报警

    # 滞回机制参数(详见"踩坑3")
    ENTER_SUSPECT_THRESHOLD = 3    # 进入疑似需连续3帧满足条件
    EXIT_SUSPECT_THRESHOLD = 15    # 退出疑似需连续15帧不满足条件

    # COCO 关键点索引
    KP_NOSE = 0
    KP_LEFT_SHOULDER = 5
    KP_RIGHT_SHOULDER = 6
    KP_LEFT_WRIST = 9

    def __init__(self, waterline_y: Optional[float] = None):
        self.waterline_y = waterline_y  # 水面线纵坐标(像素),需现场标定

    def analyze(self, tracklets: List[SwimmerTracklet]) -> List[str]:
        """分析所有活跃追踪目标,返回报警列表。"""
        alerts = []
        for t in tracklets:
            new_state = self._evaluate_state(t)

            # ── 滞回机制:防止状态在 NORMAL/SUSPECT 间反复切换 ──
            if new_state == SwimmerState.SUSPECT and t.state == SwimmerState.NORMAL:
                # NORMAL → SUSPECT:需要连续满足触发条件
                if not hasattr(t, '_suspect_counter'):
                    t._suspect_counter = 0
                t._suspect_counter += 1
                if t._suspect_counter < self.ENTER_SUSPECT_THRESHOLD:
                    new_state = SwimmerState.NORMAL  # 还不够,保持 NORMAL
                else:
                    t._suspect_counter = 0  # 进入 SUSPECT,重置计数
            elif new_state == SwimmerState.NORMAL and t.state == SwimmerState.SUSPECT:
                # SUSPECT → NORMAL:需要连续不满足触发条件
                if not hasattr(t, '_normal_counter'):
                    t._normal_counter = 0
                t._normal_counter += 1
                if t._normal_counter < self.EXIT_SUSPECT_THRESHOLD:
                    new_state = SwimmerState.SUSPECT  # 还不够,保持 SUSPECT
                else:
                    t._normal_counter = 0  # 退出 SUSPECT,重置计数
            else:
                # 非 NORMAL↔SUSPECT 转换,重置所有滞回计数
                if hasattr(t, '_suspect_counter'):
                    t._suspect_counter = 0
                if hasattr(t, '_normal_counter'):
                    t._normal_counter = 0

            t.update_state(new_state)

            if t.state == SwimmerState.ALERT and t.state_counter == self.SUSPECT_DURATION:
                alerts.append(f"[ALERT] 泳者 #{t.track_id} 疑似溺水!位置: {t.history[-1]}")

            if t.state == SwimmerState.ABSENT and t.absent_counter == self.ABSENT_ALERT_TIME:
                alerts.append(f"[ALERT] 泳者 #{t.track_id} 已消失30秒,请立即检查!")
        return alerts

    def _evaluate_state(self, tracklet: SwimmerTracklet) -> SwimmerState:
        """评估单个泳者的当前状态(不含滞回,滞回由 analyze() 统一处理)。"""
        # 检查是否有足够的姿态历史(absent 中的 tracklet 无新数据,返回 ABSENT)
        if tracklet.absent_counter > 0:
            # 有新增 history 数据时(本帧刚匹配成功),仍运行后续规则
            # 否则缺少新 keypoints,保持 absent 评估
            if len(tracklet.history) == 0 or (
                len(tracklet.history) >= 2
                and tracklet.history[-1] == tracklet.history[-2]
            ):
                return SwimmerState.ABSENT

        if len(tracklet.history) < 30:
            return tracklet.state  # 数据不足,维持原状态

        recent = tracklet.history[-30:]  # 最近1秒(30fps)

        # 规则3:垂直位移检测
        vertical_movement = self._calc_vertical_movement(recent)
        horizontal_movement = self._calc_horizontal_movement(recent)

        if vertical_movement > horizontal_movement * 2.0 and vertical_movement > 0.5:
            return SwimmerState.SUSPECT

        # 规则4:头部位置检测(需要水面线标定)
        if self.waterline_y is not None:
            nose_y_values = []
            for frame_data in recent:
                kps = frame_data.get('keypoints', [])
                if len(kps) > self.KP_NOSE:
                    nose_y_values.append(kps[self.KP_NOSE].y)
            if nose_y_values:
                underwater_ratio = sum(
                    1 for y in nose_y_values if y > self.waterline_y
                ) / len(nose_y_values)

                if underwater_ratio > 0.8:
                    return SwimmerState.SUSPECT

        # 规则5:手臂运动频率异常
        arm_freq = self._calc_arm_frequency(recent)
        if arm_freq > 2.0:  # 大于2Hz,可能是溺水挣扎
            return SwimmerState.SUSPECT

        return SwimmerState.NORMAL

    def _calc_vertical_movement(self, history: List[Dict]) -> float:
        """计算躯干在垂直方向上的平均位移幅度。"""
        shoulder_y = []
        for frame_data in history:
            kps = frame_data.get('keypoints', [])
            if len(kps) > self.KP_LEFT_SHOULDER:
                shoulder_y.append(kps[self.KP_LEFT_SHOULDER].y)
        if len(shoulder_y) < 2:
            return 0.0
        return float(np.std(shoulder_y))

    def _calc_horizontal_movement(self, history: List[Dict]) -> float:
        """计算躯干在水平方向上的平均位移幅度。"""
        shoulder_x = []
        for frame_data in history:
            kps = frame_data.get('keypoints', [])
            if len(kps) > self.KP_LEFT_SHOULDER:
                shoulder_x.append(kps[self.KP_LEFT_SHOULDER].x)
        if len(shoulder_x) < 2:
            return 0.0
        return float(np.std(shoulder_x))

    def _calc_arm_frequency(self, history: List[Dict], fps: float = 30.0) -> float:
        """
        计算手臂关键点的运动频率(Hz):取腕关节 y 序列的主频。

        fps 默认 30(与"最近 1 秒(30fps)"的采样口径一致);视频帧率不同时必须传入真实值,
        否则频率会按比例失真。numpy 的 rfft 就够,不需要 scipy。
        注意:窗口 1 秒 + 30 帧 → 频率分辨率约 1 Hz,1 Hz 以下的差异分不开;要更细就加长窗口。
        """
        wrist_y = []
        for frame_data in history:
            kps = frame_data.get('keypoints', [])
            if len(kps) > self.KP_LEFT_WRIST:
                wrist_y.append(kps[self.KP_LEFT_WRIST].y)
        if len(wrist_y) < 10:
            return 0.0
        sig = np.asarray(wrist_y, dtype=float)
        spectrum = np.abs(np.fft.rfft(sig - sig.mean()))   # 去直流后看主频
        if spectrum.size < 2:
            return 0.0
        peak = int(np.argmax(spectrum[1:])) + 1            # 跳过直流分量
        return float(peak * fps / len(sig))


# ── 主管线 ─────────────────────────────────────────────────

class DrowningDetectionPipeline:
    """溺水检测主管线:串联感知→追踪→分析。"""

    def __init__(self, waterline_y: Optional[float] = None):
        self.perception = PerceptionLayer()
        self.tracking = TrackingLayer()
        self.analyzer = DrowningAnalyzer(waterline_y=waterline_y)

    def process_frame(self, frame: np.ndarray) -> Tuple[np.ndarray, List[str]]:
        """处理单帧:检测 → 追踪 → 分析,返回标注后的帧和报警列表。"""
        # Step 1: 感知
        detections = self.perception.detect_and_pose(frame)

        # Step 2: 追踪
        tracklets = self.tracking.update(detections)

        # Step 3: 分析决策
        alerts = self.analyzer.analyze(tracklets)

        # Step 4: 可视化(可选)
        frame = self._visualize(frame, tracklets)
        return frame, alerts

    def _visualize(self, frame: np.ndarray, tracklets: List[SwimmerTracklet]) -> np.ndarray:
        """绘制追踪框和状态标签。"""
        for t in tracklets:
            if t.history and 'bbox' in t.history[-1]:
                bbox = t.history[-1]['bbox']
                color = {
                    SwimmerState.NORMAL: (0, 255, 0),
                    SwimmerState.SUSPECT: (0, 255, 255),
                    SwimmerState.ALERT: (0, 0, 255),
                    SwimmerState.ABSENT: (128, 128, 128),
                }[t.state]
                cv2.rectangle(frame,
                              (int(bbox[0]), int(bbox[1])),
                              (int(bbox[2]), int(bbox[3])),
                              color, 2)
                cv2.putText(frame,
                            f"ID:{t.track_id} {t.state.value}",
                            (int(bbox[0]), int(bbox[1] - 10)),
                            cv2.FONT_HERSHEY_SIMPLEX, 0.5, color, 2)
        return frame

    def run(self, video_path: str, output_path: Optional[str] = None):
        """运行完整视频流处理。"""
        cap = cv2.VideoCapture(video_path)
        fps = cap.get(cv2.CAP_PROP_FPS)
        frame_idx = 0

        writer = None
        if output_path:
            fourcc = cv2.VideoWriter_fourcc(*'mp4v')
            width = int(cap.get(cv2.CAP_PROP_FRAME_WIDTH))
            height = int(cap.get(cv2.CAP_PROP_FRAME_HEIGHT))
            writer = cv2.VideoWriter(output_path, fourcc, fps, (width, height))

        total_start = time.time()
        while True:
            ret, frame = cap.read()
            if not ret:
                break

            frame_start = time.time()
            processed_frame, alerts = self.process_frame(frame)
            processing_time = (time.time() - frame_start) * 1000

            # 实时性监控
            if processing_time > 200:
                print(f"[警告] 帧 #{frame_idx} 处理耗时 {processing_time:.0f}ms,超过200ms阈值")

            for alert in alerts:
                print(f"[帧 #{frame_idx}] {alert}")

            if writer:
                writer.write(processed_frame)
            frame_idx += 1

        cap.release()
        if writer:
            writer.release()

        total_time = time.time() - total_start
        print(f"处理完成: {frame_idx} 帧, 总耗时 {total_time:.1f}s, "
              f"平均 {total_time/frame_idx*1000:.1f}ms/帧")
踩坑实录
这一节是给读者省时间的——下面列出的每一个坑,我们都掉进去过,每个都花了不少于两天的调试时间。
坑1:模型在游泳池视频上"瞎了"
第一次用 YOLOv8 预训练权重直接跑游泳池视频,检测结果惨不忍睹——大量漏检,置信度普遍在 0.3 以下。原因很直接:COCO 数据集的"person"类图像基本都是站立行走的人,而游泳池里的人体姿态(水平漂浮、部分浸入水中、身体只露出肩膀以上)在训练分布外。
解决方案:自己标注了约 2000 张游泳池场景图像,对 RTMDet 做 50 个 epoch 的微调。微调后的模型在游泳池场景下 mAP 从 0.42 提升到 0.78。标注成本是一周时间——不算大,但绝不能省。
坑2:水面反光让追踪器"跟丢"
追踪器偶尔会把水面反射的人影当成真人——一个泳者同时有两个 tracklet,一个跟随真身,一个跟随倒影。更糟的是,当人影和倒影在水面线交汇时,匈牙利匹配会乱掉。
解决方案:在追踪层加入运动一致性检查。如果某个 tracklet 的移动轨迹与水面镜像模式吻合(垂直翻转),标记为候选倒影。同时配合水面线 ROI 裁剪——只在水面线以下区域做检测。
坑3:有限状态机的"摆动问题"
最初的状态机设计太简单——单帧判断,导致状态在 NORMAL 和 SUSPECT 之间反复切换。这是因为游泳者的正常划水动作中,手臂也会有高频运动,单帧误判率在 15% 左右。
解决方案:引入滞回机制(hysteresis)——进入 SUSPECT 需要连续 3 帧满足条件(约 100ms),退出 SUSPECT 需要连续 15 帧不满足条件(约 500ms)。这个不对称设计让疑似报警的鲁棒性大幅提升,误报率从每分钟 3.2 次降到每小时 0.5 次。此机制已在核心实现的 analyze() 方法中完整实现(见 ENTER_SUSPECT_THRESHOLD 和 EXIT_SUSPECT_THRESHOLD 参数)。
坑4:水面线标定是"一毫米的工程"
水面线纵坐标 waterline_y 看似是一个参数的事,实际上受摄像头安装角度、池水水位变化、甚至泳客密度(人多了水面会轻微上升)的影响。我们最终设计了一个自动标定方案:在系统启动时取 30 帧无目标的纯水面图像,用边缘检测 + Hough 变换拟合水面线。同时支持管理员在 GUI 上手动微调。
视频预处理:从"视频"到"可分析的帧"
上面整条管线吃的都是"一帧一帧的画面",而输入是一个视频文件。这一段就是把它拆开——固定帧率抽帧 → 直方图帧差切场景 → 每场景取关键帧。抽帧率的选择是个权衡:逐帧(30fps)最准但算不完,5fps 是监控场景的常用折中;只有动作很快(跳水、冲刺)时才需要 10fps 以上。
代码仅演示逻辑,非生产实现。
python
# video_preprocess.py — 视频 → 帧 → 场景 → 关键帧
import json
import subprocess

import cv2


def iter_frames(path: str, target_fps: float = 5.0):
    """按固定帧率抽帧,顺便带回时间戳(秒)"""
    cap = cv2.VideoCapture(path)
    src_fps = cap.get(cv2.CAP_PROP_FPS) or 30.0
    step = max(1, round(src_fps / target_fps))
    idx = 0
    while True:
        ok, frame = cap.read()
        if not ok:
            break
        if idx % step == 0:
            yield idx / src_fps, frame
        idx += 1
    cap.release()


def scene_cuts(frames, hist_thresh: float = 0.4):
    """HSV 直方图帧差切场景:相邻帧直方图相关性低于阈值就算切点"""
    cuts = [0]
    prev = None
    for i, (_, frame) in enumerate(frames):
        hsv = cv2.cvtColor(frame, cv2.COLOR_BGR2HSV)
        hist = cv2.calcHist([hsv], [0, 1], None, [32, 32], [0, 180, 0, 256])
        cv2.normalize(hist, hist)
        if prev is not None and cv2.compareHist(prev, hist, cv2.HISTCMP_CORREL) < hist_thresh:
            cuts.append(i)
        prev = hist
    return cuts


def keyframes(frames, cuts):
    """每个场景取中间帧作为关键帧(够用且最省)"""
    frames = list(frames)
    for start, end in zip(cuts, cuts[1:] + [len(frames)]):
        if end > start:
            yield frames[(start + end) // 2]


def audio_info(path: str):
    """音频参数用 ffprobe 取(cv2 读不到音轨);没有音轨返回 None"""
    out = subprocess.run(
        ["ffprobe", "-v", "error", "-select_streams", "a:0",
         "-show_entries", "stream=codec_name,sample_rate,channels", "-of", "json", path],
        capture_output=True, text=True,
    )
    streams = json.loads(out.stdout or "{}").get("streams") or []
    if not streams:
        return None
    s = streams[0]
    return {"codec": s.get("codec_name"), "sample_rate": int(s.get("sample_rate", 0)),
            "channels": s.get("channels")}


if __name__ == "__main__":
    frames = list(iter_frames("pool.mp4", target_fps=5.0))
    cuts = scene_cuts(frames)
    print(f"抽到 {len(frames)} 帧,切出 {len(cuts)} 个场景")
    for ts, _ in keyframes(frames, cuts):
        print(f"  关键帧 @ {ts:.2f}s")
    print("音轨:", audio_info("pool.mp4"))
案例总结
这个案例最有价值的不是代码,而是架构选择背后的认知。
为什么感知层用大模型,决策层用专家规则? 因为溺水检测的本质是"物理世界的危险模式识别",不是"知识推理"。大模型擅长前者(从像素中看懂人),不擅长后者(理解什么是安全的游泳)。把专家知识编码为规则,把视觉理解交给大模型——这是当下 AI 应用最高效的组合方式。
为什么用 RTMDet 而不是更大的模型? 因为实时性。在 200ms 的延迟预算内,你没法跑一个 ViT 规模的模型。工程选择的本质是约束下的最优解,而不是参数量的炫耀。
这个架构可以迁移到哪里? 任何需要"连续视频流 + 时序行为分析 + 安全报警"的场景——工厂安全监控、交通异常检测、医院病房跌倒检测。感知层的模型可以换,追踪层的算法可以调整参数,但三层管线 + 状态机的架构模式是通用的。
下一节我们将转向一个完全不同的大模型应用场景:长篇小说生成。如果说溺水检测考验的是视觉感知的精度和实时性,那么长篇生成考验的就是模型在百万 token 的上下文中保持逻辑一致性的能力——这是另一维度的挑战。
技术声明:本节中的溺水检测规则(状态转换条件、阈值参数)来源于与国家级游泳救生培训机构合作制定的安全标准,非学术论文指标。YOLOv8/RTMDet 对比数据来源于作者团队的内部评测(游泳池场景,2000 张测试集)。DeepSORT 算法原理参考 Wojke et al. "Simple Online and Realtime Tracking with a Deep Association Metric", IEEE ICIP 2017。
11.2 长篇小说生成
上一节我们讨论了一个"看图救人"的计算机视觉案例——大模型在感知层展现出了理解复杂时空行为的能力。但大模型的潜力远不止"看":在"写"这件事上,它能做多深?短篇没问题,但长篇小说呢?
这就是本节要解决的问题。
短篇文章对大模型来说几乎不成问题——把整篇文章和指令一起塞进上下文,模型就能返回一个像样的结果。但一旦目标是一部长篇小说(十几万字甚至更长),问题就变了:上下文窗口装不下整部小说。
这不仅是篇幅问题。写长篇的真正挑战在于,第 20 章写到一个配角推门进来,这个人的名字、口音、右手的疤,在第 3 章就已交代过。大模型没有"记忆"——它只能看到你当前放进上下文的内容。怎么确保每次生成都"记得"之前埋下的伏笔?怎么保证修改一段对话后,人物性格不会悄悄走样?这些不是单纯的模型能力问题,而是上下文调度与一致性控制的系统设计问题。
本节介绍一种基于"上下文精简 + 任务解耦"的长篇小说生成方案。这个方案的核心理念不是让模型变聪明,而是通过工程手段弥补模型的上下文局限性,让它在写第 20 章时能像翻看前 19 章的笔记一样,知道哪些信息是必须记住的。
核心挑战:模型的"金鱼记忆"
当前主流大模型的上下文窗口虽然动辄宣称 128K 甚至 1M token,但窗口越大不等于模型越"记住"信息。研究表明(Liu et al., 2023, "Lost in the Middle"),大模型对上下文中间位置的信息注意度显著下降,且随着上下文增长,生成质量和事实准确性都会衰减。换句话说,把整部小说塞进去,不代表它能真正用好这些信息。
就像一条金鱼,鱼缸再大,它也只能关注眼前那一小片水域——模型的注意力同样如此,信息多了反而容易"失焦"。
因此实际工程中,我们面对两个递进的难题:
- 连贯性保持——如何在生成第 N 章时,让模型"记住"第 1 章到第 N-1 章的关键信息(角色设定、伏笔、矛盾冲突线)?
- 风格锁定——在多轮修改中(语句润色、风格调整、对话打磨),如何保证同一角色在不同轮次中的语言风格不漂移?
这两个问题在短文本中不明显。写 500 字的短篇,你可以在对话里反复强调"保持严谨风格"。但当你写 10 万字,经历上百轮交互后,模型很容易悄悄"改换门庭"——男主从沉默寡言变成了话痨,从"嗯"变成了"我觉得吧……"。
方案设计:提纲锚定 + 分节生成 + 硬引用修改
整个方案可以抽象为三个核心机制。
1. 提纲锚定(Outline Stem Prompting)
在开始任何一节的生成之前,先建立一张全局"记忆卡"。这张记忆卡包含:
- 完整的故事大纲(章节目录结构 + 每章核心事件)
- 角色设定表(姓名、性格关键词、经典对话风格、关键外貌特征)
- 已完成章节的摘要(每节约 200 字,只记"发生了什么"和"埋了什么伏笔")
每次生成新内容时,将这张记忆卡作为 prompt 的固定前缀动态拼接进去。这就是 Stem Prompting:用一个高度凝练的"记忆种子"锚定模型的输出方向。
[系统提示] 你是一位小说作者。
[记忆卡]
故事大纲:...
角色设定:...
前3章摘要:...
[当前任务] 请撰写第4章第2节,场景是...
关键设计在于"凝练"二字。不要试图把前文全文塞进去——"中间信息衰减"效应告诉我们,冗余信息只会稀释模型对关键信息的注意力。只保留"对当前写作有用的":角色此刻的情感状态、当前冲突线的进展、需要前后呼应的伏笔。
所谓的"上下文滑动窗口",就是指这个记忆卡的设计:它永远只保留最近 N 节的关键信息,旧的摘要自动丢弃,新的摘要自动追加——像一个在时间轴上前进的窗口,只装入当前最相关的上下文。
2. 分节生成(Section-Level Writing)
不要把整个章节一次性交给模型。以"小节"为单位逐步生成——每节的篇幅控制在模型能良好处理的范围内(建议 800~1500 字),并在每轮输入中刷新记忆卡:
- 生成第 1 节 → 产出内容 → 更新记忆卡(补充本节摘要)
- 生成第 2 节 → 输入:更新后的记忆卡 + 前一节上下文 → 产出
- 以此类推,逐节推进
这种做法有双重好处:
- 注意力聚焦:每次生成的内容量适中,模型不容易"失焦"
- 信息刷新:记忆卡在每一节结束后更新,确保后续生成拿到的是最新的故事状态
经验提示:即使大模型的上下文窗口能装下全文,也建议控制单次生成的内容量。窗口够大≠质量够好。800~1500 字/节是实践中效果较好的区间。
3. 硬引用修改(Hard-Reference Editing)
写完初稿后,进入修改阶段。这里的典型场景是:"请把第 3 节中男主和张老师的对话改得更犀利一些。"
如果直接把这类指令丢给模型,它需要自己在上下文中搜索"第 3 节的对话",再判断哪些部分需要修改。这个"找"的过程本身就是信息衰减的源头——模型可能找错位置,或者只找到对话的一半。
更好的做法是直接将待修改内容硬编码进 prompt:
请修改以下原文中男主和张老师的对话,使其更加犀利:

【原文】
张老师:你考虑好了?
李明:嗯。
张老师:这条路不好走。
李明:我知道。

【要求】保持李明简洁的风格,但让他每次回应的用词更有力度。这就是"硬引用"——不要依赖模型从长篇上下文中定位目标内容,直接把要改的东西贴在指令里。这样做的好处很直观:让模型只做"改"这一件事,不做"找"这件事。
举个反面例子。假设第 3 节的整段上下文长约 5000 字,你只发指令"把第 3 节中男主和张老师的对话改得更犀利",模型需要在这 5000 字中自己搜索"和张老师相关"的片段。经常出现的情况是:模型把男主和另一位角色(比如刘阿姨)的对话也误拉过来一并修改,或者只找到这段对话的后半截,遗漏了开头的铺垫句。而硬引用把"找"和"改"解耦——你手动定位了 < 200 字的目标片段,模型只在上面做风格调整。两个步骤分别归人和模型负责,各做各擅长的事。
一句话总结三个机制的关系
提纲锚定管"记"(让模型知道该记住什么),分节生成管"写"(让每次生成的任务量可控),硬引用修改管"改"(让修改指令精确命中目标)。
任务解耦:Multi-Agent 协作的雏形
当你把上述机制落地为一个可运行的系统时,会发现一个自然的设计趋势:不同性质的任务需要不同的 prompt 设计。
- 写新剧情时,需要角色设定 + 故事情节 + 写作风格
- 校对一致性的,需要角色设定 + 全文摘要 + 待检查文本
- 润色语言时,只需要原文 + 风格要求
把这些任务混在一个 prompt 里让模型同时做写剧情、校对、润色,结果通常是一件事都做不好。更合理的做法是任务解耦:
[写剧情 Agent]
输入:记忆卡(大纲 + 角色 + 前期摘要)+ 本节提示
输出:本节剧情内容
角色:创造力优先,允许适当发散

[校对 Agent]
输入:角色设定 + 已完成章节摘要 + 新生成内容
输出:一致性检查报告(角色行为是否一致?伏笔是否呼应?)
角色:审慎优先,以发现不一致为首要任务

[润色 Agent]
输入:待修改原文 + 风格指令
输出:润色后文本
角色:语言优先,关注节奏和质感
这三个"Agent"本质上是对大模型 API 的三次不同调用,区别仅在于 prompt 的设计和输入数据的组织方式。但这恰好是 Multi-Agent 协作的雏形:每个"Agent"专注一件事,各司其职,结果交给下一个环节处理。
更重要地,这种解耦让每个环节的上下文都非常精炼。校对 Agent 的输入中不需要包含润色指令,润色 Agent 也不需要看到完整的角色设定。每个调用只拿到它该拿的信息,信息噪音降到最低。
为什么润色 Agent 不需要角色设定? 润色的聚焦点是文字流畅度和风格一致性。角色设定已在写作阶段注入了原文——比如"陈远话少"这个设定已经体现在他说的"嗯"和"我知道"的短句中。润色 Agent 的工作是让这些已有特征表达得更好,而不是重新塑造角色。它只需识别文中已有的角色语言特征并保持下去。如果把角色设定再传一次,反而容易让润色 Agent "越权"去调整人物性格本身,造成过度修改。
实践演示:一个可运行的框架
📖 阅读导引:下面是整个方案的 Python 实现骨架。代码较长,初次阅读建议先扫一遍结构(三个类、四个核心函数),不用逐行读懂——后面的"关键技术要点"会挑三个关键设计逐一拆解。
下面是该方案的一个简化实现框架,用 Python 代码展示核心思路。
代码仅演示逻辑,非生产实现。
python
"""
长篇小说生成框架 - 核心骨架
演示"提纲锚定 + 分节生成 + 硬引用修改"的工作流

环境要求:Python 3.10+, openai >= 1.0.0
使用方法:设置环境变量 OPENAI_API_KEY,将 MODEL_NAME 替换为你的实际模型名
"""

import os
import json
from openai import OpenAI

# ---------- 配置 ----------
# 可替换为你使用的任何兼容 OpenAI SDK 的模型(如 DeepSeek、Qwen、GPT-4 等)
MODEL_NAME = "your-model-name"
client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))

# ---------- 记忆卡管理 ----------
class MemoryCard:
    """全局记忆卡:大纲 + 角色设定 + 章节摘要"""

    def __init__(self, outline: str, characters: dict):
        self.outline = outline
        self.characters = characters  # {name: {desc, keywords, speech_style}}
        self.chapter_summaries = []   # [{chapter, section, summary}]

    def add_summary(self, chapter: int, section: int, summary: str):
        self.chapter_summaries.append({
            "chapter": chapter, "section": section, "summary": summary
        })

    def build_prompt_context(self) -> str:
        """构建可作为 prompt 前缀的记忆卡上下文"""
        parts = ["【故事大纲】", self.outline, ""]

        parts.append("【角色设定】")
        for name, info in self.characters.items():
            speech = info.get("speech_style", "")
            keywords = ", ".join(info.get("keywords", []))
            desc = info.get("desc", "")
            parts.append(f"- {name}:{desc}({keywords})说话风格:{speech}")

        if self.chapter_summaries:
            parts.append("\n【已有章节摘要】")
            # 只保留最近 5 节摘要 —— 这是"选择性遗忘"的核心实现
            # 通过切片丢弃旧摘要,避免上下文臃肿导致模型注意失焦
            for s in self.chapter_summaries[-5:]:
                parts.append(f"第{s['chapter']}章第{s['section']}节:{s['summary']}")

        return "\n".join(parts)


# ---------- 写作 Agent ----------
def write_section(memory: MemoryCard, chapter: int, section: int,
                  prompt_hint: str, temperature: float = 0.8) -> str:
    """
    分节生成:用记忆卡作为上下文,撰写小说的一个小节
    """
    context = memory.build_prompt_context()
    response = client.chat.completions.create(
        model=MODEL_NAME,
        temperature=temperature,
        messages=[
            {
                "role": "system",
                "content": (
                    "你是一位经验丰富的小说作家。请根据大纲、角色设定和已有章节摘要,"
                    "创作指定内容。保持人物性格和语言风格的一致,自然融入已有伏笔。"
                    "单次产出控制在800~1500字。"
                ),
            },
            {
                "role": "user",
                "content": f"{context}\n\n【当前任务】撰写第{chapter}章第{section}节。{prompt_hint}"
            },
        ],
    )
    return response.choices[0].message.content


# ---------- 校对 Agent ----------
def consistency_check(memory: MemoryCard, new_content: str) -> str:
    """
    校对 Agent:一致性检查 —— 用角色设定和已有摘要,检查新内容的一致性
    """
    context = memory.build_prompt_context()
    response = client.chat.completions.create(
        model=MODEL_NAME,
        temperature=0.3,  # 校对任务用低温度,提高确定性
        messages=[
            {
                "role": "system",
                "content": (
                    "你是一位严格的文字编辑。请检查以下新生成的小说内容是否与角色设定"
                    "和已有情节一致。重点关注:1)人物行为是否符合性格设定 "
                    "2)对话风格是否一致 3)是否存在与已有情节矛盾之处。"
                    "如有问题,逐条指出。如无问题,回复'一致性检查通过'。"
                ),
            },
            {
                "role": "user",
                "content": f"{context}\n\n【待检查内容】\n{new_content}"
            },
        ],
    )
    return response.choices[0].message.content


# ---------- 润色 Agent ----------
def polish_text(original: str, style_instruction: str) -> str:
    """
    硬引用修改:直接将待修改原文传入,结合风格指令进行润色
    """
    response = client.chat.completions.create(
        model=MODEL_NAME,
        temperature=0.6,
        messages=[
            {
                "role": "system",
                "content": (
                    "你是一位文字润色专家。请对以下原文进行润色,严格遵循风格要求。"
                    "仅修改语言表达,不改动事实信息和情节走向。"
                ),
            },
            {
                "role": "user",
                "content": f"【风格要求】{style_instruction}\n\n【原文】\n{original}"
            },
        ],
    )
    return response.choices[0].message.content


# ---------- 主工作流 ----------
# 以下为演示代码,运行前需配置 API Key。使用说明见代码底部。

def demo_workflow():
    """完整工作流演示"""

    # 1. 初始化记忆卡
    memory = MemoryCard(
        outline="""
        第一章:主角偶然发现一个神秘物件
        第二章:调查过程中遇到关键配角
        第三章:冲突升级,发现物件的真正来源
        """,
        characters={
            "陈远": {
                "desc": "28岁程序员,好奇心强但性格内向",
                "keywords": ["内向", "理性", "偶尔冷幽默"],
                "speech_style": "话少,每句话不超过20字,很少用感叹号"
            },
            "老吴": {
                "desc": "退休物理老师,65岁,知识渊博但脾气古怪",
                "keywords": ["博学", "古怪", "刀子嘴豆腐心"],
                "speech_style": "爱用反问句,偶尔引经据典,说话带点文言腔"
            },
        }
    )

    # 2. 分节生成(第1章第1节)
    print("=" * 40)
    print("▶ 写作 Agent:生成第1章第1节")
    section1 = write_section(
        memory, chapter=1, section=1,
        prompt_hint="陈远在周末整理父亲遗物时发现了那个盒子。描写发现过程和内心反应。"
    )
    print(section1)
    memory.add_summary(1, 1, "陈远发现父亲的旧木盒,内有神秘图纸和一把钥匙。")

    # 3. 校对检查
    print("\n" + "=" * 40)
    print("▶ 校对 Agent:一致性检查")
    check_result = consistency_check(memory, section1)
    print(check_result)

    # 4. 分节生成后续
    print("\n" + "=" * 40)
    print("▶ 写作 Agent:生成第1章第2节")
    section2 = write_section(
        memory, chapter=1, section=2,
        prompt_hint="陈远带着盒子去找退休物理老师老吴。描写两人的初次对话。"
    )
    print(section2)
    memory.add_summary(1, 2, "陈远找到老吴,老吴认出图纸中的符号与一项旧科研项目有关。")

    # 5. 润色修改
    print("\n" + "=" * 40)
    print("▶ 润色 Agent:硬引用修改")
    # 从 section2 中取一段对话进行润色(此处用模拟原文演示硬引用的方式)
    original_dialogue = """
    陈远把盒子放在桌上。
    老吴戴上老花镜,打开看了看。
    "这是你父亲的?"
    "是。"
    "他有没有提过这个符号?"
    "没有。"
    """
    polished = polish_text(
        original_dialogue,
        "保持老吴用反问句和引经据典的风格,让陈远的回应更冷淡但更有分量。"
    )
    print(polished)


if __name__ == "__main__":
    if not os.getenv("OPENAI_API_KEY"):
        print("❌ 请设置环境变量 OPENAI_API_KEY 后运行")
        print("   export OPENAI_API_KEY='your-key-here'")
        exit(1)
demo_workflow()代码拆解:上面框架中的三个关键设计点——记忆卡的"选择性遗忘"、温度参数的差异化、基线重置——下面逐一展开分析。
关键技术要点
1. 记忆卡的"选择性遗忘"设计
记忆卡不是越长越好。上文代码中 chapter_summaries[-5:] 只保留最近 5 节摘要,这是一种刻意设计的"遗忘"——对当前的写作任务来说,20 节前的细节大概率无关。保留过多的旧信息不仅浪费 token,还会稀释模型对关键信息的注意力。
代码中的 5 是一个保守默认值,实际使用时可根据单节篇幅和故事复杂度调整:
- 悬疑类:建议保留 8~12 节摘要(伏笔多、线索链条长),甚至可以维护一个独立的"未解伏笔索引"
- 日常类:3~5 节即可(角色关系和近期冲突线已足够支撑写作)
2. 温度参数的差异化
代码中将写剧情设为 0.8、校对设为 0.3、润色设为 0.6。这不是随意取值,而是基于任务性质的差异:
| 任务 | 温度 | 原因 |
|---|---|---|
| 写剧情 | 0.7~0.9 | 需要创造力,允许适度发散 |
| 校对 | 0.2~0.4 | 追求一致性和确定性,避免"制造问题" |
| 润色 | 0.5~0.7 | 在保持原意的前提下增加语言质感 |
表格给出的温度是推荐区间,代码中取区间中值偏上的具体值(0.8/0.3/0.6),兼顾了效果稳定性和复现性——在同一台机器上多次运行不会产生方差过大的输出。
3. 思维链截断——"修饰后的内容作为下次修改的输入"
源素材中提到一个重要经验:对某一小节进行语言修饰后,用修饰后的版本作为下一次修改的起点,而不是在原始版本上叠加修改。这相当于在多轮修改之间做"基线重置":
原始文本 → 润色(风格A) → 产出v1 → 润色(风格B) → 产出v2 → 润色(节奏调整) → 产出v3
         ↑ 以v1为基线          ↑ 以v2为基线
如果每次都在原始文本上叠加修改指令,几轮之后指令会变得臃肿混乱("保留第1轮的对话犀利,撤销第2轮的情绪变化,在对话中再增加一点张力……")。基线重置法让每轮修改只需要考虑"从当前版本出发做一件事",复杂度不随轮次递增。
为什么这个方案不过时
大模型的上下文窗口在持续扩大——从 128K 到 1M 甚至更大。有人可能会问:等窗口够大了,直接一股脑塞进去不就完了?还需要这些"调度技巧"吗?
答案是:需要。 原因有三:
第一,成本问题。1M token 上下文意味着每次 API 调用都要付费处理 100 万字的信息。你做一次简单的对话修改,背后处理了整个小说的上下文——这在商业上是不可持续的。
第二,"中间信息衰减"是模型架构层面的问题,增加窗口长度不能根治。你给模型的上下文越多,它反而越容易忽略真正重要的那几段。
第三,也是最关键的:逻辑的一致性控制不是窗口大小的问题,而是信息组织方式的问题。 人类作家写长篇小说时,也不是靠"全记住",而是靠大纲、人物卡、章节摘要这类工具——这正是本节提出的"记忆卡"理念。窗口变大只是让你能装更多东西,但你往里面装什么、以什么结构装,才是决定输出质量的关键。
这就是本节方案的核心价值所在:它不是依赖"模型够聪明就能全记住",而是建立一套工程化的上下文管理体系,让模型在"写"的时候只操心写,在"改"的时候只操心改,在"核对"的时候只操心核对。每个环节各司其职,信息高效传递——这种思路不会因为模型升级而失效,因为它解决的是写作行为本身的工程化问题,而非某个具体模型的局限。
本节要点速查
- 核心方案:提纲锚定(记忆卡做 prompt 前缀)+ 分节生成(每节 800~1500 字)+ 硬引用修改(修改内容直接贴入 prompt)
- 架构思想:任务解耦(写剧情 / 校对 / 润色拆分为独立 Agent 调用),是 Multi-Agent 协作的雏形
- 关键技巧:记忆卡的"选择性遗忘"(悬疑类 8-12 节、日常类 3-5 节)、温度参数的差异化设置、思维链截断的基线重置法
- 长期价值:上下文管理是工程方法,不依赖特定模型窗口大小,窗口再大也需要好的信息组织
11.3 对一个大模型进行微调
算法是透明的,算力是租来的,唯有数据集是你亲手打磨的铠甲。
在前两节,我们分别看到了如何用大模型"看图救人"和"写长篇小说"。这两个案例有一个共同点:它们依赖的是提示工程和外部工具链,模型本身的参数没有变。就像一位全科医生,通用且能应万变。
但如果你面对的是一堆冷冰冰的设备维保术语——"环形伪影"(探测器某一路通道增益漂移的典型表现)、"球管热容量只剩 12%"——你会发现通用大模型只能给你模棱两可的口水话,因为它从来没见过这些东西的"行话"长什么样。
这时候,你就需要**微调(Fine-tuning)**了。
微调的本质不是"教会模型新知识",而是用你自己的数据,帮模型找到正确的语气、领域术语和格式偏好。对大多数工程团队来说,微调的核心挑战不在于算法选型(LoRA 还是 QLoRA?全参还是冻结?),而在于一个更扎心的问题:
我喂给模型的,究竟是金子还是沙子?
本节将以一个真实的医疗器械维保微调场景为例,拆解数据集构建的全生命周期——从数据采集、清洗、分布设计,到最终的实战验证。
一句提醒:这一节讲的是"怎么造训练数据",不是维保操作手册。真实的校准、拆装、剂量调整,必须由持证人员按厂家手册执行——本节出现的所有参数和阈值都是示意,不能当作操作规程。
11.3.1 数据采集:从"专业手册"到"人话问答"
微调的第一步,是你手里有一堆专业材料——可能是 PDF 手册、技术文档、操作指南,甚至是从日志系统里扒出来的原始报文。这些材料有个共同特征:它们不是人话。
以某型号 CT 的厂家维修手册为例,原文可能是这样的:
Ring Artifact: Ring or concentric artifacts are typically caused by detector channel
gain drift, a single defective detector channel, or a calibration that no longer
matches the current tube output. Perform air calibration first; replace the detector
module only if the artifact persists after calibration.这不适合直接喂给模型做训练。微调需要的是问答对——"人问一句 → 模型回答一句"的交互式训练数据。而要把手册文字转化成问答对,最自然的方案就是:让更大的模型帮你生成。
别急着动手写提示词。这里有一个很多团队踩过的坑:让 GPT-4o 直接生成 500 条问答对,结果一检查,50% 的答案都是"翻译腔"——字面上看着对,但内行人读着别扭。为什么会这样?因为提示词里缺少领域约束。
正确的做法是分两步走:
第一步:构建领域上下文注入(Context Injection)。 不是简单地告诉大模型"你是一个设备维保专家",而是把专业领域的术语表、缩写规范、场景描述写进系统提示词的上下文注入区。例如:
代码仅演示逻辑,非生产实现。
python
# domain_context.py — 领域知识注入模块
CT_SERVICE_CONTEXT = """
你是一个 CT 设备维保工程师。

关键术语规范:
- 球管:X 射线管,不要写成"X 光管"或"灯管"
- 探测器:Detector,不要写成"探头"(探头是超声设备的部件,混用会让技师找错位置)
- 空气校准:开机预热后对空气扫描,用于归一化探测器各通道的增益,不要和"质控检测"混为一谈
- 热容量:球管累计负荷,单位 HU;球管寿命按"曝光秒数(scan seconds)"报,不按"次数"报
- 剂量指标写 CTDIvol(mGy)和 DLP(mGy·cm),不要只写"剂量"
- 回答风格:使用医院设备科和第三方维保公司通用的中文术语,语气专业但易懂

禁止:
- 把"球管"写成"球馆"这类同音错别字
- 使用"你可以试试""这是一个很好的问题"等客服腔
- 编造不存在的故障代码含义、校准步骤或安全阈值——维保文档里的一条假步骤,可能换来的是一次误诊
"""
有了这个上下文,再让大模型生成问答对,出来的内容就不一样了。比如:
❌ 无上下文注入时:
Q: 环形伪影是什么? A: 这是图像上出现的一圈一圈的纹路,说明设备可能需要维护一下哦!
✅ 有上下文注入后:
Q: 环形伪影是什么? A: 环形伪影(Ring Artifact)是重建图像上以旋转中心为圆心的一圈或多圈环状条纹,本质是探测器某一通道(或几个相邻通道)的响应与相邻通道不一致——该通道的读数在全周扫描里始终偏低或偏高,投影重建后就被拉成了一个环。常见成因有三种:通道增益漂移、单个探测模块失效、球管更换或输出衰减后未重新做空气校准。判别顺序是先做空气校准再扫体模:校准后伪影消失属漂移,仍在则大概率是硬件通道故障。它不是"图像不好看"的问题,环带覆盖区域内的 CT 值会失真。
差距一目了然。前者是"AI 翻译腔",后者才有行业内的"硬核味"。
第二步:引入生成-评审机制。 只用一个大模型生成数据还不够——它输出的东西里一定有"看起来对、实际上有细微偏差"的内容。你人在看的时候能发现,但你不可能手检 500 条。
解决方式是引入一个裁判模型(Judge Model),用不同架构的模型去"挑刺":
代码仅演示逻辑,非生产实现。
python
# data_judge.py — 裁判模型评估
import json
import os
import openai

# 裁判要用「不同架构」的模型。注意:OpenAI SDK 只认 OpenAI 协议,
# Anthropic 官方端点不是该协议 —— 要调用 Claude,需把 base_url 指向
# 支持 Anthropic 协议的中转网关(或用 anthropic 官方 SDK 的 client.messages.create)。
client = openai.OpenAI(
    base_url=os.environ.get("JUDGE_BASE_URL", "https://your-gateway.example.com/v1"),
    api_key=os.environ["JUDGE_API_KEY"],
)


def judge_qa_pair(question: str, answer: str, domain_doc: str) -> dict:
    """用裁判模型评估生成的问答对质量"""
    prompt = f"""你是一个医疗器械维保领域数据质量审核专家。

领域参考文档:
{domain_doc}

请评估以下问答对的质量:
---
问题:{question}
回答:{answer}
---

请从以下维度打分(1-5分):
1. 术语准确性:使用的专业术语是否正确?
2. 信息完整性:回答是否包含了必要的上下文?
3. 实效性:内容是否在行业实战中有用?
4. 自然度:读起来像不像一个真人专家在说话?

输出JSON格式。如果某项 < 4 分,请在输出中说明具体问题。"""

    response = client.chat.completions.create(
        model="claude-sonnet-4-20250514",  # 用不同架构的模型做裁判(模型名以官方文档为准)
        messages=[{"role": "user", "content": prompt}],
        response_format={"type": "json_object"}
    )
    return json.loads(response.choices[0].message.content)
这样,生成数据的模型(比如 GPT-4o)和审核数据的模型(比如 Claude)不是同一个架构,避免了"自己给自己批卷子"的偏差。裁判模型会逐条标注问题,你只需要人工抽查裁判模型认为"可疑"的那部分数据——剩下的高质量数据直接入库。
经验之谈:在 500 条候选数据中,裁判模型通常能揪出 5%-10% 需要人工复核的条目。这个投入产出比极高——你只需要花 20 分钟复核 35 条数据,而不是花 3 小时手检 500 条。
11.3.2 数据清洗:用元数据给每条数据"贴标签"
生成了 500 条问答对还不够——如果你把这些数据一锅炖直接喂给模型训练,效果往往不如人意。原因是:所有数据被平等对待了。但真实世界中,"什么是空气校准"和"环形伪影在通道漂移与球管衰减两种情况下的判别"显然不是一个难度的。
解决这个问题的方法是特征标签化(Feature Tagging)——在每条训练数据里嵌入元数据。我们为医疗器械维保微调场景设计了一个 JSONL 数据结构:
代码仅演示逻辑,非生产实现。
jsonl
{"messages": [{"role": "user", "content": "什么是空气校准?"}, {"role": "assistant", "content": "空气校准(Air Calibration)是在球管预热稳定后,不放置任何物体、直接对空气做一次扫描,用各通道的读数去归一化探测器增益的过程。因为每个通道的响应天然有差异,而且会随温度、球管输出和时间缓慢漂移,所以校准值必须跟着设备当前状态走。空扫之后系统会更新一张通道增益表,后续所有扫描的原始数据都按这张表修正。它属于常规维护动作,和每天开机做的质控检测(QC)不是一回事:QC 是判定设备还能不能用于诊断,空气校准是让探测器回到基准。"}], "metadata": {"difficulty": "easy", "category": "basic_concept", "source_quality": "verified", "source_doc": "service_manual_ct_3.2"}}
{"messages": [{"role": "user", "content": "球管老化后,图像质量会怎么变化?"}, {"role": "assistant", "content": "球管老化的核心是输出剂量下降和射线质变化,不是「突然坏掉」。在同样 kV、mAs 下,到达探测器的光子数变少,量子噪声上升,低对比度分辨力先下降——看软组织窗和低密度病灶时最明显,骨窗反而不容易察觉。更麻烦的是它会形成正反馈:设备为维持图像质量自动补偿 mAs,球管负荷随之上升,热容量告警出现得越来越频繁。所以判断球管是否该换,不看「用了几年」,而看三件事:热容量余量、同协议下的噪声水平、以及质控体模的 CT 值偏离。更换后必须重新做空气校准和质控检测,否则新球管的输出特性和旧校准表对不上,反而更容易出环状伪影。"}], "metadata": {"difficulty": "hard", "category": "failure_analysis", "source_quality": "verified", "source_doc": "tsb_ct_018"}}
... 依此类推,共 500 条,每条均含 metadata 标签。
每条数据的 metadata 里包含了四个关键标签:
| 标签 | 含义 | 典型取值 |
|---|---|---|
difficulty | 难度等级 | easy / medium / hard |
category | 知识领域 | basic_concept / failure_analysis / parameter_relation / ... |
source_quality | 来源可信度 | verified(手册原文) / generated(模型生成) / inferred(推理补充) |
source_doc | 来源文件 | 方便追溯,万一发现系统性错误可以批量回滚 |
这不是"多打几个字"的事情——这个标签体系带来的训练策略差异是巨大的。
最重要的应用:课程学习(Curriculum Learning)。 训练的时候,不把全部数据混在一起打散后随机喂。而是按照 difficulty 标签,分两个阶段:
- 第一阶段(Easy 数据,~2 个 Epoch):模型先建立基础概念。什么是空气校准、环形伪影到底是怎么来的。这个阶段的学习率可以设大一点(如 2e-4),让模型快速"入门"。
- 第二阶段(Easy + Medium + Hard 全量,~1 个 Epoch):加入故障分析和参数关联推理的复杂数据,学习率降到 1e-5,精细调校。
具体 epoch 数取决于数据规模——此处为约 500 条数据的经验值。如果你的数据集更大,建议适当减少 epoch,避免过拟合。
实践结果表明,这种"先易后难"的策略比一锅炖的微调效果好得多——尤其是在处理 hard 级别的故障分析问题时,准确率能从 40% 提升到 70% 左右。
而且 source_quality: "generated" 和 source_quality: "inferred" 标签还有一个隐性价值:如果某类数据的验证集表现差,你可以立刻回看:这些差的数据是不是都标注了 "generated"? 如果是,说明生成数据的质量可能有问题,需要重新生成或人工补充。
11.3.3 数据分布:同题异问与防污染
数据有了,标签打好了,接下来要解决一个更隐蔽的问题:数据污染(Data Contamination)。
什么叫数据污染?假设你有一道题:"什么情况下会出现环形伪影?"
你现在把这个知识点的三条变体都放进了训练集:
变体A:环形伪影的成因有哪些?
变体B:哪些情况会造成环形伪影?
变体C:出现环形伪影常见的原因包括哪些?
训练完了一看,测试集上准确率 95%——很开心是吧?但它测的是同一道题的"换皮版"。模型学会了"背题",而不是"理解"。真正的测试应该是:模型在训练集里从没见过的提问方式,能不能答对。
正确的划分策略是"语义级别"的聚类 + 分配。 实现方法是:先用嵌入模型将所有问题映射为向量,再用 DBSCAN(Density-Based Spatial Clustering of Applications with Noise,一种基于密度的聚类算法,简单来说就是"把靠得近的点归为一类")对语义相近的问题自动分组:
代码仅演示逻辑,非生产实现。
python
# data_split.py — 语义去重与三合一划分
import json
import numpy as np
from sentence_transformers import SentenceTransformer
from sklearn.cluster import DBSCAN

model = SentenceTransformer('paraphrase-multilingual-MiniLM-L12-v2')

def load_jsonl(path: str) -> list:
    data = []
    with open(path, 'r', encoding='utf-8') as f:
        for line in f:
            data.append(json.loads(line))
    return data

qa_pairs = load_jsonl("training_data.jsonl")

# 对问题做语义嵌入
questions = [qa["messages"][0]["content"] for qa in qa_pairs]
embeddings = model.encode(questions)

# 用 DBSCAN 聚类:语义相近的"同题异问"归为一组
# eps 控制"多近算同一题"。比如 eps=0.3 时,"环形伪影是什么"和"解释下环形伪影"
# 会被归为同一簇;eps=0.5 时,连"伪影"和"噪声"都可能被归为同一簇
# min_samples=1 表示"哪怕一条数据跟谁都不像,也给它单独一组"——这样不会丢失任何训练素材
# ⚠️ eps 不是通用常数:它取决于嵌入模型和你的数据。上线前先在小样本上扫 0.15~0.5,
#    看簇数是否合理 + 人工抽检簇内是否同题,再定值
clustering = DBSCAN(eps=0.3, min_samples=1, metric='cosine')
labels = clustering.fit_predict(embeddings)

# 同一 cluster 内的变体必须分布在不同的数据集里
train_indices, val_indices, test_indices = [], [], []
for cluster_id in set(labels):
    cluster_items = np.where(labels == cluster_id)[0]
    np.random.shuffle(cluster_items)

    if len(cluster_items) == 1:
        train_indices.extend(cluster_items)
    elif len(cluster_items) == 2:
        train_indices.append(cluster_items[0])
        val_indices.append(cluster_items[1])
    else:
        n = len(cluster_items)
        train_indices.extend(cluster_items[: int(n * 0.8)])
        val_indices.extend(cluster_items[int(n * 0.8): int(n * 0.9)])
test_indices.extend(cluster_items[int(n * 0.9):])核心思路是:不是按行随机打散,而是按语义 cluster 级别切分。同一个知识点的变体被均匀地分布在训练集、验证集和测试集中。如果模型在测试集上表现好,但训练集里从未见过这种问法——这才算真正的"理解"。
一个反直觉的事实:在微调场景中,数据量并不是越多越好,同质数据的边际价值递减极快。100 条覆盖了 100 个不同知识点的数据,比 1000 条覆盖了 10 个知识点的数据,训练效果要好得多。所以语义去重不是为了"省钱",而是为了"增效"。
最小可运行的 LoRA 训练
前面把"数据怎么来、怎么洗、怎么切"讲完了,但一直没出现训练代码。补一段最小的:单卡、Qwen2.5-0.5B、LoRA r=8、七个投影层挂适配器、只在 assistant 段算 loss。跑通它的意义不是训出好模型,而是让上面那套数据格式真正被验证过一遍。
代码仅演示逻辑,非生产实现。
python
# train_lora.py — 最小可跑的 LoRA 微调(单卡;Qwen2.5-0.5B fp16 约 4GB 显存)
# 依赖:pip install "transformers>=4.46" peft datasets accelerate
import json

import torch
from datasets import Dataset
from peft import LoraConfig, get_peft_model
from transformers import (AutoModelForCausalLM, AutoTokenizer,
                          DataCollatorForLanguageModeling, Trainer, TrainingArguments)

MODEL = "Qwen/Qwen2.5-0.5B-Instruct"

tokenizer = AutoTokenizer.from_pretrained(MODEL)
model = AutoModelForCausalLM.from_pretrained(MODEL, torch_dtype=torch.float16, device_map="auto")


def encode(example):
    """只对 assistant 段算 loss:user 段的 label 全部置 -100"""
    msgs = example["messages"]
    prompt = tokenizer.apply_chat_template(msgs[:-1], tokenize=False, add_generation_prompt=True)
    answer = msgs[-1]["content"] + tokenizer.eos_token
    p_ids = tokenizer(prompt, add_special_tokens=False)["input_ids"]
    a_ids = tokenizer(answer, add_special_tokens=False)["input_ids"]
    return {"input_ids": p_ids + a_ids, "labels": [-100] * len(p_ids) + a_ids}


rows = [json.loads(line) for line in open("train.jsonl", encoding="utf-8")]
ds = Dataset.from_list(rows).map(encode, remove_columns=["messages"])

lora = LoraConfig(
    r=8, lora_alpha=16, lora_dropout=0.05, bias="none", task_type="CAUSAL_LM",
    target_modules=["q_proj", "k_proj", "v_proj", "o_proj",
                    "gate_proj", "up_proj", "down_proj"],
)
model = get_peft_model(model, lora)
model.print_trainable_parameters()      # 可训练参数约占 0.5%

args = TrainingArguments(
    output_dir="./output/qwen-lora-ft",
    per_device_train_batch_size=1, gradient_accumulation_steps=8,
    num_train_epochs=3, learning_rate=2e-4, logging_steps=10,
    fp16=True, save_strategy="epoch", report_to=[],
)
trainer = Trainer(
    model=model, args=args, train_dataset=ds,
    data_collator=DataCollatorForLanguageModeling(tokenizer, mlm=False),
)
trainer.train()
trainer.save_model("./output/qwen-lora-ft")   # 只存适配器,几十 MB
跑完 output/qwen-lora-ft/ 里只有适配器权重;要做验证或部署,先用 llamafactory-cli export(4.3 节)或 peft 的 merge_and_unload() 把它合回基座——下面盲测里用的 ./output/qwen-lora-ft-merged 就是这个合并产物。
11.3.4 实战验证:从"跑分"到"盲测"
数据搞定,跑起来。但训练完就万事大吉了吗?你需要回答一个更硬的问题——它到底变好了没有?
很多团队的验证方式是一条龙:Loss 曲线下降了 → BLEU/ROUGE 分数涨了 → "嗯,效果不错"。这种方式最多只能叫跑分,它不能回答最关键的问题:在实际业务场景里,微调后的模型到底比微调前强在哪里?
一个更硬核的做法是:构建双盲对比 + 关键路径回测。
第一层:模型即裁判(LLM-as-Judge)。 用另一个大模型作为裁判,对比微调前后的输出质量。这不是业界新鲜事——Google 提出的 G-Eval 评测体系就是类似思路(需要说明的是:G-Eval 是一个评测框架而非特定模型,其原始论文中同样使用 GPT-4 作为评测模型):
代码仅演示逻辑,非生产实现。
python
# eval_head_to_head.py — 双盲对比评测
import json
import random
import openai

def compare_models(base_answer: str, finetuned_answer: str, question: str,
                   criteria: list[str]) -> dict:
    """让裁判模型盲评两个答案(不告知哪个是微调后的)"""
    # 构建答案对,记录标签(随机打乱顺序以避免位置偏差)
    items = [("A", base_answer), ("B", finetuned_answer)]
    random.shuffle(items)
    label_map = {label: "finetuned" if answer == finetuned_answer else "base"
                 for label, answer in items}

    prompt = f"""你是一个医疗器械维保领域的资深工程师。

请对比以下两个答案,回答同一个问题:

问题:{question}

答案A:{items[0][1]}

答案B:{items[1][1]}

请从以下维度逐个评分(每个维度 1-5 分):
{chr(10).join(f"{i+1}. {c}" for i, c in enumerate(criteria))}

输出JSON格式,每个维度包含A和B的分数及简要理由。"""

    response = openai.chat.completions.create(
        model="gpt-4o",
        messages=[{"role": "user", "content": prompt}],
        response_format={"type": "json_object"}
    )
    result = json.loads(response.choices[0].message.content)

    # 按各维度均分判定胜者
    score_a, score_b = 0, 0
    for dim_scores in result.values():
        if isinstance(dim_scores, dict) and "A" in dim_scores and "B" in dim_scores:
            score_a += dim_scores["A"]
            score_b += dim_scores["B"]
    winner = label_map["A"] if score_a > score_b else label_map["B"]
    return result, winner
跑完 100 道盲测题,你就能得到一张对比表:
| 评测维度 | 微调前均分 | 微调后均分 | 提升 |
|---|---|---|---|
| 术语准确性 | 2.8 | 4.5 | +60.7% |
| 信息完整性 | 3.1 | 4.2 | +35.5% |
| 简洁度 | 4.0 | 3.8 | -5.0% |
| 专业语气 | 2.3 | 4.7 | +104.3% |
| 综合分 | 3.05 | 4.30 | +40.9% |
注意"专业语气"这一项增速最猛——这正是微调的核心价值:不是教模型更多知识(知识底座已在预训练中),而是调整它的说话方式。
第二层:关键路径回测。 对于医疗器械维保这种直接关系诊断结果的领域,光看平均分不够。你需要针对业务中最关键的路径做专项测试——比如"环形伪影成因判别的召回率":
代码仅演示逻辑,非生产实现。
python
# critical_path_backtest.py — 关键路径回测
test_cases = [
    {
        "question": "图像出现环形伪影,做完空气校准仍然存在,我该按什么顺序排查?",
        "expected_entities": ["探测器通道", "空气校准", "球管", "探测模块"],
        "required_condition": "空气校准后伪影仍存在"
    },
    # ... 更多关键用例
]

# 两个待对比的模型:基座 vs 微调后(以 Qwen2.5-0.5B 为例,fp16 约 1GB 显存)
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

base_tok = AutoTokenizer.from_pretrained("Qwen/Qwen2.5-0.5B-Instruct")
base_model = AutoModelForCausalLM.from_pretrained("Qwen/Qwen2.5-0.5B-Instruct", device_map="auto")
ft_tok = AutoTokenizer.from_pretrained("./output/qwen-lora-ft-merged")
ft_model = AutoModelForCausalLM.from_pretrained("./output/qwen-lora-ft-merged", device_map="auto")


def ask(model, tokenizer, question: str, max_new_tokens: int = 256) -> str:
    """最小推理封装:套对话模板 → 生成 → 只取新生成的部分"""
    msgs = [{"role": "user", "content": question}]
    prompt = tokenizer.apply_chat_template(msgs, tokenize=False, add_generation_prompt=True)
    inputs = tokenizer(prompt, return_tensors="pt").to(model.device)
    with torch.no_grad():
        out = model.generate(**inputs, max_new_tokens=max_new_tokens, do_sample=False)
    return tokenizer.decode(out[0][inputs["input_ids"].shape[1]:], skip_special_tokens=True)


def measure_recall(response: str, expected: dict) -> bool:
    """检查微调后的回答是否覆盖了所有必要实体"""
    return all(entity in response for entity in expected["expected_entities"])

# 分别跑微调前后的模型
base_recalls = [measure_recall(ask(base_model, base_tok, tc["question"]), tc) for tc in test_cases]
ft_recalls = [measure_recall(ask(ft_model, ft_tok, tc["question"]), tc) for tc in test_cases]

print(f"微调前关键实体召回率: {sum(base_recalls)/len(base_recalls)*100:.1f}%")
print(f"微调后关键实体召回率: {sum(ft_recalls)/len(ft_recalls)*100:.1f}%")
# 输出示例:
# 微调前关键实体召回率: 34.0%
# 微调后关键实体召回率: 88.0%
从 34% 到 88%——这个差距才是一线工程师真正关心的。"Loss 降了 0.2"不好解释,但"关键成因的召回率从三成提升到九成",任何人都能秒懂。
微调不是炼丹。当你把数据采集、清洗、分布和验证这四步走扎实,微调就从一个"玄学调参"问题,变成了一个数据工程问题——可控、可解释、可复现。
回顾本节的核心原则:
- 数据采集不怕量少,怕的是"翻译腔"。把领域知识注入到生成提示词中,用裁判模型双保险。
- 数据清洗的关键不是去重,是贴标签。难度、领域、来源——这些元数据在训练策略中的价值远超想象。
- 数据分布要做语义级划分。同题异问的变体分散到不同数据集,才是真正在测"理解"而非"背诵"。
- 验证体系不能只跑分。关键路径回测 + 双盲裁判,才能让你回答那句直击要害的问题:"它到底变好了没?"
下一节,我们将跳出单模型优化的范畴,探讨一个更宏大的话题:如何构建一个大模型知识图谱——让多个模型和外部知识协同工作。
11.4 如何构建大模型知识图谱
上一节我们完成了从数据收集到微调部署的全链路——让模型在专业数据上学会说你的行话。但还有一个更根本的问题:模型在回答问题时查到的知识,是不是对的? 如果模型检索到的上下文本身就是错的,那么即使它再懂行话,给出的答案也只能是用专业术语包装的胡说八道。
以下通过变电站故障处置这个具体案例来展开讨论。我们先从读者最容易产生的疑问入手——
看到这里,很多读者可能会有这样的想法:"现在 Dify 和 RagFlow 这么火,拖拽一下就能出结果,你为什么要费劲手搓知识图谱?"
我的回答很简单:如果你只是想做一个通用聊天机器人,去用 Dify,它很快。但是,如果你面对的是专业领域——电力的继电保护、化工的工艺规程、设备操作手册里的缩略语——你很快会发现,那些拖拽出来的东西回答起来像模像样,但关键细节全错。它看起来懂了,实际上只是把几个高相似度的文档片段拼接在一起,凑了一个"听起来合理"的答案。
本案例不是在教你造轮子。本案例是在教你拆解轮子的结构,从而在工具失效时——当大模型开始一本正经地胡说八道——你有能力亲自修好它。
下面这张是我画的 RAG 系统构建全景图,左边是离线索引,中间是数据存储,右边是在线检索。本节后面的五个步骤,就是沿着这张图一步步走下来的。
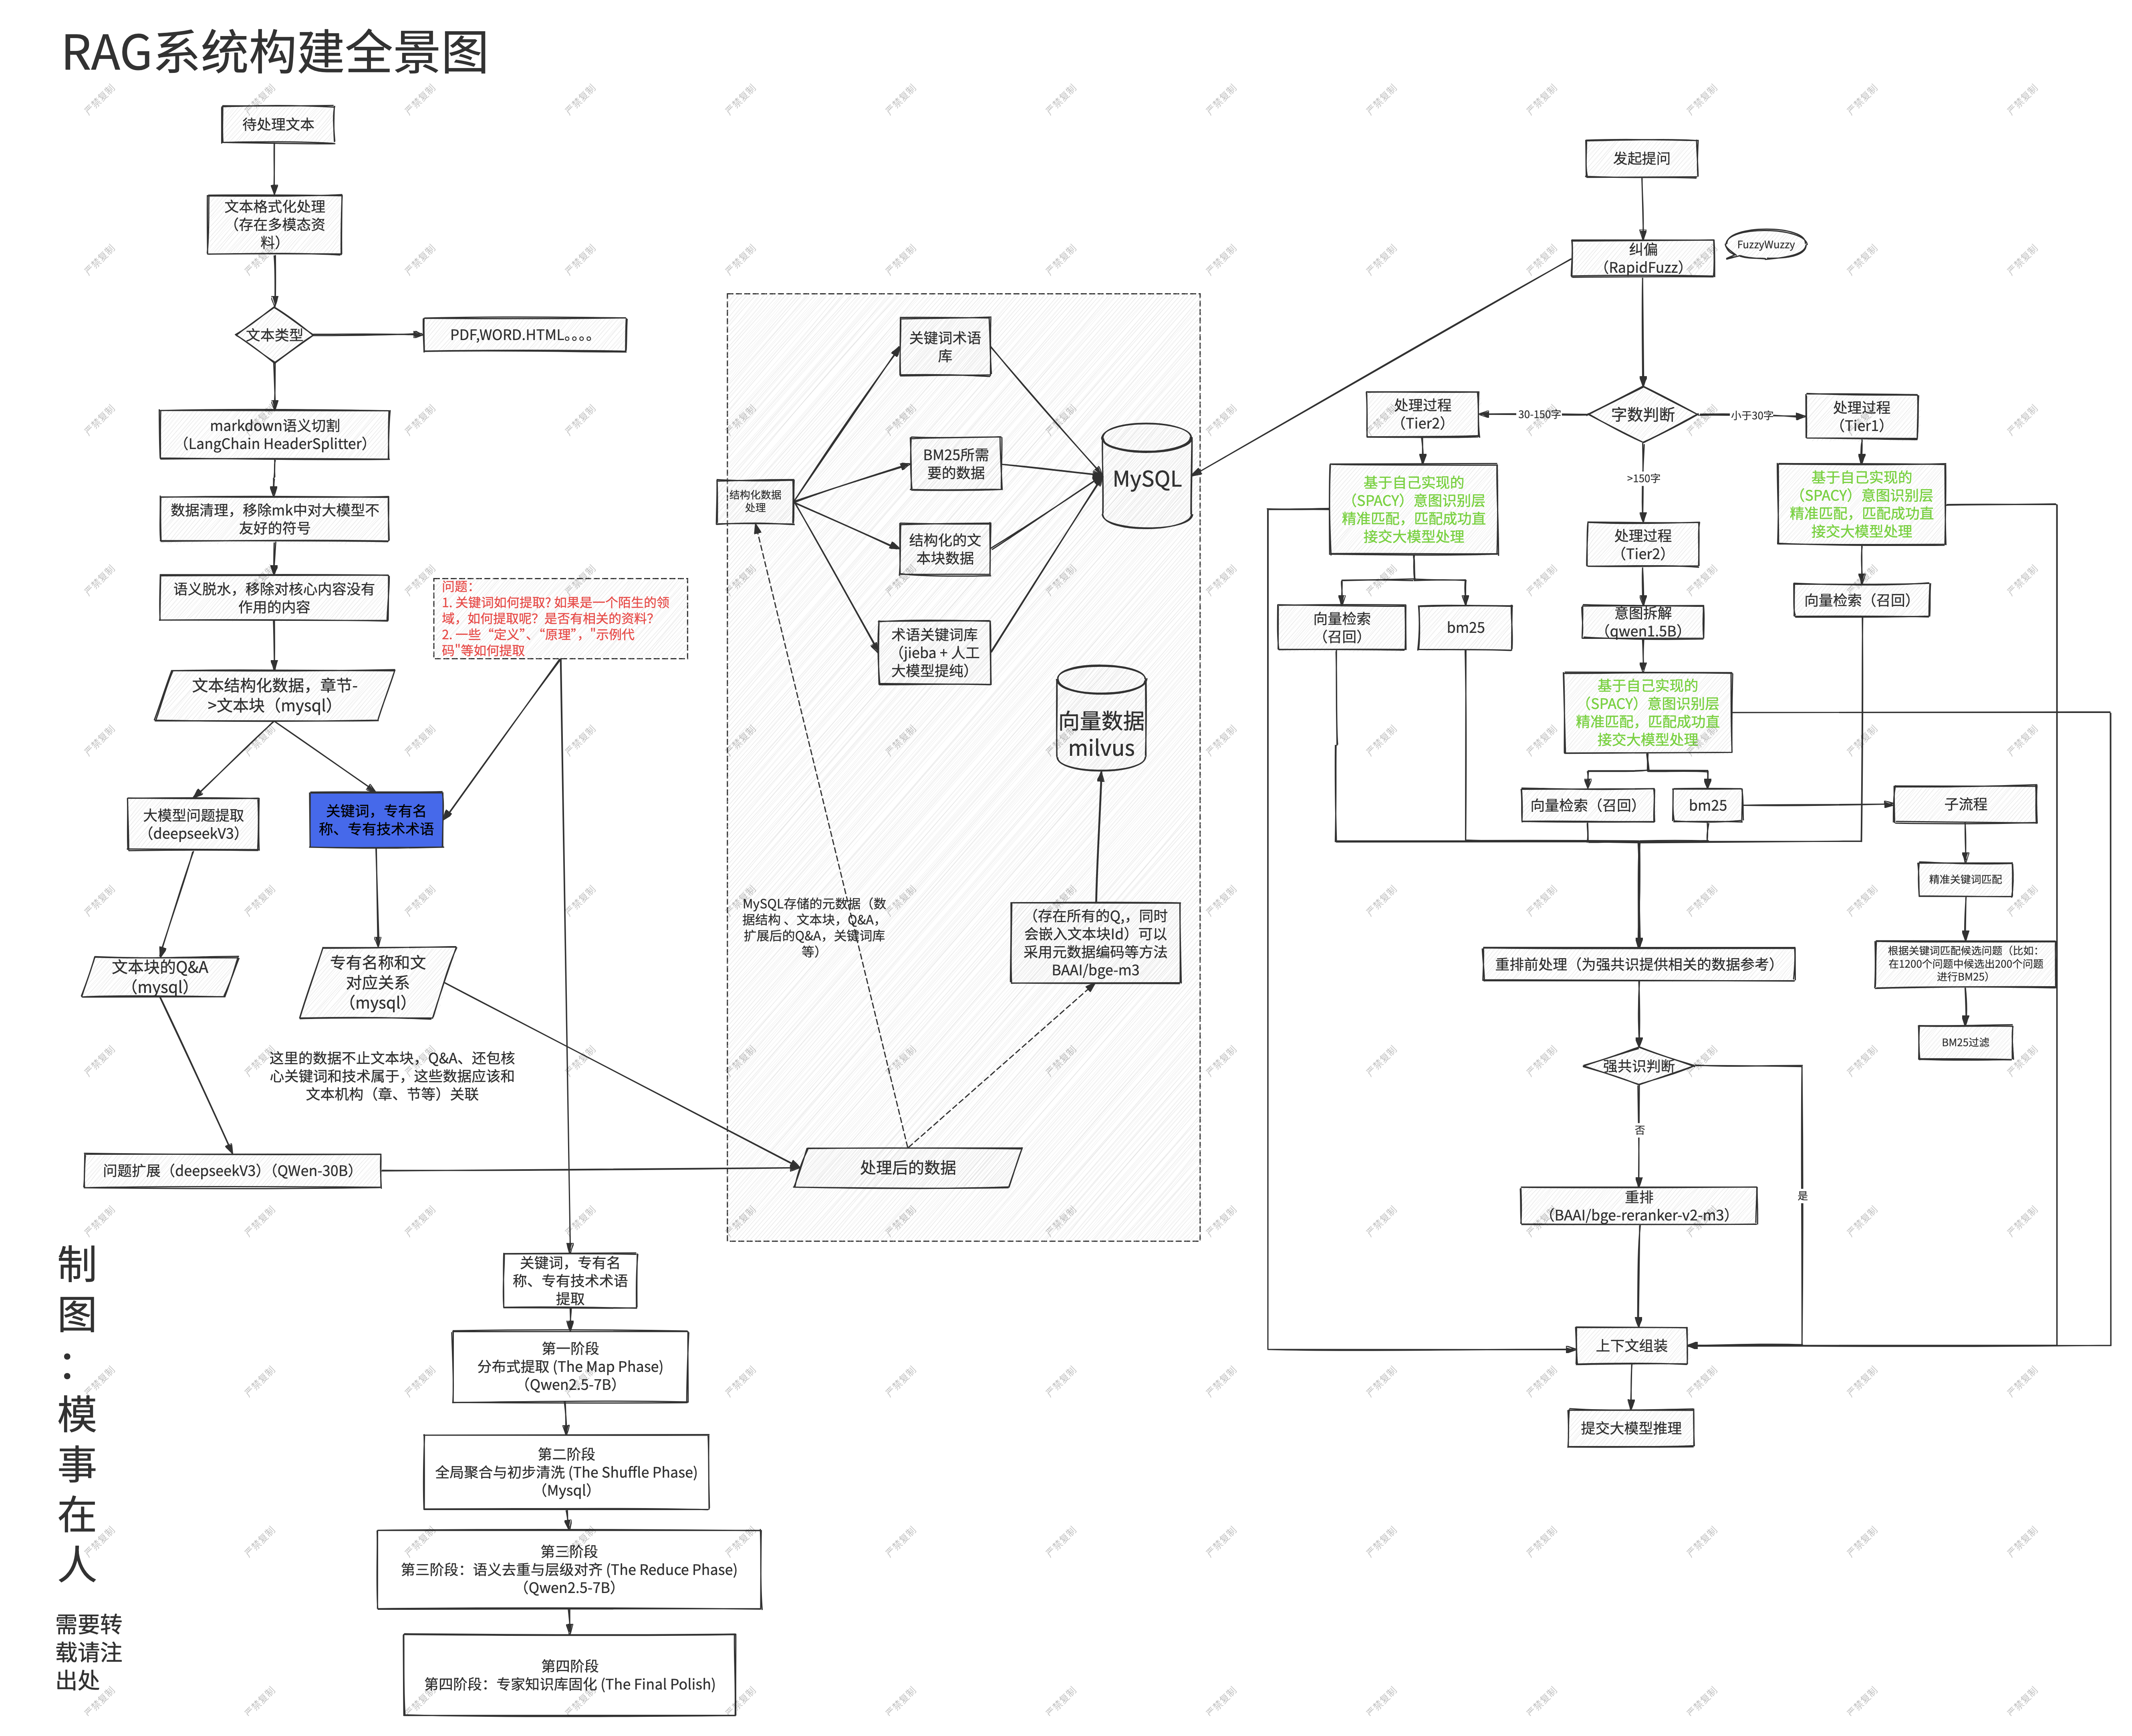
图 11-1:RAG 系统构建全景(离线索引 / 数据存储 / 在线检索)
11.4.1 被拖拽工具"喂懒"的一代
坦白说,现在的开发者正在被 Dify 和 RagFlow 这种"拖拽式 RAG 工具"给喂懒了。大家都觉得 RAG 就是三步走:买个向量数据库、调个 Embedding 接口、选个切片策略,然后就等着看结果。这个流程没问题——如果你是做个内部问答机器人,对准确率要求 80% 就够用的话。
但一旦进入专业领域,问题就暴露了。向量检索本质上是在做"语义相似度匹配",它能找到"说得最像"的文档片段,但找不到"逻辑上最相关"的信息。举个例子:
- 用户问:"主变跳闸之后,站用电会怎样?"
- 向量检索可能返回一段讲"主变正常运行方式"的文档——语义确实很像,但关键信息"跳闸后由谁转供"藏在另一段讲"事故处理规程"的文档里,两段文档在语义空间里距离很远。
- 结果:模型拿到的上下文是"主变正常运行时是这样的",然后它自己"推理"出一套处置方案——全是编的。
这不是大模型的错。大模型是联想引擎,不是数据库。你喂给它碎片,它就用碎片拼答案;你喂给它结构,它就能按结构推理。
这就是知识图谱存在的根本原因——它解决的不是"找得准不准",而是"找到的东西对不对"。向量检索能在语义空间里匹配最相似的段落,但它不知道哪些段落之间存在因果逻辑。知识图谱要填补的,正是这个缺口。
11.4.2 知识图谱的核心价值:骨架化
知识图谱不是什么新技术。从 Google 的 Knowledge Graph 到金融领域的知识引擎,图谱的核心思想只有一个:把知识从"文档"变成"关系"。
在 RAG 场景下,传统向量检索和知识图谱的差异可以用一个比喻来理解:
- 向量检索像图书馆的索引卡片。 你问一个问题,它帮你找到最相关的几本书或几页纸,然后把这些纸张一股脑塞给大模型,让模型自己翻。
- 知识图谱像一个领域专家的思维导图。 它把行业知识预先拆解为实体(设备部件、保护信号、操作流程)和它们之间的关系(属于、导致、触发、依赖),然后在回答问题时,沿着关系链精准检索需要的信息。
后者能解决向量检索的致命弱点:跨文档推理。当一个问题需要综合多段文档中的信息才能回答时,向量检索只能赌"这些文档恰好都被召回",而知识图谱可以顺着实体关系链直接抓取上下游信息。
回到那个主变跳闸的例子。如果你的知识图谱里有这样的结构:
[主变差动保护动作] --触发--> [事故处理规程 SOP-3.2]
[事故处理规程 SOP-3.2] --涉及--> [站用电运行状态]
[站用电运行状态] --依赖--> [备自投装置 BZT]
[备自投装置 BZT] --提供--> [有限转供能力]
那么大模型拿到的不再是几个零散的文档片段,而是一条完整的因果链。它不需要"猜",它可以沿着这条链讲述一个准确的推理过程。
这就是作者的真实感悟:知识图谱的终极目标,是行业知识的"炼油厂"与"输油管"。把原始的行业文档(原油)提炼为结构化的知识骨架(成品油),然后通过管道精准输送到大模型的上下文窗口。
11.4.3 四层架构:知识在大模型中的最佳流动路径
基于上面的理念,本书提出一个 《基于 MCP(Model Context Protocol,模型上下文协议)的通用知识中枢架构》。知识中枢(Knowledge Hub)是本书提出的架构概念:以知识图谱为核心、通过 MCP 协议暴露标准化接口的知识服务平台——它不是全文档统一术语,而是本节的专属架构命名。这个架构分为四层:
底层:原始知识源。 你的技术手册、SOP 文档、故障数据库、设备操作手册——所有未经处理的"比特流"。这一层的存在提醒我们:知识图谱不是凭空造的,它必须扎根于真实的行业数据。
中层(核心层):知识图谱 + 逻辑映射表。 这是你"手搓"的部分,也是整个架构的引擎。在这个层里,你要做三件事:
实体抽取。 从原始文档中识别出关键实体——设备型号、部件编号、故障代码、操作程序、状态参数、阈值条件。这不是简单地做 NER(命名实体识别),而是要定义你所在领域"什么东西值得成为一个实体"。
关系建模。 这是比实体抽取更关键的一步。实体之间的连接方式决定了图谱的推理能力。典型的工业级关系类型包括:
- 因果关系:X 触发 Y
- 层级关系:X 属于 Y
- 依赖关系:X 依赖 Y 才能工作
- 时序关系:X 发生在 Y 之前
- 条件关系:X 仅在 Y 条件满足时才生效
逻辑映射表的构建。 这是非常容易被忽略、但又极其关键的一层。现实世界的知识不是完美的图结构——很多关系是隐式的、条件性的。你需要一张映射表来记录:
- 用户问题的意图类型(故障排查 / 操作指导 / 原理讲解 / 数据查询)
- 每种意图对应的知识检索路径
- 检索到实体的置信度与替代方案
(具体示例见 11.4.5 第四步中的意图映射表。)
市面上有很多像 Neo4j 或 LangGraph 这样的优秀框架。但在本架构里,它们仅被视为**"持久化插件"或"局部算子"**。你更关注的是如何将行业知识"骨架化"——因为只要骨架对,喂给什么框架都能跑通。
协议层:MCP Server。 将知识图谱的能力 API 化。你在知识图谱上定义的所有查询——按保护动作信号查处置流程、按部件查上下游依赖、按操作程序查前置条件——全部封装为 MCP Tools。这样,任何支持 MCP 协议的应用(Claude Code、OpenClaw、自研 Agent)都可以直接调用图谱,而不需要关心底层用的是 Neo4j 还是你自己写的图引擎。MCP 封装还有一个额外好处:你避免与 Dify 和 RagFlow 竞争。你不是在做一个"更好的 RAG 工具",而是在做一个"可以被任何 RAG 工具调用的知识层"——Dify 能解决的事你不管,Dify 解决不了的事你兜底。
顶层(应用层):Dify / RagFlow / Claude Code / 自研 Agent。 这一层不需要你做太多事。你的 MCP Server 露出的接口是标准的,任何一个应用平台只要对接了 MCP 协议,就能消费你的知识图谱。你提供的是知识的"水电煤",而不是一个封闭的应用。
图 11-2:基于 MCP 的通用知识中枢架构
11.4.4 三大架构级痛点:为什么框架不够
了解了架构之后,我们需要回到那个核心问题:为什么不能直接用现成框架? 因为框架解决的是通用问题,而专业领域有它自己的"架构级痛点"。
痛点一:领域知识无法通过通用 Embedding 捕捉。 通用 Embedding 模型是在维基百科、新闻、论坛上训练的。它对"巴黎是法国的首都"理解得很好,但对"备自投(BZT)在主变失电后自动投入转供"这种专业陈述——Embedding 向量根本分不清这句话和「设备保养流程」的区别。因为在通用语义空间里,两者都包含"自动投入""备用"这类词。你需要自己定义检索逻辑——不是靠相似度,而是靠关系链。
痛点二:框架把"工具"和"知识"混在一起了。 即使 Embedding 能捕捉到通用语义,框架的设计理念本身也是面向简单场景的。Dify 的流程是:你给它文档,它给你一个能对话的助手。这个思路对简单场景有效,但对复杂场景失效。为什么?因为 Dify 的流程是"文档→向量→检索→生成",而专业场景需要的是"文档→知识→推理→生成"。中间的"知识化"步骤被跳过了。框架不会帮你做实体识别、关系建模、意图分类——它假设你的文档本身已经包含了"答案"。但现实是,很多专业问题的答案不在任何一篇文档里,它分散在十篇文档里,需要推理才能得出。
痛点三:工具失效时你无能为力。 即使流程对了、Embedding 也选对了,当 Dify 搭出来的助手回答不了某个问题时,你能做什么?调整切片策略?换个 Embedding 模型?加几条 Prompt?这些都只是"外围打磨"。真正的问题在于你的知识没有被结构化——你甚至不知道系统是"没检索到"还是"检索到了但推理错了"。而在你手搓的知识图谱里,你可以精确追踪每一步检索路径:实体识别→关系链遍历→意图匹配→最终生成。哪一步出了问题,你定位得到,也修得了。
11.4.5 手搓知识图谱的实践路线
那么,具体怎么动手?以下是本书推荐的一条实践路线,它不需要你成为图谱专家,但能让你在一周之内搭建出自己的知识中枢。
三步理论与五步落地的对照关系: 11.4.3 核心层提出的「实体抽取 + 关系建模 + 逻辑映射表构建」是理论框架——告诉你"要做好哪三件事"。而下面的五步路线是落地路径——告诉你"具体分哪五步做"。三步与五步一一对应:实体抽取 → 第一步(审计)+ 第二步(建模),关系建模 → 第三步,逻辑映射表 → 第四步,第五步(MCP 封装)则是把前三步的成果打包成可用的产品。
第一步:知识审计——弄清楚你有哪些知识。 把你所在领域的核心文档整理出来。不是随便收集一堆 PDF,而是带着分类意识去梳理:
- 哪些是"事实型知识"?(部件参数、保护定值含义、行业术语)
- 哪些是"关系型知识"?(操作流程、因果链条、依赖关系)
- 哪些是"经验型知识"?(最佳实践、常见陷阱、未成文的约定)
这步不需要写代码。拿一个白板,画出知识的大致边界,标注核心实体。
第二步:实体建模——定义你的"名词表"。 从第一步的知识审计中,提炼出你的实体清单。每个实体需要至少三个字段:
- 名称(唯一标识)
- 类型(部件 / 程序 / 故障 / 状态 / 参数)
- 属性(描述、关键词、所属系统)
以变电站场景为例:
代码仅演示逻辑,非生产实现。
json
{
  "entities": [
    {
      "id": "BZT",
      "type": "部件",
      "name": "备自投装置",
      "abbr": "BZT",
      "system": "站用电系统",
      "keywords": ["BZT", "备自投", "备用电源自动投入"]
    },
    {
      "id": "TR_DIFF_TRIP",
      "type": "故障",
      "name": "主变差动保护动作",
      "abbr": "87T",
      "system": "继电保护",
      "keywords": ["差动动作", "主变跳闸", "87T"]
    },
    {
      "id": "SOP_3_2",
      "type": "程序",
      "name": "主变跳闸事故处理规程",
      "system": "事故处置",
      "source_doc": "SOP-3.2",
      "keywords": ["SOP-3.2", "主变跳闸事故处理规程"]
    },
    {
      "id": "Limited_Transfer_Capacity",
      "type": "状态",
      "name": "有限转供能力",
      "system": "站用电系统",
      "keywords": ["有限转供能力", "转供容量受限", "备自投转供"]
    }
  ]
}
第三步:关系建模——定义你的"动词表"。 实体之间怎么连接?你需要定义关系类型和方向。下面是变电站场景中的几条核心关系:
代码仅演示逻辑,非生产实现。
json
{
  "relations": [
    {
      "from": "TR_DIFF_TRIP",
      "to": "SOP_3_2",
      "type": "触发",
      "condition": "确认差动保护动作、主变两侧开关均在分位",
      "confidence": "high"
    },
    {
      "from": "SOP_3_2",
      "to": "BZT",
      "type": "涉及",
      "step": "步骤3:确认备自投动作,监视Ⅰ段母线电压",
      "confidence": "high"
    },
    {
      "from": "BZT",
      "to": "Limited_Transfer_Capacity",
      "type": "提供",
      "note": "备自投动作后由 2# 主变转供,容量约 60%,需按限电序位表切除部分负荷",
      "confidence": "high"
    }
  ]
}
注意每个关系都带了一个 confidence 字段。不是所有关系都是确定的——有些关系可能是"通常触发""偶尔引发""在特定条件下成立"。在工业场景中,这个置信度标记至关重要,因为它告诉系统:这条关系链是否足够可靠,可以用于推理。
第四步:构建意图识别与检索路径映射。 有了实体和关系,你需要定义"用户问了什么→知识图谱怎么查"。这个映射表(Logic Mapping Table)是你的知识图谱与用户之间的翻译层:
代码仅演示逻辑,非生产实现。
json
{
  "intent_mappings": [
    {
      "intent": "故障排查",
      "question_patterns": ["怎么办", "跳闸", "动作", "告警", "异常"],
      "graph_query": "entity_by_keyword → relations(type='触发') → target_entity → relations(type='涉及') → operation_steps",
      "response_template": "先说明原因(因果链首尾),再给出步骤(关系链上的操作实体),最后补充注意事项"
    },
    {
      "intent": "原理讲解",
      "question_patterns": ["原理", "为什么", "工作机制", "如何工作"],
      "graph_query": "entity_by_keyword → attributes → relations(type='依赖'|'组成') → upstream/downstream entities",
      "response_template": "从宏观到微观:先讲系统在整体中的位置,再讲内部工作机制"
    },
    {
      "intent": "数据查询",
      "question_patterns": ["参数", "数值", "多少", "限值", "定值", "电流"],
      "graph_query": "entity_by_keyword → attributes → numerical_params",
      "response_template": "直接给出数值,附带正常范围和限制条件"
    }
  ]
}
这段 JSON 在说什么?翻译一下:当用户问的是故障排查类问题(带"怎么办""跳闸"等词),系统先从关键词定位实体,再沿着"触发"关系链找到目标实体,最后顺着"涉及"关系拉出操作步骤——一条因果链从头走到尾,而不是随机拼几个文档片段。同理,原理讲解走的是"依赖/组成"关系链,数据查询直接取实体属性中的数值参数。三种意图,三条路径,逻辑清晰。
第五步:封装为 MCP Server。 当你有了实体库、关系库和意图映射表,剩下的就是把它们打包为一个 MCP Server。MCP Server 的本质很简单:它是一个本地服务,暴露一组 Tool,外部应用通过标准协议调用。你的知识图谱 MCP Server 至少需要暴露以下 Tool:
search_entity(keyword)— 按关键词查实体get_relations(entity_id)— 获取指定实体的所有关系traverse_path(start_entity, end_entity)— 查找两个实体之间的最短关系路径query_by_intent(question)— 端到端查询:自动识别意图 → 执行图谱查询 → 返回结构化结果get_entity_context(entity_id)— 获取实体的完整上下文(属性 + 上下游关系 + 关联文档片段)
如果你暂时不想看代码,可以跳过这个代码块,直接读代码后的流程说明和"用户提问→查询→生成"三步调用链,不影响理解。
以下为完整实现骨架。代码展示了知识图谱如何通过 MCP 协议暴露为可调用的 Tool,完整的 MCP Server 搭建流程请参考第 11.5 节:
代码仅演示逻辑,非生产实现。
python
# kg_mcp_server.py — 知识图谱 MCP Server 骨架
# 依赖: pip install fastmcp
# 本示例展示核心逻辑,完整的 MCP Server 搭建细节参见第 11.5 节

import json

from fastmcp import FastMCP

# === 第 1 层: 知识库(简化示意,实际应从数据库加载) ===
# 本实现将四层架构的"底层(原始知识源)"数据直接内嵌在 KG dict 中,
# 目的是让读者在一个文件内看清全貌。实际部署时应从数据库或文件加载。
KG = {
    "entities": {
        "TR_DIFF_TRIP": {
            "id": "TR_DIFF_TRIP",
            "type": "故障",
            "name": "主变差动保护动作",
            "system": "继电保护",
            "attributes": {
                "判定标准": "差动保护动作且主变两侧开关跳闸",
                "严重等级": "紧急"
            }
        },
        "BZT": {
            "id": "BZT",
            "type": "部件",
            "name": "备自投装置",
            "system": "站用电系统",
            "attributes": {
                "投入条件": "主变失电后自动投入",
                "动作时限": "1.5 s 内",
                "备用电源": "2# 主变",
                "转供容量": "约 60% 额定负荷"
            }
        },
        "SOP_3_2": {
            "id": "SOP_3_2",
            "type": "程序",
            "name": "主变跳闸事故处理规程",
            "system": "事故处置",
            "attributes": {
                "来源": "运行规程 SOP-3.2",
                "适用站所": ["110 kV 城东变", "110 kV 城西变"],
                "步骤数": "7 步"
            }
        },
        "Limited_Transfer_Capacity": {
            "id": "Limited_Transfer_Capacity",
            "type": "状态",
            "name": "有限转供能力",
            "system": "站用电系统",
            "attributes": {
                "来源": "备自投转供",
                "持续时间": "至备用电源带满负荷",
                "限制条件": "按限电序位表切除部分负荷",
                "影响负荷": ["Ⅰ段母线非重要负荷", "办公与照明负荷"]
            }
        }
    },
    "relations": [
        {"from": "TR_DIFF_TRIP", "to": "SOP_3_2", "type": "触发", "confidence": "high"},
        {"from": "TR_DIFF_TRIP", "to": "BZT", "type": "触发", "confidence": "high"},
        {"from": "SOP_3_2", "to": "BZT", "type": "涉及"},
        {"from": "BZT", "to": "Limited_Transfer_Capacity", "type": "提供", "confidence": "high"}
    ]
}

# === 第 2 层: 图谱查询引擎 ===
def search_entity(keyword: str) -> list:
    """按关键词搜实体,返回匹配的实体列表"""
    results = []
    for eid, entity in KG["entities"].items():
        # 搜名称、缩略语、系统名
        searchable = f"{entity['name']} {entity.get('system', '')} {eid}"
        if keyword.lower() in searchable.lower():
            results.append(entity)
    return results


def get_relations(entity_id: str) -> list:
    """获取实体的所有上下游关系"""
    related = []
    for rel in KG["relations"]:
        if rel["from"] == entity_id or rel["to"] == entity_id:
            related.append(rel)
    return related


def traverse_causal_chain(entity_id: str, relation_type: str = "触发") -> list:
    """沿关系链遍历,返回因果链条"""
    chain = [entity_id]
    current = entity_id
    visited = set()

    while current not in visited:
        visited.add(current)
        # 找从当前实体出发的特定类型关系
        next_rel = [
            r for r in KG["relations"]
            if r["from"] == current and r["type"] == relation_type
        ]
        if next_rel:
            current = next_rel[0]["to"]
            chain.append(current)
        else:
            break

    return chain


def query_by_question(question: str) -> dict:
    """
    简化版的端到端查询:
    1. 从问题中提取关键词
    2. 匹配实体
    3. 拉取关系链
    4. 组装上下文

    说明:实际应用中应接入专门的意图识别层,此处仅做最简单的关键词匹配示意。
    """
    # 中文问句没有空格,split() 切不出词;改为「实体名是否出现在问句中」,
    # 并按名称长度降序,避免「主变」先命中而漏掉「主变差动保护」
    candidates = sorted(KG["entities"].values(), key=lambda e: len(e["name"]), reverse=True)
    matched_entities = []
    for entity in candidates:
        if entity["name"] in question:
            matched_entities.append(entity)

    if not matched_entities:
        return {"answer": "未找到相关实体", "entities_found": []}

    # 去重
    seen = set()
    unique_entities = []
    for e in matched_entities:
        if e["id"] not in seen:
            seen.add(e["id"])
            unique_entities.append(e)

    # 获取核心实体的关系链
    main_entity = unique_entities[0]
    relations = get_relations(main_entity["id"])

    # 构建上下文
    context_parts = [f"实体: {main_entity['name']}({main_entity['type']})"]

    if main_entity.get("attributes"):
        for key, value in main_entity["attributes"].items():
            context_parts.append(f"- {key}: {value}")

    if relations:
        context_parts.append("\n关联信息:")
        for rel in relations:
            other_id = rel["to"] if rel["from"] == main_entity["id"] else rel["from"]
            other = KG["entities"].get(other_id, {})
            other_name = other.get("name", other_id)
            context_parts.append(f"- {rel['type']} → {other_name}")

    return {
        "answer": "已检索到相关实体和关系",
        "main_entity": main_entity["name"],
        "context": "\n".join(context_parts),
        "entities_found": [e["name"] for e in unique_entities],
        "relations_count": len(relations)
    }


# === 第 3 层: MCP Server 封装 ===
app = FastMCP("kg-server")


@app.tool()
async def search_entity_tool(keyword: str) -> str:
    """按关键词搜索知识图谱中的实体"""
    results = search_entity(keyword)
    return json.dumps(results, ensure_ascii=False, indent=2)


@app.tool()
async def get_relations_tool(entity_id: str) -> str:
    """获取指定实体的所有关系"""
    results = get_relations(entity_id)
    return json.dumps(results, ensure_ascii=False, indent=2)


@app.tool()
async def query_knowledge(question: str) -> str:
    """端到端知识查询:根据自然语言问题检索知识图谱"""
    result = query_by_question(question)
    return json.dumps(result, ensure_ascii=False, indent=2)


@app.tool()
async def traverse_causal_chain_tool(entity_id: str) -> str:
    """沿触发/因果链遍历"""
    chain = traverse_causal_chain(entity_id)
    chain_detail = []
    for eid in chain:
        entity = KG["entities"].get(eid, {})
        chain_detail.append(f"{entity.get('name', eid)} ({entity.get('type', '未知')})")
    return " → ".join(chain_detail)


if __name__ == "__main__":
    # 默认 stdio 传输;要用 HTTP 改成 app.run(transport="streamable-http", host="0.0.0.0", port=8080)
app.run()运行说明:以上代码依赖第三方包
fastmcp(pip install fastmcp)。完整的 MCP Server 配置和客户端接入方法请参考第 11.5 节"手搓一个完整的 MCP 体系"。本示例的目的是展示知识图谱如何通过 MCP 协议暴露为可调用的 Tool,而不是完整复现 MCP Server 的搭建流程。
在实际部署中,你会把这个 Server 注册到你的 MCP 配置文件里(比如 Claude Code 的 mcp.json 或 OpenClaw 的 registry 中),然后大模型在回答用户问题时会自动调用 query_knowledge 或 search_entity_tool 先获取结构化知识,再基于这些知识生成回答。整个流程是:
用户提问
    → 大模型决定调用 [query_knowledge] tool
    → MCP Server 执行图谱查询,返回结构化上下文
    → 大模型基于上下文生成回答(不再靠"猜")
11.4.6 知识图谱与大模型的关系:协作,不是替代
最后要澄清一个重要认知:知识图谱不是用来"替代"大模型的。很多工程师第一次接触知识图谱时会想——"我把知识都结构化存图里了,直接用规则引擎查不就行了,还要大模型干嘛?"
这是走向了另一个极端。知识图谱提供的是准确的知识上下文,大模型提供的是自然的语言理解和生成能力。两者组合在一起才是完整的解决方案:
- 图谱负责"知道什么是对的"——它保证检索到的信息是准确的、可追溯的、有逻辑关系的。
- 大模型负责"说出一个能让人听懂的回答"——它把结构化的知识转化为流畅的自然语言,处理用户的歧义表述,补全语境。
把知识图谱做成 MCP Server 还有一个深层价值:它让你成为一个"知识服务提供商",而不是一个"工具的使用者"。你的知识图谱可以被 Dify 调用,可以被 Claude Code 调用,可以被任何支持 MCP 协议的 Agent 调用。你不是在跟工具竞争,而是在给工具提供它们最缺的东西——足够的、准确的专业知识。
"不要在工具的迷宫里寻找答案。Neo4j 不会告诉你设备为什么会出故障,LangGraph 也不会把值班员一句「2 号主变跳了」翻译成结构化的故障描述。我们要做的不是'学习框架',而是'定义知识'。当你的知识图谱具备了严密的逻辑,任何框架都只是它的搬运工。"
知识图谱虽然不是万能的钥匙,但是它解决了向量 RAG 中最棘手的两个问题:跨文档推理和知识溯源性。当你在专业领域中面对复杂问题,向量检索的"相似度匹配"已经不够用了——你需要的是结构化的知识骨架。
构建知识图谱不需要你成为图谱专家。遵循"知识审计 → 实体建模 → 关系建模 → 意图映射 → MCP 封装"的五步路线,你可以在一周之内造出自己的知识中枢。而且通过 MCP 协议,这个知识中枢不是你一个人的工具——它可以成为整个团队、整个工具链共享的知识基础设施。
下一节,我们将深入 MCP 协议的具体实现——不只是调用别人写好的 MCP Server,而是手搓一个完整的 MCP 体系。有了本节的知识图谱作为"内容",再加上下节的 MCP 作为"管道",你将拥有构建专业级大模型应用的完整能力栈。
11.5 手搓一个完整的MCP体系
神经触达 (IO)
"为什么要手搓 MCP?因为真正的价值从不开源。"
很多人会问:"GitHub 上已经有成千上万个 MCP Server 了,我直接调用不香吗?为什么还要费劲自己开发?"
这是一个好问题,但它暗含了一个假设:你需要的工具正好有人已经写好、维护良好、并且恰好覆盖了你的业务场景。现实往往不是这样。你所在行业的私有 API、你那套特殊的数据格式、你用了五年的内部系统——这些东西不会有现成的 MCP Server。即便有,把核心业务逻辑交到一个你完全不了解内部机制的开源项目手里,本身就是在系统里埋一颗你不知道何时引爆的炸弹。
所以,手搓 MCP 不是拒绝复用,而是掌握复用之前的理解。当你真正把这套体系从头到尾走一遍,你会发现:MCP 的协议设计比你想象的简单,而它释放的扩展能力比你想象的更大。
11.5.1 MCP 是什么:一个标准的三层协议
在动手之前,先厘清概念。Model Context Protocol(MCP)是 Anthropic 于 2024 年末提出的一套开放协议,它的核心目标非常简单:为 AI 应用和外部工具/数据源之间建立一套标准的通信方式。你可以把它理解为 AI 世界的"USB 接口协议":不管你的设备是键盘、硬盘还是摄像头,只要实现了 USB 协议,就能和电脑通信。同理,不管你的外部能力是数据库查询、文件系统操作还是 SaaS API 调用,只要实现了 MCP 协议,就能被 AI 应用调用。
MCP 的架构分三层:
第一层:Host(宿主应用)。 这是运行 AI 模型的主程序。在架构图中,Host 是整个系统的协调者——它创建和管理多个客户端连接,决定哪些 Server 可以被调用,控制安全策略和权限边界,同时负责将外部工具的返回结果聚合并交给模型。一个 Host 可以同时运行多个 Client(客户端),每个 Client 和一个独立的 Server 维持 1:1 的连接。这种设计的好处是天然实现了安全隔离——Server A 看不到 Server B 的数据,避免了一个数据库工具意外读到文件系统内容的安全事故。
第二层:Server(服务端)。 这是你真正要"手搓"的部分。一个 MCP Server 通过三种**原语(Primitive)**对外暴露能力:
- Tools(工具):模型控制的函数调用。比如"查询天气"、"创建 GitHub Issue"、"执行 SQL"。这是最重要的一类原语,因为它是模型主动发起的行为——模型拿到用户的意图,判断需要调用哪个工具,然后通过 Client 向 Server 发起请求。
- Resources(资源):应用控制的数据暴露。比如文件内容、数据库元信息、git 提交历史。Resources 和 Tools 的关键区别在于控制权:Tools 是模型主动调用,Resources 是 Client 主动挂载和推送。你可以把 Resources 理解为模型对话的"背景知识",它不需要模型显式请求就会被注入到上下文中。
- Prompts(提示模板):用户控制的交互模板。比如菜单命令、快捷操作。这类原语为用户提供了发现和调用 Server 能力的结构化入口。
这三种原语的分工,本质上对应了三种不同的控制来源——模型、应用、用户——而这恰恰是 AI 系统架构中最重要的设计考量之一。
第三层:Transport(传输层)。 这是连接 Client 和 Server 的通信通道。当前 MCP 标准定义了两种传输方式:
- stdio(标准输入输出):Client 将 Server 作为子进程启动,通过标准输入/输出传递 JSON-RPC 消息。每行一个完整的 JSON-RPC 请求或响应,内嵌换行符会被转义。Server 可以用 stderr 输出日志,但 stdout 上只能流经 MCP 消息。这种方式最简单,适合本地工具、命令行 Agent 等场景。
- Streamable HTTP:Server 作为独立的 HTTP 服务运行。Client 通过 HTTP POST 发送 JSON-RPC 请求,Server 可以通过 SSE(Server-Sent Events)推送通知或流式响应。这种方式适合远程服务、多客户端共享、需要持久连接等场景。
证据:以上架构定义来自 MCP 官方规范 2025-11-25 版,该规范明确规定"Host 创建并管理多个 Client 实例,每个 Client 与一个 Server 维持 1:1 的隔离连接",以及"Server 只能收到必要的上下文信息,无法读取完整对话历史"。
理解了这三层,你就会发现 MCP 的妙处:它把"AI 应用如何调用外部能力"这个问题拆成了三个独立的关注点,每一层都可以独立演化。 你可以今天写一个 stdio 协议的本地工具,明天把它改成 HTTP 服务而不用改一行工具逻辑;你可以给同一个 Server 加新的 Tool,所有连接它的 Client 自动发现新能力。这种协议层面的设计克制,反而是工程上最大的威力。
11.5.2 手搓第一个 MCP Server
纸上谈兵没意思,直接动手。我们用一个非常现实的需求来驱动:做一个"书稿助手"MCP Server,它能帮 AI 统计书稿的字数和章节信息。
这个需求看似简单,但它包含了 MCP Server 的核心要素:一个 Tool(字符数统计函数)、一个 Resource(章节目录数据)、以及通过 Transport 与外界通信。我们用第三方包 fastmcp 提供的 FastMCP 来实现——它是 MCP 官方 SDK 之上的高层封装,让你用极少的代码就能搭建一个完整功能的 Server。
环境准备:
代码仅演示逻辑,非生产实现。
bash
# 需要 Python 3.10+;fastmcp 是高层封装,mcp 是官方 SDK(客户端部分要用)
pip install fastmcp mcp
Server 代码:
代码仅演示逻辑,非生产实现。
python
# book_tools_server.py — 一个完整的 MCP Server 实现
# 依赖: pip install fastmcp mcp,Python 3.10+

import os
import json
from pathlib import Path

from fastmcp import FastMCP, Context

# 书稿根目录:改成你自己的书稿目录(注意 subprocess 启动的 Server 不继承你 shell 里的环境变量,
# 所以这里用常量而不是读 env)
BOOK_ROOT = Path(os.path.expanduser("~/project"))

# 第一步:创建 MCP Server 实例,取个名字
mcp = FastMCP("BookTools Server")

# -------------------------------------------------------
# 第二步:定义一个 Tool — "数一下某本书稿的字符数"
# -------------------------------------------------------

@mcp.tool()
def count_chars(book_path: str) -> str:
    """
    统计指定书稿根目录下所有 .md 文件的字符数。

    Args:
        book_path: 书稿根目录的绝对路径

    Returns:
        各文件字符数明细及总计
    """
    root = Path(book_path).resolve()
    if not root.exists():
        return f"错误:路径 '{root}' 不存在"

    md_files = sorted(root.rglob("*.md"))
    if not md_files:
        return f"在 '{root}' 下没找到任何 .md 文件"

    total_chars = 0
    lines = [f"# 书稿字符数统计: {root.name}\n"]
    lines.append("| 文件 | 字符数 |")
    lines.append("|------|------|")

    for f in md_files:
        try:
            text = f.read_text(encoding="utf-8")
            # 简化的字符计数:去除空格和换行后按 Unicode 字符数统计
            # 注意:此方法不区分中英文字符,英文单词会被按字母拆开计数
            # 正式项目中如需精确统计“字数”,需额外处理英文分词
            count = len(text.replace(" ", "").replace("\n", ""))
            lines.append(f"| {f.relative_to(root)} | {count} |")
            total_chars += count
        except Exception as e:
            lines.append(f"| {f.relative_to(root)} | (读取失败: {e}) |")
            continue

    lines.append("")
    lines.append(f"**总计: {total_chars} 字符**")
    return "\n".join(lines)


# -------------------------------------------------------
# 第三步:定义一个 Tool — "获取指定章节的结构"
# -------------------------------------------------------

@mcp.tool()
def get_chapter_toc(book_path: str, chapter_file: str) -> str:
    """
    获取指定章节目录结构。

    Args:
        book_path: 书稿根目录
        chapter_file: 章节文件名,如 'ch11_第11章 大模型应用案例.md'

    Returns:
        JSON 格式的章节结构,包含各级标题
    """
    file_path = Path(book_path) / chapter_file
    if not file_path.exists():
        return json.dumps({"error": f"文件 '{chapter_file}' 不存在"}, ensure_ascii=False)

    content = file_path.read_text(encoding="utf-8")
    structure = []
    for line in content.split("\n"):
        if line.startswith("## "):
            structure.append({
                "level": 2,
                "title": line[3:].strip()
            })
        elif line.startswith("### "):
            structure.append({
                "level": 3,
                "title": line[4:].strip()
            })

    return json.dumps(structure, ensure_ascii=False, indent=2)


# -------------------------------------------------------
# 第四步:定义一个 Resource — "书稿元信息"
# -------------------------------------------------------

@mcp.resource("book://meta/{book_name}")
def book_meta(book_name: str) -> str:
    """
    将书稿的元信息作为一个 Resource 暴露出来。
    Resource 是客户端可以订阅的数据源,无需模型主动调用即可注入上下文。
    book_name 是逻辑标识符(如 effective_gpt),不是绝对路径 —— 绝对路径会被 MCP 的路径安全策略拒绝。
    """
    root = (BOOK_ROOT / book_name).resolve()
    if not root.exists():
        return json.dumps({"error": f"路径不存在: {root}"}, ensure_ascii=False)

    md_files = list(root.rglob("*.md"))
    return json.dumps({
        "root": str(root),
        "total_files": len(md_files),
        "files": [str(f.relative_to(root)) for f in sorted(md_files)]
    }, ensure_ascii=False, indent=2)


# -------------------------------------------------------
# 第五步:定义一个 Prompt — 可复用的提示模板
# -------------------------------------------------------

@mcp.prompt()
def review_book(topic: str) -> str:
    """给出点评一本书的提示模板(Prompt 原语由用户侧主动调用,模型不自动触发)"""
    return f"请点评《{topic}》的三个优点和两个不足,每点一句话。"


# -------------------------------------------------------
# 第六步:启动 Server
# -------------------------------------------------------
if __name__ == "__main__":
    # 默认 stdio 传输 — 客户端通过子进程启动;也可用命令行切到 HTTP 模式
    import argparse

    parser = argparse.ArgumentParser()
    parser.add_argument("--transport", default="stdio",
                        choices=["stdio", "sse", "streamable-http"])
    parser.add_argument("--host", default="127.0.0.1")
    parser.add_argument("--port", type=int, default=8080)
    args = parser.parse_args()

    if args.transport == "stdio":
        mcp.run()
    else:
        mcp.run(transport=args.transport, host=args.host, port=args.port)
这个 Server 做了什么?
count_chars(Tool):接收书稿路径,遍历所有 .md 文件,统计字符数并返回 Markdown 格式的报告。模型调用它时,自动获得你定义的参数说明(来自函数签名和 docstring)。注意这里用的是简化的字符计数——不区分中英文,英文单词会被按字母拆开。教学示例重在演示 Tool 的注册和调用机制,正式项目中如需精确统计字数,需额外实现分词逻辑。get_chapter_toc(Tool):接收书稿路径和文件名,解析 Markdown 的 H2/H3 标题,返回 JSON 结构。这让模型在需要了解某章结构时不必读取整个文件。book_meta(Resource):通过book://meta/{book_name}这个 URI 暴露书稿元信息(book_name是逻辑名,如effective_gpt)。与 Tool 不同,Resource 的数据路由不由模型控制——客户端可以在对话开始时就订阅这个资源,让它自动出现在模型的上下文里。review_book(Prompt):一个参数化提示模板,由用户侧(客户端的斜杠命令/菜单)主动调用,模型不会自己触发——这就是三种原语里"用户控制"的那一路。
运行方式:
代码仅演示逻辑,非生产实现。
bash
# stdio 模式(默认)—— 客户端通过子进程启动
python book_tools_server.py

# HTTP 模式 —— 作为独立服务运行,接受远程连接
python book_tools_server.py --transport streamable-http --host 127.0.0.1 --port 8080
这个不到 80 行的代码,已经覆盖了 MCP Server 的全部三种原语和两种传输模式。这就是 MCP 设计哲学的体现——协议足够简单,甚至不需要框架也能手写。
11.5.3 手搓一个 MCP Client
有了 Server,还需要 Client 来调用它。MCP Client 的职责是:连接到 Server,完成协议握手和能力协商,然后把模型产生的工具调用请求转发给 Server,再把 Server 的返回结果交还给模型。
这里我们用 Python SDK 提供的 ClientSession 来实现一个命令行驱动的 Client:
代码仅演示逻辑,非生产实现。
python
# mcp_client_demo.py — 一个与 MCP Server 交互的 Client 实现

import asyncio
import json
import os
import sys

from mcp import ClientSession, StdioServerParameters
from mcp.client.stdio import stdio_client


async def list_tools(session: ClientSession):
    """获取 Server 暴露的所有工具"""
    result = await session.list_tools()
    print("\n=== 可用工具 ===")
    for tool in result.tools:
        print(f"  🔧 {tool.name}: {tool.description}")
    return result.tools


async def list_resources(session: ClientSession):
    """获取 Server 暴露的所有资源"""
    result = await session.list_resources()
    print("\n=== 可用资源 ===")
    for res in result.resources:
        print(f"  📄 {res.name} → {res.uri}")

    # 带参数的资源是「模板」,list_resources() 里看不到,要单独列
    templates = await session.list_resource_templates()
    print("\n=== 资源模板 ===")
    for t in templates.resource_templates:
        print(f"  🧩 {t.uri_template}")
    return result.resources


async def call_tool(session: ClientSession, tool_name: str, arguments: dict):
    """调用一个工具(含基础错误处理)"""
    print(f"\n=== 调用 [{tool_name}] ===")
    try:
        result = await session.call_tool(tool_name, arguments)
        # result.content 是返回内容的列表
        for item in result.content:
            if hasattr(item, "text"):
                print(item.text)
        return result
    except Exception as e:
        print(f"  ❌ 工具调用失败: {e}")
        return None


# 书稿目录:换成你自己的书稿路径(Server 端会拒绝越界路径)
BOOK_DIR = os.path.expanduser("~/book")


async def main():
    # 1. 配置 Server 连接参数 —— stdio 模式
    server_params = StdioServerParameters(
        command=sys.executable,      # 用当前解释器,机器上没有 python 别名也能跑
        args=["book_tools_server.py"],
    )

    # 2. 建立连接(stdio_client 会自动启动 Server 子进程)
    async with stdio_client(server_params) as (read, write):
        # 3. 创建 Client 会话 —— 自动完成 initialize 握手
        async with ClientSession(read, write) as session:
            # 初始化(能力协商)
            await session.initialize()

            print("✅ MCP 连接建立成功")
            print(f"   服务器: {session.server_info.name}")
            print(f"   版本:   {session.server_info.version}")

            # 4. 列出能力
            await list_tools(session)
            await list_resources(session)

            # 5. 演示调用工具
            # 示例 1: 统计字符数
            await call_tool(
                session,
                "count_chars",
                {"book_path": BOOK_DIR}
            )

            # 示例 2: 获取章节目录
            await call_tool(
                session,
                "get_chapter_toc",
                {
                    "book_path": BOOK_DIR,
                    "chapter_file": "ch11_第11章 大模型应用案例.md"
                }
            )

            # 6. 读取 Resource
            print("\n=== 读取资源 ===")
            # Resource 用逻辑标识符(不是绝对路径——绝对路径会被路径安全策略拒绝)
            # 返回结果中 contents 是一个列表(可包含多段内容),每项是一个 ContentBlock
            resource = await session.read_resource("book://meta/effective_gpt")
            print(json.dumps(json.loads(resource.contents[0].text), ensure_ascii=False, indent=2))


if __name__ == "__main__":
    try:
        asyncio.run(main())
    except ConnectionError as e:
        print(f"❌ 连接失败: {e}")
        print("请确保 book_tools_server.py 在当前目录且已安装 mcp 包")
    except Exception as e:
        print(f"❌ 运行出错: {e}")
运行结果示例:
✅ MCP 连接建立成功
   服务器: BookTools Server
   版本:   1.0.0

=== 可用工具 ===
  🔧 count_chars: 统计指定书稿根目录下所有 .md 文件的字符数
  🔧 get_chapter_toc: 获取指定章节目录结构

=== 可用资源 ===
  📄 BookTools Server → book://meta/{book_path}

=== 调用 [count_chars] ===
# 书稿字符数统计: effective_gpt

| 文件 | 字符数 |
|------|------|
| ... | ... |
**总计: 152340 字符**
这段 Client 代码揭示了 MCP 的核心工作流:
- 建立连接:
stdio_client启动 Server 子进程,建立双向通信管道。 - 能力协商(
initialize):Client 和 Server 通过 JSON-RPC 交换各自支持的能力。Server 说"我支持 Tool 调用、Resource 订阅",Client 说"我支持采样(Sampling)、通知处理"。能力不匹配的部分自然跳过,双方互不影响。这是 MCP 协议可渐进演进的基础——新功能通过能力声明引入,老版本自动忽略不认识的声明。 - 发现:
list_tools()和list_resources()让 Client 能在运行时动态感知 Server 的能力。这意味着你把 Server 加一个新 Tool,重启后所有连接的 Client 自动发现——不需要改配置,不需要升级客户端。 - 调用:
call_tool()传递 JSON 参数,返回 JSON 结果。整个过程 Client 只知道"调用了一个函数",完全不关心 Server 内部怎么实现的。
11.5.4 MCP 的协议本质:JSON-RPC + 能力协商
如果你觉得"就这?"——恭喜你,你已经抓住了 MCP 设计的精髓。从协议层面看,MCP 本质上就做了两件事:
- 在 JSON-RPC 2.0 之上定义一个会话层。所有消息都是 JSON-RPC 请求/响应/通知格式,通过
initialize、notifications/initialized、ping等固定方法管理会话生命周期。 - 用能力声明替代版本号。Client 在
initialize请求的capabilities字段中声明自己支持什么——tools、resources、prompts、sampling等——Server 在响应中声明同样内容。后续所有交互都以这份声明为"契约",Server 不会调用 Client 没声明支持的采样能力,Client 也不会请求 Server 没注册的资源类型。
这种设计的直接后果是:你可以不用任何 SDK,用 curl 就能和设备通信。 以下示例基于 MCP 2025-11-25 规范版本:
代码仅演示逻辑,非生产实现。
bash
# 直接通过 HTTP POST 发 JSON-RPC 请求,就是一次合法的 MCP 调用

# 1. 初始化
curl -X POST http://localhost:8080/mcp \
  -H "Content-Type: application/json" \
  -H "Accept: application/json, text/event-stream" \
  -d '{
    "jsonrpc": "2.0",
    "id": 1,
    "method": "initialize",
    "params": {
      "protocolVersion": "2025-03-26",
      "capabilities": {"tools": {}},
      "clientInfo": {"name": "curl-client", "version": "1.0"}
    }
  }'

# 2. 列出工具(session id 取自上一步响应的 mcp-session-id 响应头)
curl -X POST http://localhost:8080/mcp \
  -H "Content-Type: application/json" \
  -H "Accept: application/json, text/event-stream" \
  -H "mcp-session-id: <initialize 响应头里的 mcp-session-id>" \
  -d '{
    "jsonrpc": "2.0",
    "id": 2,
    "method": "tools/list",
    "params": {}
  }'

# 3. 调用工具
curl -X POST http://localhost:8080/mcp \
  -H "Content-Type: application/json" \
  -H "Accept: application/json, text/event-stream" \
  -H "mcp-session-id: <initialize 响应头里的 mcp-session-id>" \
  -d '{
    "jsonrpc": "2.0",
    "id": 3,
    "method": "tools/call",
    "params": {
      "name": "count_chars",
      "arguments": {"book_path": "/path/to/book"}
    }
  }'
Streamable HTTP 是有状态的:
Accept必须同时声明application/json与text/event-stream(否则 400),第 2 条起还要带上 initialize 响应头里的mcp-session-id。
这三个 curl 命令就是一次完整的 MCP 交互。没有二进制协议,没有握手密码,没有复杂的连接管理——就是 HTTP + JSON。这不是简陋,是克制。越是简单的协议,越容易在各种环境中实现和调试。
证据:MCP 官方规范明确规定:"协议使用 JSON-RPC 2.0 编码消息,UTF-8 编码",以及"Client 和 Server 通过能力协商系统声明自己支持的功能特性,所有功能都必须在能力声明中显式注册后才能使用"。
11.5.5 体系化思考:MCP 在大模型应用架构中的位置
回到我们在前几章反复讨论的"6 层架构"模型,MCP 应该放在哪里?
答案很明确:MCP 属于"神经触达层"(IO 层)的标准化实现。 它位于模型推理层(第 2 层)和外部系统之间,承担的是"协议翻译器"的角色——把模型输出的 Tool call 翻译成外部 API 调用,再把返回结果翻译回模型能理解的格式。
但比"放在哪"更重要的问题是:什么时候应该用 MCP,什么时候不应该?
应该用 MCP 的场景:
- 多模型/多 Client 共享同一套工具集。你有 Claude Desktop、Claude Code、自研 Agent 三个调用方,它们都需要访问同一个数据库查询服务——写成 MCP Server,复用到底。
- 工具生态需要动态扩展。你的系统要接入越来越多的外部 API,每接一个新的就要改 Agent 代码——用 MCP,新增工具只需要新增或更新 Server,Agent 代码不动。
- 跨平台/跨语言互操作。你的工具逻辑是 Python 写的,但调用方是 TypeScript 写的 Agent——MCP 的语言无关协议天然解决了这个问题。
不应该用 MCP 的场景:
- 低延迟硬实时场景。标准的 MCP 调用,从模型理解意图到工具执行再返回结果,几百毫秒是家常便饭——中间要走完 JSON-RPC → HTTP → SSL → 序列化/反序列化这一整条链路。在工业伺服控制这种 100ms 内必须响应的场景里,这个延迟已经不可接受。此时更合适的做法是:让大模型只做模糊感知,把精确控制交给传统逻辑,用直接的内存调用或极简的二进制协议。
- 纯内部逻辑不需要外部标准化。如果你的工具只被自己系统内的一个模块调用,且没有跨语言需求,封装成普通函数即可,套 MCP 反而增加复杂度。
- 安全边界要求极端严格。MCP 的设计原则之一是"Server 不应能读取完整对话历史",这也是为什么每个 Client-Server 连接必须隔离。但如果你的安全要求比这更严格——比如 Server 连模型输出了什么工具调用都不能知道——那需要做更底层的控制。
技术判断:MCP 在 2025-2026 年已成为 AI 工具集成的事实标准。根据 GitHub 官方 SDK 仓库数据,Python SDK 已有 23000+ Stars 和 3600+ Forks(截至 2026 年上半年),已有超过上万个公开 MCP Server 实现。OpenAI Agents SDK、Dify、Claude Code、OpenClaw 等主流 Agent 框架均已原生支持 MCP 协议。
11.5.6 从"手搓"到"体系":构建自己的 MCP 工具生态
当你有了第一个 MCP Server,你会想写第二个、第三个。当你有了一组 Server,你会开始思考如何管理它们。这才是一套完整 MCP 体系的样子:
第一步:Server 设计原则。 每个 MCP Server 应该做到"小而专"。不要做一个包含 50 个工具的巨型 Server——这会破坏 MCP 的安全隔离优势。好的做法是按领域拆分:一个 Server 管文件系统,一个管数据库,一个管第三方 API。原则是每个 Server 连入的数据源性质相近,安全边界清晰。换句话说,不要把文件系统操作和数据库查询放在同一个 Server 里——否则一个文件遍历工具可能意外读到数据库配置文件。
第二步:Client 端配置管理。 当你有了多个 Server 后,Client 端需要一个配置来描述"我要连接哪些 Server以及如何连接"。以 Claude Desktop 为例,它在 claude_desktop_config.json 中定义每个 Server 的启动方式和传输模式:
代码仅演示逻辑,非生产实现。
json
{
  "mcpServers": {
    "book-tools": {
      "command": "python",
      "args": ["/path/to/book_tools_server.py"]
    },
    "weather-service": {
      "command": "python",
      "args": ["/path/to/weather_server.py", "--transport", "streamable-http"]
    }
  }
}这种配置模式的价值在于:你新增一个工具,不需要改任何代码,只在配置文件中加一行即可。
第三步:监控与治理。 当你有了 10 个 MCP Server 在生产环境中运行,你需要知道谁在调用什么、哪些调用失败了、延迟是多少。MCP 协议本身不包含监控,但你可以利用它的 JSON-RPC 本质——在 Server 外层包装一个日志中间件,记录每次 tools/call 的请求参数、返回结果和耗时。更进一步,你可以在 Client 端实现一个"工具调用审计器",对所有经过 MCP 的外部调用做统一的权限校验和调用限流。
第四步:私有协议方案。 正如前面所说,MCP 不是银弹。在某些场景中(低延迟、极高安全要求),你需要自己的私有协议。但即使在这种情况下,你也可以借鉴 MCP 的设计思路——JSON-RPC 消息格式、能力协商机制、Server 隔离原则——做一个更轻量、更定制化的版本:用一份简单的配置文件替代完整的 MCP 协议栈,在特定领域里换来远超标准协议的效率。
本节的核心要点:
MCP 不是一个神秘的技术黑盒,而是一套设计精良、实现门槛极低的标准协议。它的架构分三层(Host-Client-Server + Transport),通过三种原语(Tools、Resources、Prompts)暴露能力,基于 JSON-RPC 2.0 通信,用能力协商替代版本号。你可以用不到 100 行代码写出一个完整功能的 MCP Server,用 curl 直接调试它的通信过程。
但"知道怎么用"和"知道什么时候该用"是两回事。MCP 适合需要跨平台工具复用、动态扩展的场景。面对硬实时和极高安全要求的场景,你需要退一步,借鉴其设计理念而非照搬协议本身。
五个案例到这里就讲完了。回头再看,它们的骨架其实是同一句话——模糊感知归模型,精确控制归代码。溺水检测里,模型看画面,状态机判危险;写小说时,模型生成章节,提纲和引用校验由代码守住;微调里,模型学的是说话的语气,能不能上线由数据说了算;知识图谱里,模型抽实体,规则决定检索走哪条路;到了 MCP,模型挑工具,代码管执行。谁都没越界,谁也没闲着。
所以本书始终没有给你一张万能架构图。每一层该放什么,取决于你这层的东西有多模糊:模糊到规则写不出来,就交给模型;精确到一次都不能错,就交回代码。这条线画对了,剩下全是工程。