
主题
第6章 大模型技术生态
大模型不是一个技术名词,也不是一项单独的技术。大模型是若干技术组成的技术生态,这些技术生态支撑了大模型惊艳的技术底座。这些技术生态非常复杂,既有横向的跨领域协作,也有纵向的深度挖掘。而且这些技术过于庞杂繁多,如果不加思索地贸然进入,浪费时间都算是小事情,错过大模型的黄金时段才是大事。本章的作用是给你展现大模型的学习地图,让所有学习大模型的人能够找到适合自己的最佳路线。
6.1 什么是大模型技术生态
在进入具体的工具实战之前,我们必须先回答一个直击灵魂的问题:既然大模型已经如此强大,甚至能写代码、做决策,为什么我们还需要一个如此庞杂的“技术生态”?
6.1.1 大模型应用的软件工程本质
很多初学者认为,开发大模型应用就是写一段完美的提示词(Prompt)。但从架构师的角度看,大模型应用的本质是“概率性组件”与“确定性软件工程”的耦合。
- 模型是不确定的:同一个问题,模型两次回答可能完全不同。
- 软件是确定的:你的数据库、财务系统、工业控制逻辑必须 100% 准确。
- 生态的作用:大模型技术生态存在的意义,就是通过一系列工具(Tools)、协议(Protocols)和框架(Frameworks),将那个“充满灵感但不可控”的大脑,安全、高效、可预期地接入到现实世界的生产流水线中。
6.1.2 技术栈(Tech Stack)与技术生态(Ecosystem)
这两个概念经常被混淆,但在 2026 年的今天,它们的界限已经非常清晰:
- 技术栈 (Tech Stack):是指实现一个功能所必须的垂直技术链条。比如:Ubuntu (系统) + CUDA (驱动) + PyTorch (框架) + vLLM (推理)。它关注的是“如何跑起来”。
- 技术生态 (Ecosystem):是指围绕大模型形成的网状支持体系。它不仅包含如何跑模型,还包含如何评估模型(EvalScope)、如何获取知识(MCP)、如何连接外部工具(OpenClaw)。它关注的是“如何好用、如何进化、如何协同”。
技术栈是骨架,技术生态是血肉。 没有生态的支持,大模型只是一个孤岛。
6.1.3 大模型技术生态全景图
为了让大家在浩如烟海的开源项目中不迷失方向,我绘制了这张《2026 大模型全景架构图》。
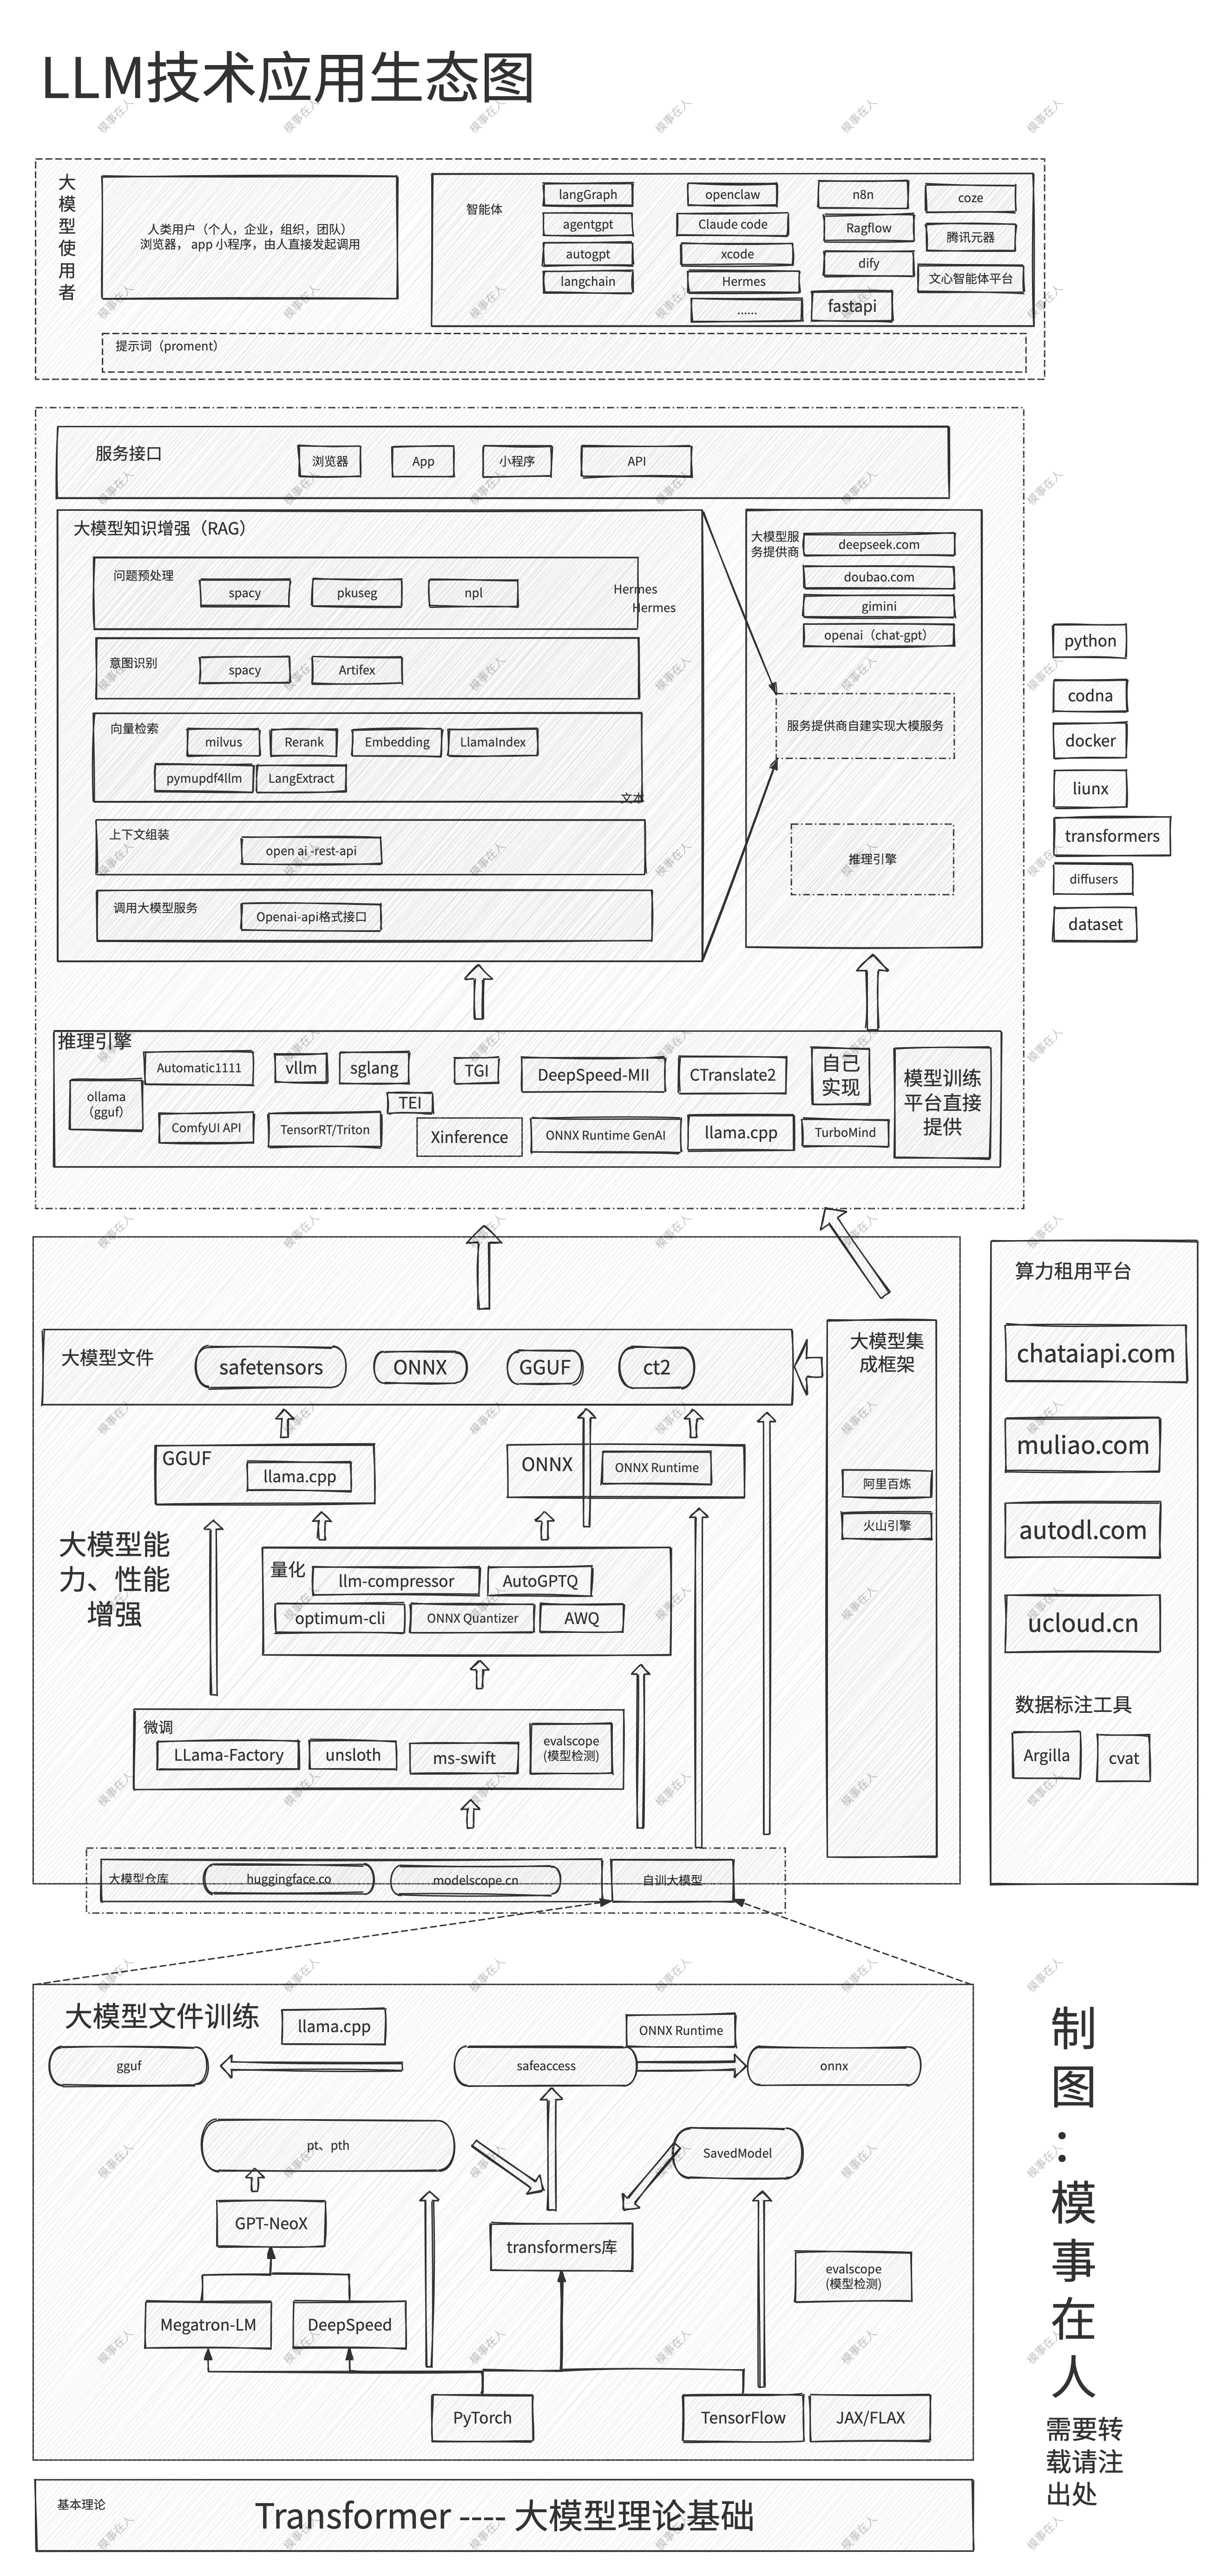
图 6-1:2026 大模型技术生态全景(模型 → 框架 → 训练 → 推理 → 应用)
这张图是我们本章的路线图。我们将不再讨论空洞的理论,而是将其作为一份**“技术字典”**。当你需要解决显存不足时,去“模型微调”查 Unsloth;当你想让模型接入你的私有数据库时,去“MCP协议”查相关实现。
6.2 大模型技术生态的基本技术
大模型技术的生态涉及到的技术非常多,但有一些基础技术是所有高级框架的“地基”。虽然在工程实践中你很少单独调用它们,但了解它们的特性有助于你理解为什么某些工具会报错,以及如何优化性能。
6.2.1 Pytorch:大模型的动力心脏
如果要在大模型技术生态里选一个"必须存在、但大部分人不会直接碰"的组件,PyTorch 是唯一选项。它在整个生态中的位置,像极了操作系统内核——平时你看不到它,但所有程序都跑在它上面。
为什么 PyTorch 是"动力心脏"
大模型的训练和推理,本质上是海量的张量运算(矩阵乘法、注意力计算、梯度反向传播)。Python 本身做不到这些——它的数值运算太慢,必须依赖 C++ / CUDA 层面的底层库来执行实际的浮点运算。PyTorch 做的就是这个:它提供了一套 Python 接口,让开发者用 Python 写模型逻辑,但实际的算力消耗发生在 GPU 上的 CUDA 算子中。业界另一个主力深度学习框架是 Google 的 JAX,但截至 2026 年,PyTorch 依然是 Hugging Face Transformers、vLLM、LLaMA-Factory 等主流大模型工具的底层依赖——原因很简单,PyTorch 的生态成熟度和社区规模仍然是断层领先的 [8]。
因此,PyTorch 很少单独安装。如果你用 vLLM 做推理,pip install vllm 会自动拉取对应的 PyTorch 作为依赖;如果你用 LLaMA-Factory 做微调,装这个工具的时候 PyTorch 就已经在环境里了。专门手写 pip install torch 的场景,只出现在学习、调试或者从零搭建实验环境的时候。
安装方式:Docker 优先
正是因为 PyTorch 的"隐形人"属性,它的安装更像是环境搭建的一部分,而非工具选择。对于学习者和开发者,有两种主流路径。
Docker 安装(推荐生产级实验)
Docker 是获取稳定 PyTorch 运行环境的最佳方式。直接原因只有一个:你不需要自己匹配 CUDA 驱动版本。
PyTorch 的 GPU 加速依赖 CUDA Toolkit 和 cuDNN,这三个东西的版本必须精确对应——PyTorch 版本、CUDA 版本、NVIDIA 驱动版本,三者之间的关系像一个"版本三元一次方程" [9]。错一位可能导致 torch.cuda.is_available() 返回 False,而报错信息往往又语焉不详,排查起来很痛苦。
NVIDIA 官方维护的 PyTorch 容器镜像解决了这个问题:镜像内 PyTorch + CUDA + cuDNN 已经配好,你只需要确保宿主机的 NVIDIA 驱动版本不低于镜像的 CUDA 版本要求即可。拉取镜像:
bash
docker pull nvcr.io/nvidia/pytorch:24.03-py324.03-py3 是一个经过验证的稳定版本标签。如果你需要更新版本,可以在 NVIDIA NGC Catalog 查看所有可用标签。
启动容器时,有一个参数必须加:--ipc=host。
bash
docker run --gpus all --ipc=host -it --rm nvcr.io/nvidia/pytorch:24.03-py3--ipc=host 让容器使用宿主机的共享内存空间(/dev/shm)而非 Docker 默认分配的 64MB。PyTorch 的 DataLoader 在多进程模式下使用共享内存来传输数据——当你做多卡推理或大规模数据加载时,默认的 64MB 会在毫无征兆的情况下被撑爆,表现为"莫名其妙"的 RuntimeError: DataLoader worker (pid xxx) exited unexpectedly。这个错误在 Stack Overflow 上有大量受害者,根因几乎都是忘了加 --ipc=host [3]。
--rm 表示容器退出后自动删除,适合临时实验环境。如果你需要一个持久化的开发环境,去掉 --rm 并挂载一个本地目录:
bash
docker run --gpus all --ipc=host -it \
    -v /path/to/your/workdir:/workspace \
    nvcr.io/nvidia/pytorch:24.03-py3
conda + pip 安装(适于学习环境)
如果你的场景是快速搭一个学习用的虚拟环境,不涉及生产级的版本稳定性要求,conda + pip 是更轻量的选择:
bash
# 创建 Python 3.10 的 conda 环境
conda create -n pytorch_py310 python=3.10
conda activate pytorch_py310

# 默认安装(PyTorch 官网自动检测 CUDA 版本)
pip install torch torchvision torchaudio

# 指定 CUDA 版本安装(以 CUDA 12.1 为例)
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu121
官网上的 pip install torch 命令默认带一个 --index-url 参数指向 PyTorch 自己的 PyPI 镜像。不同 CUDA 版本对应不同的 URL 后缀(cu118、cu121、cpu 等)。你也可以在 PyTorch 版本历史 中查到所有历史版本的安装命令。如果只是想快速验证一段代码,用 CPU 版本(后缀 cpu)也可以——所有 PyTorch 代码在 CPU 上都能跑,只是慢。
安装后验证
无论哪种安装方式,进环境后的第一件事应该是做验证,而不是直接开始写代码。三条命令,耗时不超过 10 秒,但它能帮你排除 80% 的环境问题:
python
import torch

# 1. 检查 PyTorch 版本
print(f"PyTorch 版本: {torch.__version__}")

# 2. 检查 CUDA 是否可用
print(f"CUDA 可用: {torch.cuda.is_available()}")

# 3. 如果 CUDA 可用,查显卡型号和 CUDA 版本
if torch.cuda.is_available():
    print(f"显卡型号: {torch.cuda.get_device_name(0)}")
    print(f"CUDA 版本: {torch.version.cuda}")
    print(f"显存总量: {torch.cuda.get_device_properties(0).total_mem / 1024**3:.1f} GB")
预期输出类似:
PyTorch 版本: 2.4.0a0+b07c3b4
CUDA 可用: True
显卡型号: NVIDIA GeForce RTX 4090
CUDA 版本: 12.1
显存总量: 24.0 GB
如果 CUDA 可用: False,常见原因有三个:(1) 没有 NVIDIA GPU 或驱动未装好(nvidia-smi 自查);(2) PyTorch 装的是 CPU 版本(检查 pip list 中的 torch 包名,CPU 版不带 +cu 后缀);(3) CUDA 版本与驱动不匹配。大部分情况下问题出在第三条——比如 PyTorch 带了 CUDA 12.1,但你的驱动只支持到 CUDA 11.8。解决方案是降级 PyTorch 或升级驱动,哪个更容易做哪个。
避坑指南
这些坑源于真实的踩坑经验,而非理论推导。
第一坑:版本不是越新越好。 PyTorch 的版本策略是"激进迭代"——新版本经常引入新的算子或性能优化,但也可能打破向下兼容。在你 GitHub 上随手 fork 的开源项目中,如果作者用的是 PyTorch 2.1.0,你用 PyTorch 2.5.0 直接跑大概率会报错,或者更糟:不报错但数值结果有微小偏差。在大模型工程中,匹配比最新更重要。先看项目的 requirements.txt 或 environment.yml 中指定的 PyTorch 版本,跟着装,不要自己"升级"。
第二坑:--ipc=host 必须加。 如果你用 Docker 做多卡推理或 DataLoader 多进程加载数据时遇到 RuntimeError 报错,第一反应应该是检查是否有 --ipc=host。这个坑我们已经在上文强调过,但它实在太高频了——即便你知道这个原理,在实际操作中还是会忘,所以值得再说一遍。
第三坑:生产项目不要单独装 PyTorch。 这条不是安装技巧,是工程习惯。在大模型项目的实际开发中,你的起点通常是一个微调框架(LLaMA-Factory、Unsloth)或一个推理引擎(vLLM、SGLang)。这些工具的 pip install 指令会自动解决 PyTorch 依赖,你不需要、也不应该先手动装一个 PyTorch 再装这些工具——手动安装的版本可能与工具不兼容,引入一个本不该存在的版本冲突。PyTorch 就像一个操作系统内核,请让"发行版"来帮你配置它。
第四坑:即使没配好也先别慌。 如果你按照上面的步骤操作,PyTorch 仍然没有正确识别你的 GPU——别焦虑。这不影响你继续学习后续章节。PyTorch 的 CPU 模式一样可以跑所有示例代码(只是更慢),而真正的生产环境通常会由运维或基础设施团队提供预配置好的 Docker 镜像或集群环境。你现在配不好的东西,在实际工作中大概率也不需要你亲手去配。先动起来,比纠结环境问题更重要。
6.2.2 Datasets:数据工厂的传送带
大模型的训练和微调需要大量高质量数据。但你不太可能是从头收集数据——更多时候,你在用公开数据集做实验,想把 Wikitext 灌进模型试试效果,或者用 IMDB 影评数据跑一个情感分类任务。这时候你会撞上一个很具体的问题:数据从哪来,怎么高效地喂给模型?
直接下载一个几十 GB 的 JSON 文件、然后自己写解析逻辑当然可以,但你会很快发现这条路走不远。不同数据集格式各异——CSV、JSON Lines、Parquet、TFRecord——每换一次数据集就要重新适配代码。更头疼的是,一些大型数据集动辄几百 GB,你的硬盘根本装不下,更别提加载到内存里了。
datasets 库就是为解决这一整套问题而设计的。
一张"身份证"统一所有数据
datasets 是 Hugging Face 生态中的数据处理组件,核心功能只有一句话:让你用同一套代码加载所有数据集。
这背后的关键在于它定义了一套统一的数据格式。无论原始数据是什么形态——维基百科的文本文件、IMDB 的 JSON 评论、还是 CIFAR-10 的图像二进制——datasets 都会把它们包装成同一种数据结构:一份带有列名和类型标注的表格,每一行是一个样本。访问方式和操作 Pandas DataFrame 几乎一致,学过 Pandas 的人上手几乎是零门槛。
一段最简单的代码说明问题:
python
from datasets import load_dataset

# 加载 IMDB 电影评论数据集(情感分类)
dataset = load_dataset("imdb")

# 查看数据结构
print(dataset)
# DatasetDict({
#     train: Dataset({
#         features: ['text', 'label'],
#         num_rows: 25000
#     }),
#     test: Dataset({
#         features: ['text', 'label'],
#         num_rows: 25000
#     }),
#     unsupervised: Dataset({
#         features: ['text', 'label'],
#         num_rows: 50000
#     })
# })

# 像操作列表一样访问数据
print(dataset["train"][0]["text"][:100])
# "I rented I Am Curious-Yellow from my video store because..."

# 直接转为 Pandas DataFrame 做分析
df = dataset["train"].to_pandas()
print(df["label"].value_counts())
load_dataset("imdb") 这一行背后发生了什么?datasets 先在 Hugging Face Hub 上找到 IMDB 数据集的"身份证"(仓库名),然后根据数据集作者预先配置好的加载脚本,自动完成下载、解压、格式转换。你不需要知道原始文件是 CSV 还是 Parquet,不需要自己处理缺失值或字段类型转换——库已经帮你做好了。对于初学者来说,这意味着复杂的数据预处理被简化为一行 Python;对于有经验的工程师来说,这意味着数据管道的可移植性——换一个数据集,只需要把 "imdb" 改成 "wikitext" 或 "squad",其他代码原封不动。
流式加载:边下载边训练
但"能用"只是第一步。"用得好"需要解决工程的硬约束——数据太大怎么办?
假设你要用 OpenWebText 做预训练。这是一个从 Reddit 链接爬取的高质量文本集合,总大小约 40 GB。你可以在本地先下载完整数据集,再加载训练。但如果你的机器是云上一台只有 50 GB 系统盘的 GPU 实例,这条路就堵死了——下载完数据集之后剩余硬盘空间连模型都装不下。
datasets 的流式模式解决了这个问题:
python
from datasets import load_dataset

# streaming=True:数据不在硬盘落全量,而是按需逐批"流过"
dataset = load_dataset("openwebtext", split="train", streaming=True)

# 逐条读取,每次只消费当前一条数据的内存
for i, sample in enumerate(dataset):
    if i >= 3:
        break  # 演示:只看前三条
print(sample["text"][:80])流式加载的原理可以类比在线视频播放:你不必把整部电影下载到本地才能开始看,而是播放器边缓冲边播放。datasets 做的是类似的事情——它从 Hugging Face Hub 逐片下载数据,一批一批地交给训练循环,上一批数据训练完就释放内存,不给硬盘留负担。
这个特性在 LLM 预训练场景中价值巨大。预训练数据量通常在 TB 级别,任何硬盘都装不下全部。流式加载让数据像传送带一样源源不断地流进 GPU,训练程序不用关心"这批数据读完了下一批在哪",只管消费当前批次。
内存映射:数据集比内存大也不怕
即使你硬盘够大,把数据集完整下载了,第二个问题接踵而至:数据集比你的内存还大怎么办?
假设你有一份 64 GB 的预训练语料,但机器只有 32 GB 内存。常规的 Python 做法是 open("data.json").read() 或者 pandas.read_json("data.json"),这两种方法都会尝试把整个文件加载到内存中——然后程序被 OOM Killer 干掉。
datasets 的解决方案是 内存映射(Memory Mapping)。它的底层实现使用 Apache Arrow 格式存储数据,Arrow 支持操作系统级别的内存映射——说白了,就是把磁盘上的大文件直接映射到虚拟地址空间里,操作系统负责按需把需要的页面调入物理内存,不需要的部分就留在磁盘上。
你可以这样理解:内存映射就像在一本书里贴了标签,你需要读哪一段,操作系统帮你翻到那一页,而不是让你把整本书举起来。对于你的 Python 代码来说,访问方式和操作一个已在内存中的列表完全一样——索引、切片、遍历——区别是物理上只有正在用到的数据页驻留在内存中。
python
from datasets import load_dataset

# 不加 streaming=True → 默认模式:下载完整数据集,但使用内存映射
dataset = load_dataset("wikitext", "wikitext-2-raw-v1")

# 32 GB 内存可以安全操作 100 GB 的数据集
section = dataset["train"]["text"][1000000:1000100]这个设计的意义在于:它把数据规模的上限从"你的内存有多大"变成了"你的硬盘有多大"。对于个人开发者或小团队来说,这意味着不必为了跑一个实验就租 256 GB 内存的实例——一台普通云 GPU 节点,配一张消费级硬盘,就能处理中型数据集。
在工程里怎么用它
datasets 在整个大模型流水线中的位置非常清晰。它不是模型,不做推理,也不训练——它就是数据工厂里的那条传送带:把原料从仓库运到加工台。
典型的使用链路是:
datasets 加载并预处理数据
  ↓
Transformers tokenizer 将文本转为 token ID
  ↓
PyTorch DataLoader 批量喂给 GPU
  ↓
Trainer / 自定义训练循环 进行训练
datasets 与 Hugging Face 生态中的其他组件天然集成。它产出的 Dataset 对象可以直接通过 .map() 方法批量应用 tokenizer,不需要你自己写 for 循环;它有 .set_format("torch") 方法,一行代码就把数据格式转换为 PyTorch Tensor,直接对接训练循环。
这个"传送带"隐喻值得记住:你真正要操心的是模型和训练逻辑,而不是数据从硬盘搬到内存的具体细节。datasets 的价值恰恰就在于让这个搬运过程变得"不可见"——当你不用再为数据加载写胶水代码时,你才能把精力投入在真正重要的地方。
6.2.3 Accelerate:多显卡调度的指挥家
有了 PyTorch 这个"动力心脏",下一个自然的问题就是:如果一张显卡放不下模型,怎么办?
纯 PyTorch 的答案是 DataParallel 和 DistributedDataParallel(DDP)。这两个 API 在多卡场景中已经稳定运行了很多年,但它们的共同问题是与单卡代码不兼容。DataParallel 看起来只加一行代码就能用,实际却有不少隐藏问题:它把模型复制到多卡上运行,但主卡(GPU 0)要负责收集所有卡的梯度并做汇总,导致主卡显存占用总是比其他卡高一截,负载严重不均 [11]。DistributedDataParallel 解决了负载不均的问题,代价是启动方式完全变了——你需要在训练脚本里显式管理 local_rank、自己处理 DistributedSampler,到处都是 if torch.cuda.device_count() > 1: 这样的条件分支。更令人头疼的是,写完一份 DDP 代码后,你想回到单卡上快速调试?对不起,那堆分布式逻辑会挡在你和你的单卡调试之间——torchrun 单卡启动和 python train.py 的启动方式是两套完全不兼容的体系。
Hugging Face 的 accelerate 库正是为了解决这个困境而诞生的。
核心设计:只写一次,到处运行
Accelerate 的设计哲学可以浓缩为一句话:把分布式逻辑从你的训练代码中剥离出来。 它不要求你学习新的框架或 API,只在你现有的 PyTorch 训练循环上加寥寥几行代码。关键是,加上这几行代码之后,同一份脚本可以不加修改地在任何设备上运行——单卡、多卡、多机多卡,甚至 CPU 和 TPU [11]。
来看一段对比。这是一个标准的单卡 PyTorch 训练循环:
python
import torch
import torch.nn.functional as F
from datasets import load_dataset

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
vocab_size, num_classes = 100_000, 2

# 最小的文本分类模型:词袋平均 → 线性分类
class TextClassifier(torch.nn.Module):
    def __init__(self, vocab_size: int, num_classes: int, dim: int = 128):
        super().__init__()
        self.embed = torch.nn.EmbeddingBag(vocab_size, dim, mode="mean")
        self.fc = torch.nn.Linear(dim, num_classes)

    def forward(self, flat_ids: torch.Tensor, offsets: torch.Tensor) -> torch.Tensor:
        return self.fc(self.embed(flat_ids, offsets))

model = TextClassifier(vocab_size, num_classes).to(device)
optimizer = torch.optim.Adam(model.parameters())

dataset = load_dataset("imdb", split="train")

def encode(text: str) -> torch.Tensor:
    """教学用的简化"分词":按字节映射到词表,只为跑通流程,不代表真实分词。"""
    return torch.tensor([b % vocab_size for b in text.encode("utf-8")[:512]], dtype=torch.long)

def collate(batch):
    ids = [encode(row["text"]) for row in batch]
    offsets = torch.tensor([0] + [len(x) for x in ids]).cumsum(0)[:-1]  # 每个样本的起始位置
    return (torch.cat(ids).to(device),
            offsets.to(device),
            torch.tensor([row["label"] for row in batch]).to(device))

data = torch.utils.data.DataLoader(dataset, batch_size=8, shuffle=True, collate_fn=collate)

model.train()
for epoch in range(3):
    for flat, offsets, targets in data:
        optimizer.zero_grad()
        output = model(flat, offsets)
        loss = F.cross_entropy(output, targets)
        loss.backward()
        optimizer.step()
        print(f"loss: {loss.item():.4f}")
这段代码只能在单卡上跑。如果你有两张卡,需要把 model 包进 DataParallel 或 DistributedDataParallel,需要手动分片数据,需要处理 rank 和 world_size……代码量至少翻一倍。
用 Accelerate,只需要加 5 行:
python
import torch
import torch.nn.functional as F
from datasets import load_dataset
from accelerate import Accelerator           # ← 新增

accelerator = Accelerator()                  # ← 新增
device = accelerator.device                  # ← 替换原有的 device 定义

model = TextClassifier(vocab_size, num_classes).to(device)
optimizer = torch.optim.Adam(model.parameters())

dataset = load_dataset("imdb", split="train")
data = torch.utils.data.DataLoader(dataset, batch_size=8, shuffle=True, collate_fn=collate)

# ← 新增:让 Accelerator 接管模型、优化器、数据加载器
model, optimizer, data = accelerator.prepare(model, optimizer, data)

model.train()
for epoch in range(3):
    for flat, offsets, targets in data:
        optimizer.zero_grad()
        output = model(flat, offsets)
        loss = F.cross_entropy(output, targets)
        accelerator.backward(loss)           # ← 替换 loss.backward()
        optimizer.step()
        print(f"loss: {loss.item():.4f}")
改动清单:导入了 Accelerator,初始化了一个 accelerator 对象,用 accelerator.device 替换了手工 device 赋值,用 accelerator.prepare() 包装了模型/优化器/DataLoader,用 accelerator.backward() 替换了 loss.backward()。就这五处。
上面这段为了看得清楚,省略了与前面重复的部分:TextClassifier / encode / collate 三个定义,以及 vocab_size, num_classes = 100_000, 2 这行常量(直接沿用)。这些必须补回去,否则 TextClassifier(vocab_size, num_classes) 会直接 NameError。
补齐后对比两块:训练循环里只差 accelerator.backward(loss) 这一处,其余四处(import、Accelerator()、device 赋值、prepare)都在循环外面。模型还是那个 TextClassifier,collate_fn 还在,循环还是解包 flat, offsets, targets。
这一点值得强调:用 Accelerate 改造旧脚本,不是重写一遍,而是在原脚本上打五个点。改动越小,你才越能相信“单卡还和以前一样”。上面单卡版本能跑,改完这五处单卡依然能跑;到了多卡上,它会自动发现所有可用 GPU 并做分布式训练——数据分片、梯度同步、设备管理,全部自动完成 [12]。
这就是 Accelerate 的核心价值:你的代码只描述"要做什么训练",Accelerate 负责"在哪里训、怎么并行"。
accelerate config + accelerate launch:一键启动
代码改好了,怎么在多卡上跑?答案是两个命令:
bash
# 第一步:配置训练环境(只需做一次)
accelerate config

# 第二步:启动训练
accelerate launch train.py
accelerate config 是一个交互式问答向导,它会问你几个问题:有几张卡?要不要混合精度?用不用 DeepSpeed?答完就生成一个配置文件(默认在 ~/.cache/huggingface/accelerate/default_config.yaml),之后 accelerate launch 会自动读取它。
如果你不想走配置向导,也可以直接在 launch 命令里传递参数——这在对不同机器写启动脚本时尤其有用 [13]:
bash
# 在 2 张 GPU 上启动,使用混合精度
accelerate launch --multi_gpu --num_processes 2 --mixed_precision fp16 train.py
对比纯 PyTorch 的多卡启动方式,你就能感受到差距:
bash
# 纯 PyTorch 多卡启动(需要记住 torchrun 参数)
python -m torch.distributed.run \
    --nproc_per_node=2 \
    --master_port=29500 \
    train.py

# Accelerate 多卡启动(一行就够了)
accelerate launch --multi_gpu --num_processes 2 train.py
Accelerate 本质上是 torchrun 的友好封装,但它在封装的同时还提供了混合精度(fp16/bf16/fp8)、梯度累积、DeepSpeed/FSDP 等一系列"加分项"的统一接口。你不需要去查 "DeepSpeed ZeRO Stage 2 的命令行参数怎么写",只需要在 accelerate config 里选一下。
什么时候用,什么时候不用
Accelerate 最适合的场景是你已经在写自己的 PyTorch 训练循环,但现在需要扩展到多卡。 如果你的训练代码本身就运行在 Hugging Face Trainer 上——比如你用的是 Transformers 库的标准训练流程——那么你其实已经在用 Accelerate 了:Trainer 的内部实现正是基于 Accelerate 的 [14]。不需要额外做什么。
但 Accelerate 不是一个"全自动训练平台"。它假设你会写、也愿意写 PyTorch 训练循环。如果你想要一个帮你管数据、管日志、管 checkpoint 的"全家桶",应该去看更高层的框架(比如 LLaMA-Factory)。Accelerate 只做一件事:让你不想管的那部分(分布式调度)消失,让你想管的这部分(训练逻辑)原样保留。
一个小提醒
Accelerate 虽然把复杂度藏到了幕后,但你仍然需要知道自己的硬件是什么。accelerate config 会让你选择分布式后端(FSDP、DeepSpeed 或 NO),选择混合精度策略——这些选项直接影响训练效率和显存占用。如果你只是想在多卡上跑一个中等大小的模型,选 NO(不使用 FSDP/DeepSpeed)就足够,不要因为有这些选项就觉得自己必须用上。复杂度和需求的匹配,比"用上高级功能"更重要。
6.2.4 Transformers:大模型生态的“普通话”
在第 3 章,你只写了三行关键代码:一行 AutoTokenizer.from_pretrained() 加载分词器,一行 AutoModelForCausalLM.from_pretrained() 加载权重,一行 model.generate() 生成回答。当时你没有多想,因为教程都是这么写的,而且它确实跑通了。
现在请回想一个细节:如果你把模型名从 Qwen 换成 Llama,换成 Mistral,换成 DeepSeek,或者换成一个你从没听过的小团队上周刚发的模型,这三行代码需要改吗?
几乎不用改。改的只是那个字符串。
这件事其实相当反常。Llama 用 RMSNorm 加旋转位置编码;DeepSeek 在注意力里塞进了 MLA 和多专家路由;Qwen 有自己的 QKV 偏置设计;不同模型在归一化位置、激活函数、注意力掩码的实现细节上差异很大。如果每一家的模型都要单独写一份加载代码,Hugging Face 上几十万个模型就意味着几十万份互不兼容的胶水代码——而现实中,绝大多数模型都可以用同一套接口加载。
本节要回答的核心问题就是:为什么全世界的模型,最后都要通过这一个库来加载?
答案不是“因为它最大”,也不是“因为它是官方推荐”。真正的原因是:它把一个极其混乱的问题——模型架构百花齐放——收敛成了一份机器可读的约定。理解了这份约定,你就能解释后面遇到的绝大多数加载报错。
约定的力量:config.json 是模型的“身份证”
打开任何一个 Hugging Face 模型的仓库,你会看到一堆文件:.safetensors 权重、tokenizer.json、tokenizer_config.json、generation_config.json,以及一个通常只有几百字节的小文件——config.json。
很多人会跳过它,直接看 README。但这个文件才是整个机制的中枢。它是一个模型对自己结构的完整自述,内容大致是这样的(字段有删减):
json
{
  "architectures": ["Qwen2ForCausalLM"],   # 顶层封装类
  "model_type": "qwen2",                   # 架构族标识,最关键的一行
  "hidden_size": 896,                      # 隐藏层维度
  "num_hidden_layers": 24,                 # 堆多少层
  "num_attention_heads": 14,               # 注意力头数
  "num_key_value_heads": 2,                # KV 头数(GQA 分组)
  "intermediate_size": 4864,               # 前馈层中间维度
  "vocab_size": 151936,                    # 词表大小
  "max_position_embeddings": 32768         # 最大上下文长度
}这份文件解决了一个非常具体的问题:光有权重文件,你不知道该用哪种网络结构去接住它。 权重是一堆张量,张量的形状只有在对应的网络结构里才有意义。同样是 hidden_size=896 的一层,接在 Llama 的结构里和接在 BERT 的结构里,语义完全不同。
所以 Hugging Face 的做法是:让模型作者自己申报结构,让加载器按申报去查表。
model_type决定用哪个实现类。库内部维护了一张model_type → 模型类的映射表,qwen2指向 Qwen2 的实现,llama指向 Llama 的实现,deepseek_v2指向 DeepSeek 的实现。hidden_size、num_hidden_layers这些数值决定网络的“几何形状”。它们不是超参数,而是构造函数的入参——模型类拿到 config 之后,按这些数字把层一层层搭出来。architectures决定顶层用什么封装。同一个主干网络,套不同的头就是不同的任务:套因果语言模型头是ForCausalLM,套序列分类头是ForSequenceClassification。
三个 Auto 类就在这个约定上分工:
| 类 | 读哪些文件 | 产出什么 | 什么时候直接用它 |
|---|---|---|---|
AutoConfig | config.json | 一个描述结构的配置对象 | 想先探查模型规模、层数、上下文长度,不下载权重 |
AutoTokenizer | tokenizer.json / tokenizer_config.json / vocab.json | 分词器,负责文本与 token id 互转 | 几乎所有场景都需要它 |
AutoModel 系列 | config.json + 权重文件 | 已装配好、已加载权重的模型对象 | 需要自己控制生成循环、取 logits、做自定义推理 |
这张表里最容易被误解的是 AutoModel。它不是一个具体的模型类,而是一个分发器:它先读 config,看 model_type 是什么,然后去映射表里取出对应的类,再调用那个类的构造函数。你写的 AutoModelForCausalLM 只是“按任务类型筛过的分发器”——它只会在所有因果语言模型实现里挑,不会挑到一个分类模型。
这就解释了你将来一定会遇到的一个报错:
ValueError: The checkpoint you are trying to load has model type `xxx`
but Transformers does not recognize this architecture.这句话的意思不是“这个模型坏了”,而是“你装的 transformers 版本还不认识这个架构”。要么升级库,要么加上 trust_remote_code=True 让模型作者自带的实现代码来接管(后文会讲这个开关的风险)。看懂这句话,你就知道该往哪个方向修。
from_pretrained() 背后做了什么
from_pretrained() 看起来只是一行调用,实际包含四个动作。拆开看,很多“玄学问题”立刻变得可解释。
第一步:解析清单
它先向模型仓库请求一份文件清单,确认这次需要哪些文件:config.json、权重文件(可能是单个 .safetensors,也可能是多个分片加一个 model.safetensors.index.json)、分词器文件、生成配置文件。这一步只走 HTTP 元数据请求,不下载大文件。
第二步:落到本地缓存
下载下来的文件不会散落在你的项目目录里,而是统一进缓存。默认位置是 ~/.cache/huggingface/hub/,可以用环境变量 HF_HOME 改根目录,用 HF_HUB_CACHE 单独指定缓存目录。
缓存目录的结构值得看一眼:
~/.cache/huggingface/hub/
└── models--Qwen--Qwen2.5-0.5B-Instruct/
    ├── blobs/                 # 真正的内容,按哈希命名
    ├── refs/                  # 记录分支指向哪个 commit
    └── snapshots/
        └── <commit-hash>/     # 一个快照 = 一套用符号链接拼出的文件视图
            ├── config.json -> ../../blobs/...
└── model.safetensors -> ../../blobs/...这个设计有两个直接好处。第一,同一个文件不会下载第二次:内容按哈希寻址,只要哈希相同,无论是哪个模型、哪个版本引用它,本地只有一份。第二,版本可以共存且可复现:每个快照对应一个 commit,你在代码里锁定了 commit,就等于锁定了当时的完整模型,不会因为作者后来更新了仓库而行为漂移。
顺带解释一个很常见的现象:你明明删了模型目录,磁盘空间却没释放。因为删掉的只是 snapshots/ 下的符号链接,真正的数据在 blobs/ 里。
第三步:按 config 装配网络
AutoConfig 先读 config.json,拿到结构描述;然后分发器按 model_type 找到实现类,调用 模型类(config) —— 这一步里,网络被一层层搭出来,参数被随机初始化。
这里有一个很有用的分离接口:AutoModelForCausalLM.from_config(config)。它只做“按图纸盖房子”,不下载、不加载任何权重。你可以用它来估算模型参数量,也可以用它来验证一个自定义结构的显存占用,而不必先拖几十 GB 权重下来:
python
from transformers import AutoConfig, AutoModelForCausalLM

# 只读配置,不下载权重文件
config = AutoConfig.from_pretrained("Qwen/Qwen2.5-0.5B-Instruct")  # 模型名示意
print(config.model_type)            # qwen2:决定用哪个实现类
print(config.num_hidden_layers)     # 决定堆多少层

# 按配置搭一个同结构的网络,权重是随机初始化的
model = AutoModelForCausalLM.from_config(config)
print(sum(p.numel() for p in model.parameters()) / 1e9, "B 参数")这个对照能帮你建立一个准确的直觉:from_config 是盖房子,from_pretrained 是盖完再装修。 结构由 config 决定,能力由权重决定。
第四步:灌入权重
最后一步是把权重张量填进网络。大模型不可能放在单个文件里,所以权重会被切成多个分片,并用一个索引文件(model.safetensors.index.json)记录“哪个参数在哪个分片里”。加载器按索引把分片逐个读进来,按参数名匹配,填进对应的层。
加载结束后,如果出现两类警告,含义要分清楚:
missing_keys:网络里有参数没被权重填上。常见原因是模型结构与权重不匹配——比如你用ForSequenceClassification去加载一个基座模型,分类头就是缺的(这通常是有意的,你本来就要重新训它)。unexpected_keys:权重里有参数网络不认识。常见原因是版本错位,或者权重里带了训练时的额外状态(如优化器状态、量化缩放因子)。
这两类警告一般不会让程序崩溃,但会静默地改变模型行为。看到它们,不要当作噪音划过去。
一个能跑通的完整示例
理论讲完,跑一遍。先装依赖:
bash
pip install -U transformers torch accelerateaccelerate 不是必需项,但只要你用 device_map="auto" 让库自己分配设备,就需要它。
python
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

# 模型名示意,请以实际可用版本为准
MODEL_ID = "Qwen/Qwen2.5-0.5B-Instruct"

tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID,
    torch_dtype=torch.float16,   # 半精度:显存减半,速度更快
    device_map="auto",           # 自动分配到可用 GPU,装不下时溢到 CPU
)

messages = [
    {"role": "system", "content": "你是一个简洁的技术助手,回答不超过三句话。"},
    {"role": "user", "content": "用一句话解释什么是张量。"},
]

# 用模型自带的对话模板把消息列表渲染成模型期望的字符串
prompt = tokenizer.apply_chat_template(
    messages,
    tokenize=False,                  # 只渲染成字符串,先不转 id
    add_generation_prompt=True,      # 在末尾追加"该助手说话了"的提示
)

inputs = tokenizer(prompt, return_tensors="pt").to(model.device)

with torch.no_grad():                # 推理不需要梯度,省显存
    output_ids = model.generate(
        **inputs,
        max_new_tokens=128,
        do_sample=False,             # 贪心解码,结果更稳定
        temperature=None,            # 与贪心解码配合时显式置空,避免告警
        top_p=None,
    )

# 只解码新生成的部分,不要把 prompt 一起打印出来
new_tokens = output_ids[0][inputs["input_ids"].shape[-1]:]
print(tokenizer.decode(new_tokens, skip_special_tokens=True))
这段代码有四个容易被忽略、但会直接决定输出质量的细节。
第一,apply_chat_template 不是可选项。 指令微调模型在训练时见过一套特定的对话格式(各家模板不同),里面包含角色标记、分隔符、结束符。你手写 "用户:……\n助手:" 去拼,格式对不上,模型仍然能回答,但质量会明显下降——它是在“猜你想干什么”,而不是在“按训练时的规矩办事”。用模板,等于把这件事交还给模型作者。
第二,do_sample=False 和 temperature 是互斥的语义。 贪心解码取概率最高的 token,没有随机性;只有 do_sample=True 时,temperature、top_p、top_k 才生效。两者混用不会报错,只会让你以为调了参数、实际没生效。
第三,只解码新增的 token。 output_ids 里包含完整的输入序列。直接 decode(output_ids[0]) 会把你的 prompt 原样打印一遍,再接上回答——这是新手最常见的“输出格式怪怪的”原因。
第四,torch_dtype 要在加载时给,不是在加载后 .half()。 加载时指定,权重直接以半精度读入内存;加载后再转换,会先占用一份全精度显存。在显存紧张时,这个差别足以决定你能不能跑起来。
顺便说清这段代码的边界:它一次只处理一条请求,没有批处理,没有并发,没有 KV Cache 复用。用它验证效果没问题,用它扛线上流量是另一回事——那是 6.5 节推理引擎的战场。
pipeline():三十秒上手,也可能是三十秒的坑
如果你只是想快速验证一个想法,pipeline() 是最短的路径。它把分词器、模型、后处理三步打包成一个函数,你只需要给任务名:
python
import torch
from transformers import pipeline

# 中文情感二分类,模型名示意,请以实际可用版本为准
clf = pipeline(
    "text-classification",
    model="uer/roberta-base-finetuned-jd-binary-chinese",
    device=0 if torch.cuda.is_available() else -1,  # -1 表示 CPU
)

print(clf("物流很快,包装也很仔细,下次还会来买"))
# [{'label': 'LABEL_1', 'score': 0.99...}]
它替你做的事比看起来多:根据任务类型选合适的模型类、自动调用 tokenizer、把输出张量还原成人类可读的标签和分数。如果你连 model 参数都不给,它会用一个该任务的默认 checkpoint——方便,但也意味着你的实验结果依赖于“库作者当时的默认值”。
什么时候该用它:
- 批量打标、数据清洗、构建评测集这类“跑一遍看结果”的活。
- 作为 baseline:先用最简单的管线跑出分数,再决定要不要上更复杂的方案。
- 教学和演示:三十秒能出结果,比讲十分钟原理更有说服力。
什么时候它反而是坑:
| 你的需求 | pipeline() 的麻烦 |
|---|---|
| 精细控制生成参数(采样策略、惩罚项、logits 处理) | 参数要穿透 kwargs,拼错时静默失效 |
| 需要中间结果(logits、注意力权重、隐藏状态) | 输出已被后处理,拿不到原始张量 |
| 高并发线上服务 | 没有连续批处理,吞吐远低于专用推理引擎 |
| 排查问题 | 错误栈被包了一层,定位成本上升 |
| 结果可复现 | 省略 model 时会隐式下载默认模型,版本随时可能变 |
一句话概括:pipeline() 是给“我要一个结果”的人用的,不是给“我要控制过程”的人用的。 当你的需求从“跑通”变成“跑对、跑快、跑稳”,就该离开它,回到显式的 tokenizer 加 model 写法。
它和 PyTorch 的分工:发动机与变速箱
到这里可以回答一个常见的混淆:既然 Transformers 也能跑推理,那 PyTorch 到底还需要吗?
需要,而且两者的分工非常清晰。
| 层 | 负责什么 | 你直接接触的频率 |
|---|---|---|
| PyTorch | 张量运算、自动求导、CUDA 算子、设备与显存管理 | 低,但处处依赖 |
| Transformers | 模型结构定义、权重加载、生成循环、任务级接口 | 高,几乎每个脚本都会用到 |
PyTorch 是发动机:它提供马力,负责把矩阵乘法真正算出来。Transformers 是变速箱加通用接口:它把马力接到轮子上,并且让不同厂家的发动机舱都长成同一个样子。
这个类比能推出两个结论。第一,Transformers 不能替代 PyTorch——没有底层张量运算,它连一次矩阵乘法都做不了。第二,PyTorch 也不能替代 Transformers——没有它,你得为每个模型重写一遍网络定义,还得自己实现自回归生成循环。
更准确的一句话是:Transformers 不生产算力,它生产约定。 它的价值不在算法创新,而在把“加载一个模型”从“阅读理解作者代码”变成了“调用一个与模型无关的方法”。
避坑:四个高频问题
第一坑:模型下载卡住,进度条纹丝不动。 常见原因是网络到 Hugging Face 的连接不稳定。三条实用路径:(1) 设置 HF_ENDPOINT 指向社区维护的镜像站(注意这是第三方服务,可用性和内容一致性由对方保证,涉密场景不要用);(2) 在带宽充足的机器上用 hf download 预下载整个仓库,再整体拷贝到目标机器的缓存目录;(3) 完全离线时设 HF_HUB_OFFLINE=1,让库只读本地缓存、绝不发起网络请求——这同时也是排查“是不是在偷偷联网”的好办法。
第二坑:显存不够,加载到一半就 OOM。 按代价从低到高依次尝试:先改 torch_dtype=torch.float16 或 bfloat16(显存直接减半,质量损失通常很小);再用 device_map="auto" 让库把装不下的层放到 CPU(能跑,但会慢一个数量级);还不够,就上 8bit 或 4bit 量化加载(需要 bitsandbytes,且对平台和算子有要求)。最后才是换更小的模型——多数人跳过前三步就直接换模型,其实前两步往往就够了。
第三坑:trust_remote_code=True 到底是什么。 这个参数的含义是:允许执行模型仓库里自带的 Python 代码。它之所以存在,是因为总会有新架构跑在 transformers 的发版节奏前面,作者只能把自己的实现随仓库发布。所以它很实用,但它是一个“执行陌生人代码”的开关——性质和 curl | bash 属于同一类。合理的用法是:只在确实需要时打开;打开前把仓库里的 modeling_*.py、configuration_*.py 扫一遍;把依赖锁到具体 commit;在企业环境里放到隔离容器中跑。对来源不明的模型仓库,不要养成“报错就加 trust_remote_code”的习惯。
第四坑:版本不匹配。 transformers 的迭代节奏很快,新模型架构往往需要较新的版本才能识别。但反过来,升级也不是无痛的:生成接口的参数在多个大版本间有过调整,默认 dtype、默认 attention 实现也变过。老代码在新版本上“能跑但结果不一样”,比直接报错更难查。工程上的做法很朴素:在项目里锁版本(写进 requirements.txt),升级前先跑一遍自己的回归用例。匹配比最新更重要——这条在 6.2.1 讲 PyTorch 时说过一次,在这里同样成立。
小结
Transformers 做的事情,说到底只有一件:把“加载模型”这个动作,从依赖具体架构的手工活,变成了与模型无关的标准化调用。它靠的不是更强的算法,而是一份被整个生态接受的约定——config.json 申报结构,分发器查表选类,from_pretrained() 完成下载、缓存、装配、灌权重四步。
理解了这四步,你就能解释那些看起来毫无头绪的报错:认不出架构是版本问题,missing_keys 是结构问题,下载卡住是网络问题,OOM 是精度与设备分配问题。问题还是那些问题,但你知道了该往哪看。
不过到这一节为止,我们处理的对象始终是文字——token 进,token 出。如果把输出换成像素呢?同样是 Hugging Face 生态,还有另一个库,它面对的是完全不同形态的计算:不是一次前向传播,而是几十次迭代去噪。下一节我们看 Diffusers。
参考:Hugging Face Transformers 官方文档 https://huggingface.co/docs/transformers
6.2.5 Diffusers:像素与艺术的生成引擎
上一节的结尾留下了一个问题:如果输出不是文字,而是像素呢?
文字生成的计算形态很好理解——模型一次前向传播,吐出下一个 token,把它接回输入,再前向一次。生成的是一串序列,每一步的产物就是一个字。
图像生成不是这样。它没有“下一个像素”的概念,也不是一次算完的。一张图要经过几十次迭代才浮现出来,每一次迭代的结果都依赖上一次,中间过程存在显存里、而不是存在文本里。这是完全不同类型的一项计算,也正因如此,它需要一个单独的库来管理。
这个库就是 Diffusers。它和 Transformers 出自同一个组织,遵守同一套约定,但解决的问题域几乎不重叠。
一句话讲清扩散模型在干什么
不谈数学,只讲流程。扩散模型(Diffusion Model)的思路可以拆成两半:
训练时,学“怎么加噪”。 拿一张清晰图片,按随机强度往里掺噪声,一直掺到面目全非。然后让神经网络看这张糊掉的图,猜“你刚才加了什么噪声”。猜错就调参数,猜对就记住。反复几百万次之后,网络学会了一件很具体的事:给定一张带噪图,判断噪声长什么样。
推理时,就反过来用。 从一张纯随机噪声开始,让网络猜“这里面有哪些噪声”,然后把猜出来的噪声减掉一点点。得到的图干净一点点,但仍然很糊。再猜一次、再减一点,重复几十次,噪声被一层层剥离,一张图就浮现出来了。
关键认知在这里:模型学的不是“图像长什么样”,而是“噪声往哪个方向走”。 它从来没见过“完整的猫”,它只学过“这张图里还剩下多少猫、多少噪点”。所谓生成,是对噪声的一次次清理。
那提示词(prompt)是怎么起作用的?文本先被一个文本编码器压成向量序列,然后通过交叉注意力(cross-attention)注入到去噪网络的每一层里。于是每一步去噪,网络不只在问“这里的噪声是什么”,还在问“按照这句话的要求,这里应该是什么”。文本不是限制条件,而是一个持续存在的偏置。
把两种生成放在一起看,差异就非常清楚:
| 维度 | 文本生成 | 图像生成 |
|---|---|---|
| 基本单位 | token(离散) | 像素/隐空间特征(连续) |
| 计算形态 | N 次前向,每次产出一个 token | N 次前向,每次整体更新一张图 |
| 循环依赖 | 上一步的输出拼进输入 | 上一步的整张图作为下一步的输入 |
| 中间状态 | KV Cache | 隐空间张量(latent) |
| 可控性抓手 | 采样参数(temperature、top_p) | 采样器、引导强度、步数 |
| 一次调用的典型耗时 | 毫秒到秒级 | 秒到十秒级(取决于步数与分辨率) |
这张表解释了一个常见的困惑:为什么调图像模型的“参数”感觉和调文本模型完全不一样?因为两者优化的对象不同——文本在调“怎么选下一个词”,图像在调“怎么走完这条去噪路径”。
Diffusers 是什么:把去噪流水线拆成可替换的零件
如果只把 Diffusers 理解成“调用 Stable Diffusion 的库”,会低估它。更准确的定位是:它是一个零件库,把一条扩散推理管线拆成了若干可替换的组件。
一条典型的文生图管线由这些零件组成:
- tokenizer + text_encoder:把 prompt 变成向量。常见的是 CLIP 文本编码器,较新的模型会用 T5 或双编码器组合。
- 去噪主干:早期是 UNet,近两年的新模型越来越多改用 DiT(Diffusion Transformer)这类纯 Transformer 结构。
- scheduler:控制每一步“减多少噪声”的算法。它不参与训练,只决定采样轨迹。
- VAE:负责在像素空间与隐空间之间来回编解码。扩散过程通常不在原图上做,而是在压缩后的隐空间做,这样计算量能降一到两个数量级。
- Pipeline:把上面几件串起来,对外暴露一次
__call__。
“零件库”这个定位带来一个很实际的好处:同一个模型权重,可以配不同的 scheduler、挂不同的 LoRA、加不同的控制模块(ControlNet、IP-Adapter),而不需要重新训练任何东西。 这在文本模型里很难想象——你没法给一个语言模型换一套“采样器”就换掉它的文风(虽然采样参数确实会影响风格,但机制完全不同)。
DiffusionPipeline 是最上层的门面。它的 from_pretrained() 会读模型仓库里的 model_index.json,据此决定该装配哪些零件、用哪个 Pipeline 类。这和上一节讲的 config.json 驱动分发,是同一个思路——用一份声明文件把“结构”和“代码”解耦。
一个能跑通的示例
bash
pip install -U diffusers transformers accelerate torch safetensorspython
import torch
from diffusers import DiffusionPipeline

# 模型名示意,请以实际可用版本为准
MODEL_ID = "stabilityai/stable-diffusion-xl-base-1.0"

pipe = DiffusionPipeline.from_pretrained(
    MODEL_ID,
    torch_dtype=torch.float16,     # 半精度,显存约减半
    use_safetensors=True,
)
pipe = pipe.to("cuda")

# 固定随机种子,让同一组参数能复现同一张图
generator = torch.Generator(device="cuda").manual_seed(42)

image = pipe(
    prompt="一间靠窗的书房,午后阳光斜射在木桌上,桌上摊开一本翻旧的技术书,写实摄影风格",
    negative_prompt="模糊,低质量,手指畸形,水印",
    num_inference_steps=30,        # 去噪步数
    guidance_scale=6.5,            # 提示词引导强度
    generator=generator,
).images[0]

image.save("study_room.png")
这段代码里,真正决定结果的不只是 prompt,还有三个数字:num_inference_steps、guidance_scale,以及你选的 scheduler。下面逐个说清它们的物理含义——不理解这三个旋钮,调参就只是在碰运气。
三个旋钮:scheduler、guidance_scale、steps
scheduler:换采样器,为什么出图就变了
scheduler 决定的是从噪声走到图像的路径怎么走。给定同一个模型权重,不同 scheduler 会用不同的数值方法去逼近同一个目标分布:DDIM 走的是确定性的一步一跳;Euler 系列用一阶数值积分;DPM-Solver 系列用高阶求解器,号称二三十步就能达到老方法上百步的效果。
所以换 scheduler 之后,出图的构图大体还在,但质感、细节密度、锐度会变。这不是模型变了,而是“走路方式”变了——同一座山,从不同路线爬上去,看到的风景不完全一样。
python
from diffusers import DPMSolverMultistepScheduler, EulerDiscreteScheduler

# 换成 DPM-Solver++:常见做法是 20~30 步就能出可用的图
pipe.scheduler = DPMSolverMultistepScheduler.from_config(pipe.scheduler.config)

# 或者换成 Euler:风格通常更"实",但需要更多步数才稳定
# pipe.scheduler = EulerDiscreteScheduler.from_config(pipe.scheduler.config)
注意 from_config(pipe.scheduler.config) 这个写法:它继承原 scheduler 的配置(如 beta 调度表、预测类型),只替换算法本身。如果你直接实例化一个新 scheduler,容易把不兼容的参数带进去,结果就是出图全糊或者全黑。
一个实用的经验:新模型优先用它自带的 scheduler。 模型作者在训练和评测时用的就是那一套;换成别的算法可能出图,但已不在作者验证过的分布里了。
guidance_scale:为什么它既是“听话程度”,也是“崩坏开关”
guidance_scale 对应无分类器引导(Classifier-Free Guidance)。它的做法是每次去噪算两遍:一遍带 prompt,一遍不带 prompt,然后按下面的方式组合:
最终预测 = 无提示预测 + scale × (有提示预测 − 无提示预测)直观理解:(有提示 − 无提示) 这一项表示“这句话想让画面往哪个方向偏”,scale 就是“把这种偏移放大多少倍”。
| 取值区间 | 现象 |
|---|---|
| 1~3 | 提示词几乎不起作用,画面自由发挥,常常偏离描述 |
| 5~8 | 一般模型最舒服的区间,既听话又不僵硬 |
| 10~15 | 颜色过饱和、边缘出现硬边,构图开始扭曲 |
| >15 | 典型的“炸图”:对比度极高、结构崩坏、人物肢体错乱 |
所以它不是“越大越好”的参数。它本质上是在“遵守提示词”和“保持图像自然”之间做权衡,而且这个权衡没有普适最优值——不同模型、不同风格偏好,最佳区间都不一样。
steps:边际收益递减得很快
步数控制迭代次数。少步数省时间但细节不足,多步数细节更完整——但收益很快见底。
| 步数 | 相对质量 | 耗时 | 适用场景 |
|---|---|---|---|
| 10~15 | 构图已成型,细节粗糙 | 低 | 大批量筛查创意、快速出草稿 |
| 20~30 | 细节完整,通常足够交付 | 中 | 绝大多数生产场景 |
| 50+ | 与 30 步差异很小 | 高 | 极少需要,除非用老式 sampler |
一个容易被忽略的事实:步数和 scheduler 是耦合的。 同一个 30 步,在 DDIM 下可能还不够,在 DPM-Solver++ 下已经过采样。所以调参不要孤立地动一个数字。
把这三点合起来看,能得出一个更重要的结论:这三个旋钮改变的是“生成过程”,而不是“模型知识”。 它们不会让模型学会新的画风,只会改变它在已有能力空间里的落点。真正的“定制”,需要动权重——那就是下一节的 LoRA。
显存三件套:让消费级显卡也能跑
图像生成是显存杀手。一条 SDXL 管线在 float32 下要占十几 GB,再加上去噪过程中的中间激活,24 GB 的卡也可能吃紧。三个手段按顺序上:
python
# 手段一:半精度(最划算,几乎无代价)
pipe = DiffusionPipeline.from_pretrained(MODEL_ID, torch_dtype=torch.float16)

# 手段二:模型分阶段卸载到 CPU
# 注意:用了这个就不要再 .to("cuda"),否则会互相打架
pipe.enable_model_cpu_offload()

# 手段三:注意力切片,把注意力的显存峰值压平
pipe.enable_attention_slicing()

# 可选:VAE 分块解码,专治高分辨率出图时的解码 OOM
pipe.enable_vae_tiling()| 手段 | 省的是什么 | 代价 |
|---|---|---|
| 半精度(fp16/bf16) | 权重与激活的位宽 | 极小,个别模型在 fp16 下会有数值溢出,改用 bf16 |
enable_model_cpu_offload() | 让不参与当前计算的模块驻留内存 | 模块来回搬运,速度明显变慢 |
enable_attention_slicing() | 注意力的显存峰值 | 计算被切成小块,速度略降 |
enable_vae_tiling() | 高分辨率解码时的显存峰值 | 分块边界可能出现细微接缝 |
一个必须强调的顺序问题:enable_model_cpu_offload() 和 pipe.to("cuda") 是互斥的两种策略。前者要求管线自己管理设备位置,后者把整个管线钉在 GPU 上。同时写,轻则卸载失效,重则报设备不一致的错。
enable_model_cpu_offload() 需要 accelerate 支持——这里又一次出现了上一节讲过的 Accelerate。它不是可有可无的附属品,而是整个 Hugging Face 生态里“设备编排”的公共底座。
LoRA:为什么视觉定制几乎都走 LoRA
假设你要做一个固定风格的插画生成服务:某种特定的线条、某种固定的上色习惯。用 prompt 描述当然可以,但你很快会发现两个问题:描述不稳定(同一个 prompt 每次出的风格有漂移),描述不完备(有些风格特征根本没法用语言讲清楚)。
那就训练。问题是怎么训。
全量微调一条 SDXL 管线,需要更新 UNet(约 2.6B 参数)加两个文本编码器,还要保存优化器状态。显存需求、训练时间、存储成本三项都很难看。更致命的是每份定制都要产出一份完整权重:你有十个客户、十种风格,就要存十份几 GB 的模型,部署时还要为每份权重单独起一个进程。
LoRA(Low-Rank Adaptation)的做法是:冻结原模型,只在注意力的线性层旁边挂一对小矩阵。 原来要学的增量是 ΔW(一个巨大的矩阵),LoRA 把它近似拆成 B×A 两个小矩阵的乘积,秩 r 通常取 4 到 64。这样一来,可训练参数从几十亿降到几百万,训练可以在单张消费级卡上完成,产物只有几十到几百 MB。
python
# 加载一个风格 LoRA(路径或仓库名示意)
pipe.load_lora_weights("./loras/ink_sketch_style")

# 多个 LoRA 叠加时,可以分别调权重
# pipe.set_adapters(["ink_sketch_style", "warm_tone"], adapter_weights=[0.8, 0.4])
几个工程上的好处随之而来:
- 可插拔:一个基础模型 + N 个 LoRA,替代 N 份完整权重。存储和部署成本降到 1/N 量级。
- 可组合:风格 LoRA 与光影 LoRA 可以叠加,权重可调,等于把“风格”变成了连续可调的参数。
- 可回退:卸载即恢复原模型,不会污染底模。
这也是为什么视觉定制生态几乎一边倒地走 LoRA:它把“定制”从“训练一个新模型”变成了“给模型挂一个插件”。对一个要服务多客户、多风格的系统来说,这个差别不是优化,而是可行性问题。
同源性:这不是另一套技术栈
讲到这里,如果只看表面,Diffusers 像是另一个世界:scheduler、latent、VAE、guidance,每个词都陌生。
但把概念对齐之后,你会发现它和上一节讲的东西几乎是同构的:
| 概念 | 文本模型(Transformers) | 图像模型(Diffusers) |
|---|---|---|
| 底层算力 | PyTorch | PyTorch(同一个) |
| 加载入口 | from_pretrained() | from_pretrained()(同一个命名约定) |
| 结构声明 | config.json | model_index.json + 各组件自己的 config |
| 权重格式 | .safetensors 分片 | .safetensors 分片(同一套) |
| 精度控制 | torch_dtype | torch_dtype(同一个参数) |
| 设备编排 | device_map="auto" / Accelerate | enable_model_cpu_offload() / Accelerate |
| 分发渠道 | Hugging Face Hub 缓存 | Hugging Face Hub 缓存(同一个目录) |
| 一次性调用 | model.generate() | pipe(...) |
| 轻量定制 | LoRA / QLoRA | LoRA |
这张表想说明的结论只有一句:Diffusers 不是一个平行的技术世界,它只是把同一套工程约定用在了另一种计算形态上。
你已经会的那些东西——怎么看缓存、怎么控精度、怎么用 device_map、怎么判断 OOM 是权重问题还是激活问题、trust_remote_code 意味着什么——在这里全部通用。需要新学的,只有“这条流水线有哪几个零件、三个旋钮各管什么”这一层。
这也解释了为什么 6.5 节讲推理引擎时,文本和视觉会被分成两条路线:不是技术栈不同,而是瓶颈位置不同——文本推理的复杂度在“同时服务多少请求”,视觉推理的复杂度在“一条管线有几步、每步占多少显存”。
小结
Diffusers 的价值不在于它实现了扩散模型,而在于它把一个原本高度耦合的过程拆成了可替换的零件,并用和 Transformers 一致的约定把这些零件组织起来。三个旋钮(scheduler、guidance_scale、steps)控制的是生成路径;显存三件套控制的是能不能在有限的卡上跑起来;LoRA 控制的是定制成本。
而这一切之所以学起来不算吃力,是因为它站在同一个 PyTorch 上,用着同一个 from_pretrained,读着同一份 Hugging Face 缓存。
模型能在本地跑了,画面也能生成了。但真实的系统里,绝大多数时候你不是在自己机器上跑模型,而是通过一个接口去访问别人(或别的机器)上的模型。接口长什么样,决定了你的代码能不能换模型不改一行。下一节看三种主流接口格式的真实差异。
参考:Hugging Face Diffusers 官方文档 https://huggingface.co/docs/diffusers
6.2.6 大模型访问的三种标准接口格式
前面五节讲的是“怎么在自己机器上把模型跑起来”:PyTorch 提供算力,Datasets 搬数据,Accelerate 管多卡,Transformers 统一加载,Diffusers 管像素。
但真实的系统里,你很少直接在自己进程里持有模型。绝大多数时候,你是通过一个 HTTP 接口去访问别人机器上的模型——可能是云厂商的 API,可能是公司内部用 vLLM 起的推理服务,也可能是你自己电脑上跑的 Ollama。
这时候,接口的“形状”就变成了架构里最贵的一个决定。原因很直接:模型是可以换的,接口一旦写进代码就不好换了。 你的应用里会有几十处调用、一堆错误处理、一套重试逻辑、若干工具定义——它们全部依附在某一种请求格式上。选错了格式,换模型就意味着改一遍业务代码。
到 2026 年,业界形成了三套并行的接口标准。它们不是三个竞争版本的同一个东西,而是三种不同的设计取向。
OpenAI Chat Completions:为什么它成了事实标准
先看结构。一次调用里最核心的参数只有两个:模型和消息列表。
python
from openai import OpenAI

client = OpenAI()   # 客户端怎么指向不同后端,后面会说

resp = client.chat.completions.create(
    model="gpt-4o",                          # 用哪个模型
    messages=[                               # 对话,一个数组
        {"role": "system",    "content": "你是一个简洁的技术助手。"},
        {"role": "user",      "content": "什么是张量?"},
        {"role": "assistant", "content": "张量是多维数组的统称。"},
        {"role": "user",      "content": "那标量算吗?"},
    ],
)
messages 里可以出现四种 role:
| role | 谁写的 | 作用 |
|---|---|---|
system | 开发者 | 设定身份、规则、输出格式,优先级最高 |
user | 终端用户 | 提问、给材料 |
assistant | 模型 | 历史回复;也承载工具调用请求 |
tool | 你的程序 | 工具执行结果,回填给模型 |
这里藏着一个非常关键的认知,很多人用了很久 API 才真正想明白:大模型服务是无状态的,多轮对话是“每次把历史重放一遍”。
你在网页上聊天时感觉模型“记得刚才说过什么”,其实是前端每次请求都把完整历史打包发了过去。assistant 这个 role 存在的意义就是让你能把模型之前说过的话也放回上下文里。理解这一点,你才会明白为什么长对话会让 token 费用线性上涨,也才会明白为什么“上下文工程”会成为一门独立的功夫(第 5 章讲过这件事的两个方向:塞进提示词,或者微调进权重)。
除 messages 之外,还有两个能力绕不开:
流式输出(stream=True)。不开流式,你要等模型把整段话生成完才能收到响应,首字延迟等于总生成时间。开了流式,服务端用 SSE(Server-Sent Events)一小段一小段推 delta:
python
stream = client.chat.completions.create(
    model="gpt-4o",
    messages=[{"role": "user", "content": "写一段 50 字的产品介绍"}],
    stream=True,
)

for chunk in stream:
    delta = chunk.choices[0].delta
    if delta.content:                 # 有些 chunk 只带 role,content 为空
        print(delta.content, end="", flush=True)
注意 delta 和 message 的区别:非流式返回的是完整的 message,流式返回的是增量 delta。很多“流式接好了但输出重复”的 bug,就是把两者混用了。
工具调用(tools / tool_calls)。这是让模型“动手”的入口。你声明一组函数签名,模型在需要时返回一个结构化的调用请求,而不是直接给文本:
python
tools = [{
    "type": "function",
    "function": {
        "name": "get_weather",
        "description": "查询指定城市的当前天气",
        "parameters": {
            "type": "object",
            "properties": {"city": {"type": "string", "description": "城市名"}},
            "required": ["city"],
        },
    },
}]

resp = client.chat.completions.create(
    model="gpt-4o",
    messages=[{"role": "user", "content": "北京现在多少度?"}],
    tools=tools,
)

call = resp.choices[0].message.tool_calls[0]
print(call.function.name)        # get_weather
print(call.function.arguments)   # {"city": "北京"} —— 注意是字符串,需要自己 json.loads
整个往返是两轮:第一轮模型返回 tool_calls,你的程序在本地执行真正的函数,然后构造一条 role="tool" 的消息(带上 tool_call_id)回填,再发第二轮请求,模型才基于结果给出自然语言回答。这个两轮结构是所有 Agent 框架的地基,第 7 章会讲它为什么不够用、以及 MCP 怎么补。
那为什么这套格式会成为事实标准?原因不在技术优越性,而在一个工程细节:它把“协议”和“地址”彻底分离了。
python
from openai import OpenAI

client = OpenAI(
    api_key="任意值",
    base_url="http://localhost:11434/v1",   # 本地 Ollama
    # base_url="http://localhost:8000/v1",  # 本地 vLLM
    # base_url="https://api.deepseek.com/v1",
    # base_url="https://api.moonshot.cn/v1",
)
base_url 一改,同一份代码就能指向 Ollama、vLLM、DeepSeek、Kimi、通义、以及各种自建网关。这个“只改一个字符串”的便利性,让几乎所有推理框架都主动实现了 OpenAI 兼容层——不是因为它最好,而是因为不改就没人用。事实标准往往是这么形成的。
但必须提醒一句:“兼容 OpenAI”和“等价于 OpenAI”是两件事。 各家在兼容层上都有自己的缺口:
- 推理模型的思考过程是否通过额外字段返回(各家命名不一样,有的在
reasoning_content,有的在 content block 里)。 - 工具调用能否并行、
tool_call_id是否严格回传。 - 多模态消息里图片字段的细节格式。
- 采样参数的取值范围与默认值。
所以工程上有一条硬纪律:把“兼容”当成 80% 可用,剩下 20% 用能力探测去补。 上线前对每个后端跑一遍你自己的验证用例,而不是假设“都是 OpenAI 格式所以都一样”。
Anthropic Messages:同一件事,更严格的结构
Anthropic 的 Messages API 表面上和 OpenAI 很像——也是 model 加一组消息。但几处结构性差异,会让直接照抄的代码跑不起来。
差异一:system 是顶层参数,不在 messages 里。
python
import anthropic

client = anthropic.Anthropic()

msg = client.messages.create(
    model="claude-sonnet-4-5",          # 示意,请以官方模型列表为准
    max_tokens=1024,                   # 必填,不填直接报错
    system="你是一个图片描述助手,回答控制在两句话内。",   # 顶层独立参数
    messages=[
        {"role": "user", "content": "这张图里有什么?"},
    ],
)
这个设计选择不是随意的。在 OpenAI 的格式里,system 只是 messages 数组中的一项,理论上可以出现在任意位置、甚至出现多条。Anthropic 把它提成顶层参数,等于在协议层面声明:系统指令不是对话的一部分,它是这一整轮对话的前置约束。 对于要严格管理“哪些内容可缓存、哪些内容可被用户覆盖”的系统,这个区分很有价值。
差异二:content 不是字符串,而是 block 数组。
python
msg = client.messages.create(
    model="claude-sonnet-4-5",
    max_tokens=1024,
    system="你是一个图片描述助手。",
    messages=[{
        "role": "user",
        "content": [
            {"type": "image", "source": {
                "type": "base64",
                "media_type": "image/png",
                "data": IMAGE_B64,
            }},
            {"type": "text", "text": "这张图里有什么?"},
        ],
    }],
)

print(msg.content[0].text)   # 返回的 content 同样是 block 数组
常见的 block 类型有 text、image、tool_use、tool_result,新模型还会返回 thinking 类型的块。这个设计带来一个直接后果:工具调用不再是一个独立的 role,而是消息内容里的一种块。
在 OpenAI 的模型里,工具调用是三条角色分明的消息:assistant 带 tool_calls、你回一条 role="tool"、模型再回复。在 Anthropic 的模型里,是同一个 messages 数组里的 block 序列:assistant 的 content 里含 tool_use 块,user 的 content 里含 tool_result 块。语义相同,结构不同——这也是为什么“写一个通用适配层”比看上去难。
差异三:cache_control 把“可缓存”显式标出来。
长系统提示(比如一份几千 token 的产品手册)在每次请求里都会重复传输、重复计算。Anthropic 的做法是让你用 cache_control 标注“从开头到这里,这一整段可以缓存”:
python
system = [{
    "type": "text",
    "text": LONG_PRODUCT_MANUAL,
    "cache_control": {"type": "ephemeral"},
}]这里有一个容易踩错的地方:缓存按前缀匹配,所以顺序决定命中率。 稳定不变的内容(系统提示、知识库、工具定义)必须放在前面,每次都变的内容(用户这一轮的提问)必须放在后面。顺序反了,缓存永远不命中,你花了钱却什么也没省下。
逐项对照:
| 维度 | OpenAI Chat Completions | Anthropic Messages |
|---|---|---|
| 系统提示 | messages 里 role="system" 的一条 | 顶层 system 参数 |
| 内容形态 | content 可以是字符串或数组 | content 一律是 block 数组 |
| 图片输入 | {"type": "image_url", "image_url": {...}} | {"type": "image", "source": {...}} |
| 工具声明 | 顶层 tools,type="function" | 顶层 tools,带 input_schema |
| 工具调用 | assistant 的 tool_calls + role="tool" 回复 | 消息内部的 tool_use / tool_result 块 |
| 最大输出 | 可选(有默认值) | max_tokens 必填 |
| 缓存控制 | 由服务端自动处理 | 通过 cache_control 显式标注 |
| 流式事件 | SSE,delta 增量 | SSE,按事件类型区分(内容块开始/增量/结束) |
| 角色约束 | system/user/assistant/tool | user 与 assistant 交替(工具块嵌在内容里) |
看完这张表,可以给一个判断:OpenAI 的格式更“宽容”,Anthropic 的格式更“精确”。 前者适合快速接入、生态最广;后者在长上下文、工具密集、需要精细控制成本的场景里,结构上的约束反而帮你少犯错。
Google Gemini:把“实时”做进协议
如果只有前面两套,你会得出一个印象:接口之争就是“谁的消息格式更好用”。但 Gemini 的 Live API 展示了另一个维度——它解决的不是“怎么发一次请求”,而是“怎么维持一段实时会话”。
先说清它的定位,避免误解:Live API 不是 Chat Completions 的替代品。 一次性问答、批量处理、结构化输出,用普通的 generate_content 就够了,格式上和前两家大同小异(依赖:pip install google-genai):
python
# 示意:设备侧(麦克风采集 / 音频播放 / 打断)未实现,需按平台 SDK 补齐
import os

from google import genai
from google.genai import types

client = genai.Client(api_key=os.environ["GEMINI_API_KEY"])   # 先 export GEMINI_API_KEY=...

with open("photo.png", "rb") as f:
    image_bytes = f.read()

resp = client.models.generate_content(
    model="gemini-2.5-flash",       # 示意,请以实际可用版本为准
    contents=[
        types.Part.from_bytes(data=image_bytes, mime_type="image/png"),
        "这张图里有什么?",
    ],
)
print(resp.text)
Live API 走的是另一条路:基于 WebSocket 的双向流式。你持续上行音频分片或视频帧,服务端持续下行音频分片或文本,两边同时进行,没有“请求—等待—响应”的边界。
python
import asyncio
from google import genai
from google.genai import types

async def main():
    client = genai.Client(api_key="...")
    config = types.LiveConnectConfig(response_modalities=["AUDIO"])

    async with client.aio.live.connect(model="gemini-2.5-flash", config=config) as session:

        async def pump_microphone():
            # 伪代码:持续采集麦克风,按 16kHz PCM 分片上行
            while True:
                chunk = await read_mic_chunk()
                await session.send_realtime_input(
                    audio=types.Blob(data=chunk, mime_type="audio/pcm;rate=16000")
                )

        async for message in session.receive():
            content = message.server_content
            if content is None:
                continue
            # 用户打断:立刻停止播放并清空缓冲
            if content.interrupted:
                stop_playback()
                continue
            if content.model_turn:
                for part in content.model_turn.parts:
                    if part.inline_data:
                        play_audio(part.inline_data.data)

asyncio.run(main())
这段代码里最值得注意的是 interrupted。在文本聊天里,用户想打断模型,只能等它说完或者手动停止。而在语音对话里,“等模型说完”是不可接受的——你说了半句发现它理解错了,必须能立刻打断它,而且它要知道自己被打断了,不能继续把那段已经没人听的话生成完。
这就是所谓“打断(interruption)语义”:服务端检测到用户开始说话,立即停止当前生成,向下行推送一个中断标记,客户端的播放器收到后清空缓冲。这个机制在 SSE 那种单向流里做不出来——单向流只能“推”,没办法让客户端的状态和服务端的生成节奏实时对齐。
所以三者的定位,可以这样摆:
| 接口 | 交互形态 | 解决的问题 | 不擅长什么 |
|---|---|---|---|
| OpenAI Chat Completions | 请求—响应(可流式) | 通用对话、工具调用、生态兼容 | 真正的实时双向;它是“一问一答” |
| Anthropic Messages | 请求—响应(可流式) | 长上下文、精细缓存、工具密集任务 | 同样不是实时会话协议 |
| Gemini Live API | WebSocket 双向流 | 实时音视频对话、打断、低延迟 | 一次性批处理;接入复杂度更高 |
一句话:Live API 补的是“实时对话”这个当时没人覆盖的场景,不是来取代前两家的。
同一件事,三种写法
差异讲理论容易飘,放在一起看最清楚。同一件事:给一张图,问一句“这张图里有什么”。
OpenAI 写法:图片是 messages 里 user 内容数组中的一个元素。
python
from openai import OpenAI

client = OpenAI()

resp = client.chat.completions.create(
    model="gpt-4o",          # 示意
    messages=[
        {"role": "system", "content": "你是一个图片描述助手,回答两句话以内。"},
        {"role": "user", "content": [
            {"type": "text", "text": "这张图里有什么?"},
            {"type": "image_url", "image_url": {"url": f"data:image/png;base64,{IMAGE_B64}"}},
        ]},
    ],
)
print(resp.choices[0].message.content)
Anthropic 写法:system 提到顶层;图片走 source 字段;返回的也是 block 数组。
python
import anthropic

client = anthropic.Anthropic()

msg = client.messages.create(
    model="claude-sonnet-4-5",   # 示意
    max_tokens=512,
    system="你是一个图片描述助手,回答两句话以内。",
    messages=[{
        "role": "user",
        "content": [
            {"type": "image", "source": {
                "type": "base64",
                "media_type": "image/png",
                "data": IMAGE_B64,
            }},
            {"type": "text", "text": "这张图里有什么?"},
        ],
    }],
)
print(msg.content[0].text)
Gemini 写法:图片和文本平铺在一个 contents 数组里,没有 role 数组的概念。
python
from google import genai
from google.genai import types

client = genai.Client()
IMAGE_BYTES = open("photo.png", "rb").read()   # 与上面两版读的是同一张图

resp = client.models.generate_content(
    model="gemini-2.5-flash",    # 示意
    contents=[
        types.Part.from_bytes(data=IMAGE_BYTES, mime_type="image/png"),
        "这张图里有什么?",
    ],
)
print(resp.text)
三份代码放在一起,差异一目了然:
| 看什么 | OpenAI | Anthropic | Gemini |
|---|---|---|---|
| system 放哪 | messages 里的一条 | 顶层参数 | 在 contents 里写自然语言,或用系统指令参数 |
| 图片怎么给 | image_url(URL 或 data URI) | source(base64 或 url) | Part.from_bytes(原始字节) |
| 返回怎么取 | choices[0].message.content | content[0].text | resp.text |
| 必填项 | model、messages | model、max_tokens、messages | model、contents |
| 感觉 | 数组套数组,宽松 | 结构严谨,块式建模 | 最扁平,偏“多模态输入列表” |
注意一个细节:三份代码里,模型的指定方式都一样(一个字符串),但取结果的方式完全不同。这就是适配层要解决的核心问题——不是把请求转过去,而是把响应结构也归一化回来。
工程判断:选哪个,怎么抽象
如果你的应用只用一个模型厂商,结论很简单:用它自己的官方 SDK。少一层抽象就少一层 bug,也能第一时间用到它的新特性(缓存、思考过程、批处理折扣)。为了“将来可能换模型”而先套一层自研适配层,多数时候是提前优化。
如果你要接多个模型(常见场景:主力用一家、便宜任务用另一家、私有数据走本地),那就需要一个网关层。这里有两个层次的选择:
- 轻量做法:用现成的协议统一层。本章 6.5.6 会讲 LiteLLM 这类方案——它的思路是把上百个后端都包装成 OpenAI 格式,你的业务代码只写一套。
- 重量做法:自建网关,自己定义内部中间表示和路由策略。
不管走哪条路,有三条经验值得先记住:
第一,不要把内部中间表示设计成“最小公倍数”。 一个只保留 role 和纯文本 content 的抽象层,会立刻丢掉工具调用、图片、缓存标记、思考过程这些真正值钱的能力。正确的做法是:内部结构保留“块”的概念,各家特有字段放进扩展位置,转换时能映射就映射,映射不了就显式降级,而不是悄悄丢掉。
第二,把“能力”当数据,而不是当假设。 你的网关里应该有一张表,记录每个后端支持什么:流式、工具调用、并行工具、图片输入、JSON 模式、缓存、最大上下文。路由时先查表,再决定要不要降级——比如目标模型不支持并行工具,就把多个 tool_calls 拆成串行两轮。
第三,工具调用必须保留原始标识。 tool_call_id、tool_use 的 id、block 顺序,这些看起来是细节,实际是协议正确性的一部分。做格式转换时把它们弄丢,会出现“模型说它调了工具,但结果对不上”的诡异 bug,而且极难定位。
顺带回答一个常被问到的问题:既然 OpenAI 格式已经成了事实标准,为什么另外两套还活着,没有人做一次彻底统一?
因为它们优化的目标根本不同。Chat Completions 优化的是“通用性”——字段宽松、易实现、谁都能兼容。Messages 优化的是“长上下文的经济性”——把可缓存段、工具块、思考块都变成一等公民,让服务端能精确地做前缀复用。Live API 优化的是“端到端延迟”——为此它必须换掉 HTTP 请求响应模型,改用全双工长连接。
这三个目标互相牵制,硬塞进一套协议里,结果一定是每一头都做不好。所以更现实的格局是长期并存,由网关层承担翻译工作——这也是为什么“协议适配”在 2026 年会变成一项独立的工程能力。
一句话收束本节:接口格式不是通信细节,它是架构的耦合点。 选它的标准不是“哪个更先进”,而是“我的系统会被它锁多深”。
三种格式讲完,模型已经能被稳定调用了。但一个只会“回答问题”的模型,和一个能“动手做事”的 Agent,中间还差一层东西——工具怎么被暴露、权限怎么被约束、多个 Agent 怎么协作。下一节看这一层。
参考:
- OpenAI Chat Completions 接口文档 https://platform.openai.com/docs/api-reference/chat
- Anthropic Messages 接口文档 https://docs.anthropic.com/en/api/messages
- Google Gemini Live API 文档 https://ai.google.dev/gemini-api/docs/live
6.2.7 Agent 交互模式:MCP、OpenClaw 与 Claude Code
前面六节,我们解决的都是“模型怎么被调用”:怎么在本机加载、怎么生成像素、怎么通过接口发一次请求。但这些都是说话。一个真正能干活的系统,需要的是动手——读文件、查数据库、跑命令、调内网服务。
一旦开始动手,三个名字会同时出现:MCP、Claude Code、OpenClaw。它们经常被并列着提,好像是一件事的三种说法。实际上它们根本不在同一个层面上,混着比较会得出很多错误结论。
这一节只做一件事:把三者放到正确的位置上,说清楚各在哪一层、负责什么、什么时候该用哪个。
先分层:协议、产品、编排
先把这张分层图摆出来,后面所有讨论都基于它:
- 第三层:产品形态(谁来干、怎么干)——Claude Code(终端里的编码 Agent)、OpenClaw(常驻的自治 Agent 运行时)
- 第二层:协议(工具怎么被暴露给模型)——MCP(Model Context Protocol),以及各家的 Function Calling
- 第一层:模型接口(怎么把请求发到模型)——OpenAI Chat Completions、Anthropic Messages、Gemini Live
用一张表说清每层回答的问题:
| 层 | 代表 | 回答的问题 | 谁在维护 |
|---|---|---|---|
| 模型接口 | Chat Completions / Messages / Live | 我怎么把话发给模型、怎么拿回结果 | 模型厂商 |
| 工具协议 | MCP | 我怎么把能力和数据暴露给任何模型 | 开放规范,社区与多家厂商共同推动 |
| 产品形态 | Claude Code / OpenClaw | 谁来编排这个循环、权限怎么管、在哪运行 | 各自的产品或项目 |
核心判断:MCP 是插座标准,Claude Code 和 OpenClaw 是用电的电器。 你可以给同一个插座插上不同的电器,也可以让同一台电器换不同的插座——但你不能问“插座和电器哪个更好”。
这个比喻还解释了一个常见误解:以为用了 OpenClaw 就不需要 MCP,或者用了 Claude Code 就绕开了 MCP。恰恰相反,两者都可以作为 MCP 的 Host(宿主),连接同一批 Server。这正是协议层存在的意义——把“能力”和“使用能力的那个 Agent”解耦。
MCP:把 M×N 变成 M+N
先看它要解决的问题。
假设你有 5 个模型(或 5 个 Agent 框架),有 10 个内部系统要接(数据库、Jira、监控、代码仓库、工单……)。没有协议的时候,你要写 5×10 = 50 份胶水代码:每个框架各写一遍“怎么调 Jira”。加一个新模型,要补 10 份;加一个新系统,要补 5 份。这是一个组合爆炸。
MCP(Model Context Protocol)的做法是定义一层中间标准:每个系统只需要实现一个 Server,每个 Agent 只需要实现一个 Client。于是 50 份变成 5+10 = 15 份,而且新增一项只需要加 1。
这个协议里有三个角色,职责边界很清楚:
| 角色 | 是什么 | 例子 |
|---|---|---|
| Host | 宿主应用,持有模型、管理会话、决定要不要调用 | Claude Code、OpenClaw、某个自研 Agent |
| Client | 协议连接器,由 Host 创建,一个 Client 对应一个 Server | 通常由框架实现,业务方不用手写 |
| Server | 能力提供方,把工具和数据按协议暴露出来 | 一个查询 Jira 的 Server、一个读本地文件的 Server |
Server 能暴露三类能力,它们的语义完全不同,别混:
| 能力 | 语义 | 谁来触发 | 典型例子 |
|---|---|---|---|
| tools | 可执行的动作,有副作用 | 模型决定调用 | 创建工单、发消息、跑查询 |
| resources | 可读取的数据,只读 | 应用或模型按需读取 | 一份配置文件、一张表的结构 |
| prompts | 预置的提示词模板 | 用户或应用主动选择 | “代码评审”模板、“周报生成”模板 |
区分 tools 和 resources 有一个很实用的判据:会不会改变世界。 会改的走 tools,只读的走 resources。把只读操作做成 tool,等于让模型有机会在“只是想看一眼”的时候误触发副作用;把有副作用的操作做成 resource,则会让权限管理失去抓手。
传输方式目前主要两种:
- stdio:Host 把 Server 作为子进程拉起,两者通过标准输入输出交换 JSON-RPC 消息。适合本地工具,零网络配置,进程退出即断开。
- HTTP:早期是 HTTP + SSE(服务端推送),后来演进为 Streamable HTTP,把请求响应和流式推送统一到一套端点语义下。适合远程服务、多客户端共享、需要独立部署的场景。
对使用者来说,接一个 Server 通常只是写一段配置,看起来是这样:
python
# MCP 配置:一个本地子进程,一个远程端点
mcp_config = {
    "mcpServers": {
        "filesystem": {
            "command": "npx",
            "args": ["-y", "@modelcontextprotocol/server-filesystem", "/Users/me/projects"],
        },
        "internal-kb": {
            "url": "https://mcp.internal.example.com/mcp",
            "headers": {"Authorization": "Bearer ${KB_TOKEN}"},
        },
    }
}注意这两条的差别:第一条是本地子进程(command),第二条是远程端点(url)。形态不同,暴露给模型的能力却是一样的一批 tools 和 resources——这就是协议的价值。
关于 MCP 的边界,这里必须说清:本节只回答“它在哪一层、解决什么问题”。 怎么写一个 Server、工具怎么设计、权限怎么做、FastMCP 怎么用,全部属于第 7 章的内容,此处不展开。
Claude Code:把 Agent 放进终端
Claude Code 的定位可以用一句话概括:在终端里做 Agentic 编码。
它的形态很朴素——你在项目目录里启动它,然后用自然语言提要求:“把这个模块的错误处理补全”“找出为什么这个测试偶发失败”“把这次改动整理成提交”。它会自己决定读哪些文件、改哪些行、跑哪些命令,做完给你看 diff。
它有几个鲜明的设计取向,值得注意:
第一,工作目录就是权限边界。 它默认只在你启动时所在的目录及其子目录里活动。这个设计很小,但极其重要:Agent 的能力范围被映射成了文件系统的一个子树,用户不需要理解“权限模型”,只需要理解“我在哪个目录启动它”。
第二,循环是内置的,不需要你编排。 用 OpenAI 格式做工具调用时,你要自己写那个“模型返回 tool_calls → 执行 → 回填 → 再请求”的两轮循环。Claude Code 把这个循环封装掉了,模型自己决定读几个文件、跑几次命令。对使用者来说,这降低了门槛;对调试来说,这意味着你必须通过它的输出日志去理解它做了什么。
第三,和开发环境深度绑定。 它理解 git、理解测试命令、理解项目结构,也提供编辑器集成。这让它在“改代码”这件事上的体验远超通用聊天窗口。
它的边界同样清楚:它是一个开发工具,不是运行时。 它不擅长 7×24 常驻、不擅长接多个消息入口、不擅长管理几十个并行任务。你要做的是一个长期在线的服务,而不是一次编码会话,它就不是对的选择。
OpenClaw:把 Agent 当成常驻进程
如果 Claude Code 是“打开一个终端干活,干完关掉”,OpenClaw 的取向几乎相反:它是一个常驻的 Agent 运行时,把 Agent 当成一个长期存在的进程来管理。
这个定位带来几个结构性差异。
第一,多会话隔离。 每个任务、每个对话、每个助理都可以有独立的上下文,互不污染。这一点在长任务场景里是刚需——你不可能让“每天汇总日志”和“排查线上故障”共用同一个上下文窗口,那会互相挤占、互相干扰。
第二,技能(Skill)封装。 一套可复用的流程(比如“怎么发布一次版本”“怎么排查某类告警”)可以写成一个技能,被反复调用,而不是每次都靠提示词重新讲一遍。技能是可积累的资产,这一点和“每次都从零写提示词”有本质区别。
第三,跨平台编排。 它可以把聊天工具、定时任务、事件触发、子代理都当作同一类“入口”,统一调度。你可以在手机上给一个 Agent 发一句话,它在服务器上跑半小时,然后把结果发回同一个对话。
第四,工具策略与审批。 这是容易被忽略但必须要有的部分:哪些工具默认可用、哪些需要人工确认、哪些命令属于高危操作。能力越大,越需要刹车。 一个能执行 shell 的 Agent,如果没有审批环节,一次误判的代价可能是一台机器。
它的代价也要说清楚:常驻意味着要运维(进程、日志、凭据、升级),能力开放意味着风险面变大。它不是“装完就完事”的工具,而是一个需要被认真配置和监控的系统。
怎么选:三个判断和一张表
把三者放回分层图,选择就变得很直接:
| 你的处境 | 该用什么 | 原因 |
|---|---|---|
| 主要工作是写代码、改代码、读懂一个代码库 | Claude Code | 终端形态 + 目录边界 + 开发工具链深度绑定,这是它的主场 |
| 要让 Agent 长期在线,接多个入口,跑定时与事件任务 | OpenClaw | 多会话、技能、跨平台编排、审批,都是为此设计的 |
| 要把公司内部系统(数据库、工单、监控)开放给模型 | 自己写 MCP Server | 一次实现,所有支持 MCP 的 Host 都能用 |
| 只是想让模型查一次数据库 | 直接函数调用 / 工具调用 | 上 MCP 是过度设计,写个函数更快 |
| 想固定一套操作流程反复执行 | 封装成技能(Skill) | 流程是资产,不该每次靠提示词复述 |
有一件事值得单独强调:这三个选择不是互斥的,而是可以叠加的。
一个很现实的组合是这样:你在公司内部写三个 MCP Server(代码仓库、工单、监控),Claude Code 作为 Host 用它来改代码,OpenClaw 作为另一个 Host 用它来跑夜间巡检和告警响应。同一批 Server,两个不同的产品形态,零重复开发。
这正是协议层存在的全部意义——它让“能力”实现一次就能被多处消费,也让“产品形态”可以按场景替换而不必重写集成。缺乏这层协议时,每个 Agent 都要自己重写一遍“怎么查数据库”,第 7 章开头会用一个真实的功能调用例子,展示这种重复到底有多痛。
小结
MCP、Claude Code、OpenClaw 不是三个平行的选项,而是三个不同层次的东西:MCP 定义“能力怎么被暴露”,Claude Code 和 OpenClaw 决定“谁来用、在哪用、怎么管”。
分层的价值在于,它让你在做选择时不会问错问题。你不需要问“MCP 和 Claude Code 哪个好”,你需要问的是:我现在缺的是能力(那就写 Server)、是执行环境(那就选产品)、还是接入方式(那就用协议)。
而 MCP 这一层,本身值得单独用一整章来讲——它的协议细节、Server 的设计原则、权限与部署,恰恰是“把 Agent 从玩具变成系统”的关键一环。下一章,我们就从一次函数调用开始,看清 MCP 到底解决了什么。
参考:Model Context Protocol 官方站点 https://modelcontextprotocol.io
6.2 小结: 大模型提供高效准确的服务并不是一件容易的事情。模型文件本身只是冰山一角,由 PyTorch 筑底、Transformers 串联、OpenAI 协议输出,最后由 MCP 等协议赋予行动力。这些技术共同组成了庞大而精密的大模型技术生态,缺一不可。
6.3 大模型训练
站在2026年看大模型的未来,从头开始训练一个大模型的时代已结束,未来我们绝大多数人,特别是技术人一辈子都不会参与基础模型的训练工作,但是这并不妨碍我们去了解下大模型是如何生成的。就像大多数程序都不会在时候用C语言,但是我们都去学习。
6.3.1 手搓大模型
大模型的初生时代确实是手搓的,虽然这些方法今天看来依然非常幼稚,但是对我们学习大模型还有非常有帮助的。就像我们学习计算机的人都学过很多在实际工作中没用到的东西,但是这些知识对于我们有用工具切实也是有帮助的。
用PyTorch手搓大模型
我们以目前最流行的MoE架构的模型(Deepseek-V3.2采用的架构)为例,看看如何手搓一个大模型。
Python
import torch
import torch.nn as nn
import torch.optim as optim
import torch.nn.functional as F
from torch.utils.data import Dataset, DataLoader
from torchtext.vocab import build_vocab_from_iterator
import jieba
import os
import math
import numpy as np
import random

# --- 0. 环境和超参数设置 ---
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
print(f"正在使用设备: {device}")

# 全局超参数 (请根据你的硬件和数据量进行调整)
VOCAB_MIN_FREQ = 5           # 词汇表最小出现频率
BATCH_SIZE = 32              # 批次大小 (如果显存不足,请尝试 16, 8, 4)
NUM_EPOCHS = 3               # 训练轮数
LEARNING_RATE = 0.0001       # 学习率
MAX_SEQ_LEN = 512            # 关键:最大序列长度,超过此长度的序列将被截断

# 模型超参数
MODEL_PARAMS = {
    'd_model': 512,          # 词嵌入/隐藏层维度 (d_model)
    'nhead': 8,              # 注意力头数 (nhead)
    'num_layers': 6,         # 层数 (num_layers)
    'dim_feedforward': 2048,  # 前馈网络维度
    'dropout': 0.1           # Dropout比率
}

# MoE 相关的超参数
MOE_PARAMS = {
    'num_experts': 8,       # 专家的总数量
    'top_k': 2              # 每个 token 选择的专家数量
}

# 文件路径
CORPUS_FILE = 'path/to/your/corpus/merged_file.txt'        # 换成你自己的语料文件
MODEL_FILE = 'path/to/your/model/transformer_model.pth'    # 换成你自己的权重文件

# 特殊词元
SPECIAL_SYMBOLS = ['<unk>', '<pad>', '<bos>', '<eos>']
UNK_IDX, PAD_IDX, BOS_IDX, EOS_IDX = [SPECIAL_SYMBOLS.index(s) for s in SPECIAL_SYMBOLS]


# --- 1. 数据集类:包含序列截断逻辑 ---
class TextFileDataset(Dataset):
    def __init__(self, file_path, vocab, tokenizer, max_len):
        self.file_path = file_path
        self.vocab = vocab
        self.tokenizer = tokenizer
        self.max_len = max_len  # 存储最大长度

        with open(self.file_path, 'r', encoding='utf-8') as f:
            self.lines = f.readlines()

    def __len__(self):
        return len(self.lines)

    def __getitem__(self, idx):
        line = self.lines[idx]
        tokens = self.tokenizer(line.strip())
        ids = self.vocab(tokens)
        ids_with_specials = [BOS_IDX] + ids + [EOS_IDX]

        # 关键截断逻辑:确保序列长度不超过 MAX_SEQ_LEN
        if len(ids_with_specials) > self.max_len:
            # 截断时保留 BOS 和 EOS
            ids_with_specials = ids_with_specials[:self.max_len - 1] + [EOS_IDX]

        return torch.tensor(ids_with_specials, dtype=torch.long)

# --- 2. 数据处理封装类 ---


class CorpusProcessor:
    # 构造函数现在接收 max_len
    def __init__(self, file_path, vocab_min_freq, max_len):
        self.file_path = file_path
        self.vocab_min_freq = vocab_min_freq
        self.max_len = max_len
        self.vocab = None
        self.tokenizer = self._get_tokenizer()

    @staticmethod
    def _get_tokenizer():
        """返回一个中文分词器"""
        return lambda text: list(jieba.cut(text))

    def _yield_tokens(self):
        """逐行读取文件并生成分词后的词元"""
        with open(self.file_path, 'r', encoding='utf-8') as f:
            for line in f:
                yield self.tokenizer(line.strip())

    def build_vocab(self):
        """构建并返回词汇表"""
        print("正在构建词汇表...")
        self.vocab = build_vocab_from_iterator(
            self._yield_tokens(),
            min_freq=self.vocab_min_freq,
            specials=SPECIAL_SYMBOLS
        )
        self.vocab.set_default_index(UNK_IDX)
        print(f"词汇表大小: {len(self.vocab)}")
        return self.vocab

    def get_dataloader(self, batch_size):
        """返回数据加载器"""
        if self.vocab is None:
            raise ValueError("请先调用 build_vocab 方法")

        dataset = self._get_dataset()
        return DataLoader(
            dataset,
            batch_size=batch_size,
            shuffle=True,
            collate_fn=self._collate_fn
        )

    def _get_dataset(self):
        """返回数据集,并将 max_len 传入"""
        # 使用独立的 TextFileDataset 类
        return TextFileDataset(self.file_path, self.vocab, self.tokenizer, self.max_len)

    def _collate_fn(self, batch):
        """用于DataLoader的批次填充函数 (batch_first=False)"""
        padded_batch = nn.utils.rnn.pad_sequence(batch, padding_value=PAD_IDX, batch_first=False)
        return padded_batch


# --- 3. 模型构建 (Transformer MoE 解码器) ---
class PositionalEncoding(nn.Module):
    def __init__(self, d_model, max_len=5000):
        super().__init__()
        pe = torch.zeros(max_len, d_model)
        position = torch.arange(0, max_len, dtype=torch.float).unsqueeze(1)
        div_term = torch.exp(torch.arange(0, d_model, 2).float() * (-math.log(10000.0) / d_model))
        pe[:, 0::2] = torch.sin(position * div_term)
        pe[:, 1::2] = torch.cos(position * div_term)
        pe = pe.unsqueeze(0).transpose(0, 1)
        self.register_buffer('pe', pe)

    def forward(self, x):
        return x + self.pe[:x.size(0), :]


class MoELayer(nn.Module):
    def __init__(self, d_model, dim_feedforward, num_experts, top_k):
        super().__init__()
        self.num_experts = num_experts
        self.top_k = top_k

        self.gating_network = nn.Linear(d_model, num_experts, bias=False)

        self.experts = nn.ModuleList([
            nn.Sequential(
                nn.Linear(d_model, dim_feedforward),
                nn.ReLU(),
                nn.Linear(dim_feedforward, d_model)
            ) for _ in range(num_experts)
        ])

    def forward(self, x):
        # x 形状: (S, B, E)
        seq_len, batch_size, d_model = x.shape
        x_flat = x.view(-1, d_model)  # (S*B, E)

        # 1. 门控网络计算路由权重
        gate_logits = self.gating_network(x_flat)
        weights, selected_experts_indices = torch.topk(gate_logits, self.top_k, dim=-1)

        # 2. 对权重进行 softmax 归一化
        weights = F.softmax(weights, dim=-1, dtype=torch.float).to(x.dtype)

        # 3. 负载均衡损失 (简化,仅用于占位)
        load_balancing_loss = torch.tensor(0.0, device=x.device, dtype=x.dtype)

        # 4. 初始化输出张量
        final_output = torch.zeros_like(x_flat)

        # 5. 遍历每个 token 进行路由和加权求和
        for i, token_weights in enumerate(weights):
            token = x_flat[i]
            token_output = torch.zeros_like(token)

            for j, expert_idx in enumerate(selected_experts_indices[i]):
                expert_output = self.experts[expert_idx](token)
                token_output += expert_output * token_weights[j]

            final_output[i] = token_output

        return final_output.view(seq_len, batch_size, d_model), load_balancing_loss


class TransformerMoEDecoderLayer(nn.Module):
    def __init__(self, d_model, nhead, dim_feedforward, dropout, num_experts, top_k):
        super().__init__()
        self.norm1 = nn.LayerNorm(d_model)
        # 修复:移除 batch_first=True,默认使用 batch_first=False
        self.self_attn = nn.MultiheadAttention(d_model, nhead, dropout=dropout)
        self.dropout1 = nn.Dropout(dropout)

        self.norm2 = nn.LayerNorm(d_model)
        # 使用 MoE 层
        self.moe_layer = MoELayer(d_model, dim_feedforward, num_experts, top_k)
        self.dropout2 = nn.Dropout(dropout)

    def forward(self, src, src_mask, src_padding_mask):
        # src, x 形状: (S, B, E)

        # 自注意力层
        x = src
        norm_x = self.norm1(x)
        # 注意:src_mask 和 src_padding_mask 都是 (S, S) 和 (B, S) 形状,与 batch_first=False 兼容
        attn_output, _ = self.self_attn(norm_x, norm_x, norm_x, attn_mask=src_mask, key_padding_mask=src_padding_mask)
        x = x + self.dropout1(attn_output)

        # MoE 层
        y = self.norm2(x)
        y, load_balancing_loss = self.moe_layer(y)
        x = x + self.dropout2(y)

        return x, load_balancing_loss


class TransformerMoEDecoderOnly(nn.Module):
    """模型层次设定"""

    def __init__(self, vocab_size, d_model, nhead, num_layers, dim_feedforward, dropout, num_experts, top_k):
        super().__init__()

        self.embedding = nn.Embedding(vocab_size, d_model)
        self.pos_encoder = PositionalEncoding(d_model)

        # 构建 MoE 解码器层
        self.layers = nn.ModuleList([
            TransformerMoEDecoderLayer(d_model, nhead, dim_feedforward, dropout, num_experts, top_k)
            for _ in range(num_layers)
        ])

        self.final_norm = nn.LayerNorm(d_model)
        self.fc_out = nn.Linear(d_model, vocab_size)

    def forward(self, src, src_mask, src_padding_mask):
        src = self.pos_encoder(self.embedding(src))

        total_load_balancing_loss = 0
        for layer in self.layers:
            src, load_balancing_loss = layer(src, src_mask, src_padding_mask)
            total_load_balancing_loss += load_balancing_loss

        output = self.final_norm(src)
        return self.fc_out(output), total_load_balancing_loss


# --- 4. 训练管理类 ---
class ModelTrainer:
    def __init__(self, model, dataloader, criterion, optimizer, device):
        self.model = model
        self.dataloader = dataloader
        self.criterion = criterion
        self.optimizer = optimizer
        self.device = device
        self.model.to(self.device)

    def _create_causal_mask(self, size):
        # 修复:返回布尔类型掩码 (True 表示屏蔽),解决 UserWarning
        mask = torch.triu(torch.ones(size, size), diagonal=1).bool()
        return mask

    def train(self, num_epochs):
        print("开始训练...")
        self.model.train()
        for epoch in range(num_epochs):
            total_loss = 0
            for batch in self.dataloader:
                batch = batch.to(self.device)  # (S, B)
                seq_len = batch.size(0)

                # 创建因果掩码 (Bool type),并发送到设备
                mask = self._create_causal_mask(seq_len).to(self.device)

                # 创建填充掩码 (Bool type - True表示要忽略/屏蔽) (B, S)
                padding_mask = (batch == PAD_IDX).transpose(0, 1).to(self.device)

                # 前向传播:接收两个返回值
                output, load_balancing_loss = self.model(batch, mask, padding_mask)

                # 计算损失
                output_dim = output.shape[-1]
                output = output[1:].view(-1, output_dim)  # 预测下一个词
                target = batch[1:].view(-1)

                # 总损失 = 交叉熵损失 + 负载均衡损失
                loss = self.criterion(output, target) + load_balancing_loss

                self.optimizer.zero_grad()
                loss.backward()
                self.optimizer.step()

                total_loss += loss.item()

            avg_loss = total_loss / len(self.dataloader)
            print(f'纪元: {epoch+1}/{NUM_EPOCHS}, 平均损失: {avg_loss:.4f}')

        print("训练完成!")

# --- 主函数执行 ---


def main():
    # 生成模拟数据
    def generate_mock_data(file_path, size_mb=100):
        if os.path.exists(file_path):
            print(f"文件 '{file_path}' 已存在,跳过数据生成。")
            return

        print(f"正在生成 {size_mb}MB 的模拟中文数据...")
        sentences = [
            "今天天气真好,我们一起出去玩吧。",
            "深度学习是一项非常有趣的技术。",
            "这是一个非常棒的例子,它将帮助我学习。",
            "自然语言处理是人工智能的一个重要分支。",
            "我喜欢编程,尤其是使用 Python。",
        ]
        total_size = 0
        with open(file_path, 'w', encoding='utf-8') as f:
            while total_size < size_mb * 1024 * 1024:
                line = random.choice(sentences) + "\n"
                f.write(line)
                total_size += len(line.encode('utf-8'))
        print("数据生成完毕。")

    generate_mock_data(CORPUS_FILE)

    # 1. 初始化数据处理器
    # 传入 MAX_SEQ_LEN 进行截断
    processor = CorpusProcessor(CORPUS_FILE, VOCAB_MIN_FREQ, MAX_SEQ_LEN)
    vocab = processor.build_vocab()

    # 2. 初始化模型
    model = TransformerMoEDecoderOnly(
        vocab_size=len(vocab),
        **MODEL_PARAMS,
        **MOE_PARAMS
    )

    # 3. 初始化数据加载器、损失函数和优化器
    dataloader = processor.get_dataloader(BATCH_SIZE)
    criterion = nn.CrossEntropyLoss(ignore_index=PAD_IDX)
    optimizer = optim.Adam(model.parameters(), lr=LEARNING_RATE)

    # 4. 初始化训练器并开始训练
    trainer = ModelTrainer(model, dataloader, criterion, optimizer, device)
    trainer.train(NUM_EPOCHS)

    # 5. 保存模型和词汇表
    torch.save({
        'model_state_dict': model.state_dict(),
        'vocab': vocab,
        'model_hyperparameters': {**MODEL_PARAMS, **MOE_PARAMS, 'max_seq_len': MAX_SEQ_LEN}
    }, MODEL_FILE)

    print(f"模型和词汇表已成功保存到 {MODEL_FILE}")


if __name__ == '__main__':
    main()
代码深度解读:大模型的三个关键模块
这段代码展示了一个基于 Transformer 改进的 MoE 解码器。即使你拥有 14B 甚至 671B 参数的模型,其核心逻辑依然逃不出这三个部分:
数据的“炼油厂” (
CorpusProcessor):- 分词 (Tokenizer):代码中使用了
jieba。大模型不认识汉字,它只认识数字。分词的作用就是把“今天天气真好”切成“今天/天气/真好”,然后转换成索引 ID。 - 截断与填充 (
max_len):大模型的“胃口”是有限的。通过MAX_SEQ_LEN确保输入的数据不会超出模型的处理窗口,这是工程中平衡显存与性能的关键。
- 分词 (Tokenizer):代码中使用了
核心的大脑:MoE 层 (
MoELayer):- 门控网络 (
gating_network):这是 MoE 的“分流指挥官”。它决定了当前的 Token 应该交给哪位“专家”处理。 - 专家群 (
experts):我们定义了 8 个专家。在 2026 年,这种“让专业的人干专业的事”的设计,让模型在保持高智能的同时,推理速度提升了数倍。 - Top-K 路由:代码中设置
top_k=2。这意味着每个字只会激活 8 个专家中的 2 个,大大节省了计算算力。
- 门控网络 (
学习的逻辑 (
ModelTrainer):- 因果掩码 (
causal_mask):这是 GPT 类模型的灵魂。它告诉模型:你在练习时,严禁偷看后面的答案,只能根据左边的词预测右边的词。 - 损失函数 (
Criterion):模型通过对比“自己的预测”和“真实答案”的差距(Loss),利用反向传播算法来调整那几亿个参数。
- 因果掩码 (
虽然你在本地跑这段代码可能只能训练出一个只会复读“今天天气不错”的小模型,但你已经亲历了大模型诞生的全过程:数据清洗 -> 张量流动 -> 路由分发 -> 损失对齐。
6.3.2 工业级训练:加速与分布式工具
当你不再满足于“手搓” 100MB 数据,而是要处理 10TB 的互联网语料时,单张显卡已经无法胜任。此时,我们需要大模型技术生态中的“重工业设备”:
- DeepSpeed (微软出品):
- 简介:目前大模型微调和中小型模型训练的“标配”。
- 核心技术:ZeRO (零冗余优化器)。它能把模型参数分散到多张显卡上,让你在有限的硬件下跑起更大的模型。
- Megatron-LM (英伟达出品):
- 简介:大模型训练的“重型坦克”。专门针对万卡级别的集群优化。
- 特点:极致的并行效率。如果你要训练一个 100B 以上的模型,Megatron 是绕不开的选择。
- GPT-NeoX (EleutherAI 出品):
- 简介:开源界对抗闭源大模型的利器,提供了完整的预训练流水线。
6.3.3 模型格式转化:跨平台的桥梁
训练完的模型通常是巨大的 .pth 或 .bin 文件,为了让它在手机、Mac 或低功耗服务器上跑起来,我们需要进行格式转化:
- GGUF:2026 年本地 AI 社区最爱的格式。它将模型高度压缩(量化),配合 Llama.cpp,甚至能让带 M 芯片的 Mac 跑起 70B 的大模型。
- ONNX Runtime:由微软主导的通用格式,旨在让你的 AI 模型运行在任何支持 C++ 的设备上,是端侧部署的工业标准。
6.3.4 预训练数据格式:模型的“食谱”
模型好不好,全看“饭”香不香。2026 年主流的预训练数据格式已趋于统一:
- JSONL:每行一个 JSON 对象,极其适合流式读取 TB 级数据,而不会撑爆内存。
- Parquet:一种列式存储格式,通常用于大规模集群(如 Spark)处理后的结构化语料,读取速度极快。
结尾小记: 了解训练不是为了让你去造轮子,而是为了让你在调用 API 报错时,能瞬间反应过来:这是因果掩码没设置好?还是 Tokenizer 的词表越界了?懂底层逻辑的人,永远拥有最高优先级的排障权。
6.4 大模型微调
在本书的第五章第3小节中我们已经介绍了大模型微调的概念和方法,这里主要介绍微调的工具,微调数据的标注工具已经微调后模型的量化。
6.4.1 微调工具
1. llama-factory
llama-factoy是目前应用非常广泛的大模型微调工具集
核心资源
bash
# 安装手册
https://github.com/hiyouga/LlamaFactory/blob/main/README_zh.md

# 使用说明

https://llamafactory.readthedocs.io/zh-cn/latest/
快速体验
为了加快体验,我们在以下环境中给出的是基于ubuntu的环境的流程,如果需要在其他环境中体验,请参安装手册
- 系统安装 由于llama-factory自带很多配置文件,这里采用源代码安装方式。安装前默认已经按照本书第二章的内容已经配置好相关的环境。
bash
# 环境准备
conda create -n llamaf_py310 python=3.10

# 切换conda环境
conda activate llamaf_py310

# llama-factory安装(如果速度慢请按照本书第二章的方法进行加速)
git clone --depth 1 https://github.com/hiyouga/LlamaFactory.git
cd LlamaFactory
pip install -e .
pip install -r requirements/metrics.txt

# 安装校验
llamafactory-cli version执行命令llamafactory-cli version显示版本信息证明安装已经完成。
最佳实践
- llama-factory通过命令行参数和和配置文件两种方式设置微调参数。这里推荐统一采用配置文件的方式,llama-factory的配置文件为ymal格式。
- llama-factory源代码的
examples目录中包含了不同类型配置文件的示例。 - llama-factory对微调数据集的处理采用的是:数据集目录+数据集配置文件的模式。可以参考源代码的
data目录的结构,在data目录中有一个文件dataset_info.json,这是默认的数据集配置信息文件。 - llama-factory提供了一个可视化的微调界面,通过这个界面可以快是的设置相关参数并进行微调。可视化界面启动参数如下:
bash
export set CUDA_VISIBLE_DEVICES=0
export set GRADIO_SHARE=1
export set GRADIO_SERVER_PORT=8858

llamafactory-cli webui- llama-factory提供了一个快速访问模型的工具,这个工具可以在一个web界面中快速的和模型进行对话。启动命令如下
bash
CUDA_VISIBLE_DEVICES=0 llamafactory-cli webchat \
    --model_name_or_path path/to/DeepSeek-V2-Lite \
    --template llama3 \
    --trust_remote_code true
调用示例
以下示例在llama-factory的源码中均能找到
bash
# 微调模型
llamafactory-cli train examples/train_lora/llama3_lora_sft.yaml
#合并模型
llamafactory-cli export examples/merge_lora/qwen_lora_sft.yaml
#推理模型
llamafactory-cli chat examples/inference/qwen_lora_sft.yaml
2. ms-swift (魔搭社区出品)
ms-swift 是阿里 ModelScope(魔搭)社区推出的轻量级训练推理框架。它的核心优势在于对国产模型(Qwen, DeepSeek, Yi 等)和多模态模型(图像、视频理解)的超前支持。
核心资源
bash
# 官方代码库
[https://github.com/modelscope/ms-swift](https://github.com/modelscope/ms-swift)

# 快速开始文档
[https://swift.readthedocs.io/zh-cn/latest/GetStarted/快速开始.html](https://swift.readthedocs.io/zh-cn/latest/GetStarted/快速开始.html)
快速体验
bash
# 环境准备
conda create -n swift_py310 python=3.10
conda activate swift_py310

# 安装 swift (包含 llm 相关依赖)
pip install "ms-swift[llm]" -U

# 验证安装
swift --version
最佳实践
- 命令行驱动:ms-swift 极其推崇单条命令行完成任务。它的参数设计非常直观,适合编写自动化脚本。
- 多模态专家:如果你需要微调 Qwen-VL 或 LLaVA 等视觉模型,ms-swift 几乎是目前生态中支持最稳、速度最快的工具。
- 自适应模板:ms-swift 内部集成了大量模型的对话模板,你通常不需要手动指定 template,它能根据模型路径自动识别。
- 一键启动 WebUI:
swift web-ui
调用示例
bash
# 微调示例:使用 LoRA 微调 Qwen2-7B
CUDA_VISIBLE_DEVICES=0 swift sft \
    --model_type qwen2-7b-instruct \
    --dataset tlc-single-chat \
    --output_dir output

# 推理示例
CUDA_VISIBLE_DEVICES=0 swift infer --ckpt_dir output/qwen2-7b-instruct/vx-xxx/checkpoint-xxx
3. Unsloth (极致性能黑科技)
Unsloth 是 2026 年微调界的“加速插件”。它通过手写 Triton 内核,在不损失精度的前提下,将微调速度提升了 2-5 倍,并将显存占用降低了 70%。
核心资源
bash
# 官方代码库
[https://github.com/unslothai/unsloth](https://github.com/unslothai/unsloth)

# 官方文档 (Wiki)
[https://docs.unsloth.ai/](https://docs.unsloth.ai/)
快速体验
Unsloth 对依赖版本要求较高,建议严格按照以下顺序在 PyTorch 2.x 环境下安装。
bash
# 环境建议使用之前章节提到的 nvcr.io/nvidia/pytorch 镜像
# 安装 unsloth (根据你的 CUDA 版本选择)
pip install "unsloth[colab-new] @ git+[https://github.com/unslothai/unsloth.git](https://github.com/unslothai/unsloth.git)"
pip install --no-deps "xformers<0.0.27" "trl<0.9.0" peft accelerate bitsandbytes
最佳实践
- 极致低成本:Unsloth 可以让你在 16GB 显存的显卡上微调 Llama-3-70B 模型(通过其独特的 4-bit 优化),这在以前是不可想象的。
- 单卡战神:Unsloth 目前主要针对单卡进行了极致优化。如果你只有单张显卡,它是提升效率的首选。
- 导出 GGUF:Unsloth 原生支持将微调后的 LoRA 权重直接合并并导出为 GGUF 格式,无缝对接 Ollama 或 Llama.cpp。
调用示例
Unsloth 通常以 Python 脚本的形式调用,其核心逻辑是在加载模型时注入加速内核:
Python
from unsloth import FastLanguageModel
import torch

# 加载模型并注入加速内核
model, tokenizer = FastLanguageModel.from_pretrained(
    model_name = "unsloth/llama-3-8b-bnb-4bit",
    max_seq_length = 2048,
    load_in_4bit = True,
)

# 之后你可以直接使用标准的 SFTTrainer 进行训练,速度将大幅提升
微调总结:该选哪一个?
作为大模型架构师,你需要根据项目需求快速拍板:
- 如果你需要可视化界面、且任务类型多(SFT/DPO/PPO/奖励模型):选 LLaMA-Factory。
- 如果你在微调国产模型、或者正在处理图片/视频多模态数据:选 ms-swift。
- 如果你只有单张普通显卡,且追求最快的训练速度和最低的显存占用:选 Unsloth。
实践建议:
“工具的繁荣是大模型生态成熟的标志。2026 年的开发者不再需要手写反向传播,我们的工作已经演变为:准备高质量数据 -> 选择合适的微调框架 -> 监控 Loss 曲线。”
6.4.2 量化与压缩:给模型“瘦身”
大模型微调完成后,通常是全精度的权重文件(如 BF16),体积巨大且推理缓慢。虽然 LLaMA-Factory 和 ms-swift 已经集成了量化导出功能,但作为架构师,你需要理解不同量化技术背后的应用场景,以便决定导出的格式。
1. 常见的量化技术与工具背景
量化工具的本质是将模型中 16 位的浮点数压缩为 8 位、4 位甚至 1.5 位。
- AWQ (Activation-aware Weight Quantization):
- 工具:
llm-compressor(这是目前 vLLM 官方推荐的量化库,已取代旧的 AutoAWQ)。 - 特点:对模型精度的保护极好,尤其适合 4-bit 量化,是 GPU 推理服务器(如 vLLM, TGI)的首选。
- 工具:
- GPTQ (Post-Training Quantization):
- 工具:
AutoGPTQ/Optimum-cli。 - 特点:老牌量化技术,兼容性极广,但在极低位宽下效果略逊于 AWQ。
- 工具:
- GGUF (GPT-Generated Unified Format):
- 工具:
llama.cpp。 - 特点:端侧设备之王。如果你想让模型在 Mac、手机或普通 PC 电脑上跑,请在 LLaMA-Factory 导出时务必选择 GGUF。
- 工具:
2. 量化决策表
在 2026 年,你不需要手动安装上述工具,只需在微调框架(如 LLaMA-Factory)的 export 参数中指定:
| 部署目标 | 推荐量化格式 | 核心工具库 | 备注 |
|---|---|---|---|
| 云端生产环境 (A100/H800) | FP8 / AWQ | llm-compressor | 追求吞吐量与精度的平衡 |
| 本地私有服务器 (RTX 4090) | AWQ / GPTQ | AutoGPTQ | 兼容性最强 |
| 个人电脑 / 手机终端 | GGUF | llama.cpp | 支持 CPU 推理,极致省显存 |
| 边缘计算设备 (嵌入式) | ONNX / OpenVINO | Optimum | 跨硬件平台的终极方案 |
避坑指南:
- 不要在微调过程中开启量化(除非使用 QLoRA),量化通常发生在微调完成后的“导出(Export)”阶段。
- 精度损失:4-bit 是目前的黄金分割点。低于 4-bit(如 2-bit)虽然体积更小,但模型会开始“胡言乱语”,请谨慎选择。
- llm-compressor 是未来:如果你发现旧的量化脚本跑不动了,请全面转向神经网络大厂一致推崇的
llm-compressor。
6.4.3 训练样本标注工具
如果说算力是大模型的发动机,数据就是燃料。在 2026 年,数据标注已不再是机械的劳动,而是演变为一种“人类反馈的对齐”。对于架构师而言,选择合适的工具能让数据生产效率提升 10 倍以上。
1. Argilla (NLP 与对齐专家)
Argilla 是专为 LLM 时代的标注而生的工具。它不仅仅是一个标注界面,更是一个数据治理平台,深度集成了 Hugging Face 生态。
- 核心作用:主要用于 RLHF(人类反馈强化学习) 阶段,通过人类对模型多个输出进行排序(Ranking)或打分,帮助模型学习“哪种回答更好”。
- 特性:支持“模型辅助标注”。你可以先让一个高性能模型(如 GPT-4 或 DeepSeek-V3)给出预标注,人工仅需进行微小的修正。
- 快速体验:
bash
pip install argilla
# 启动服务器(需配合 Docker 或本地数据库)
python -m argilla
2. CVAT (多模态视屏/图像利器)
当你需要训练一个能“看懂”你设备面板开关状态的多模态模型时,CVAT 是不可替代的。
- 核心作用:处理复杂的视觉数据。它对视频帧的连续性标注(Track)支持极好。
- 特性:支持 3D 立方体、多边形分割等极高精度的标注。在 2026 年,它已支持通过加载外部模型(如 SAM 2)实现自动对象分割。
- 建议:由于 CVAT 属于重型工具,建议直接使用其 Docker 部署方式以避免复杂的环境依赖。
3. X-AnyLabeling (黑科技自动标注)
这是 2026 年开源社区的“黑马”,特别适合需要快速构建多模态数据集的开发者。
- 核心作用:将最先进的视觉模型(如 Segment Anything, Grounding DINO)集成在标注框内。
- 特性:“指哪标哪”。你只需点一下物体的中心,它会自动识别边缘并完成多边形标注。它原生产出支持 Llama-Factory 格式的数据集。
- 架构师评价:它是目前从“通用标注”迈向“定制化自动标注”的最佳过渡方案。
工程实践:关于“定制化标注工具”
在实际的大规模生产中,你会发现通用工具往往难以满足特定业务场景(如特定的工业仪表盘读数提取)。
我的建议是:
- 早期阶段:直接使用 Argilla 或 CVAT 快速验证算法可行性。
- 中期阶段:利用这些工具的 API 接口,编写 Python 脚本实现“初筛”和“预处理”。
- 后期阶段:当你的标注逻辑涉及到复杂的业务自动化时,再考虑基于 Vue 或 React 开发一套极简的定制化前端,后端直接对接你的数据库。不要为了开发标注工具而开发工具,数据的质量永远高于工具的华丽程度。
6.4.4 模型微调集成平台 (MaaS)
在 2026 年,并非所有的微调都需要从 docker pull 开始。对于许多企业而言,使用**集成微调平台(Model-as-a-Service)**是快速验证业务逻辑的捷径。
根据对行业开发者的调研,我们发现:约 60% 的团队依赖云端平台进行快速迭代,20% 的团队在云端验证后转入本地,仅有 20% 的敏感行业坚持全流程本地化。
1. 主流集成平台概览
- 阿里百炼 (ModelStudio):
- 优势:深度集成 Qwen(通义千问)系列模型。提供极其傻瓜化的“数据上传-点击微调-一键部署”流程。
- 特点:支持 数据安全沙箱,在一定程度上缓解了企业对隐私的顾虑。
- 火山引擎 (方舟平台):
- 优势:字节跳动出品,对 Doubao(豆包)系列模型支持最好。其底层算力调度非常成熟,适合大规模并发的微调任务。
- 特点:提供丰富的插件生态,微调后的模型可以无缝接入其工作流引擎。
- 华为云 ModelArts:
- 优势:国产化算力的避风港。如果你必须在昇腾(Ascend)平台上运行模型,ModelArts 提供了从算子优化到并行训练的完整工具链。
2. 决策天平:云端 vs 本地
在评估是否使用集成平台时,请参考以下三个核心指标:
| 维度 | 集成平台 (MaaS) | 本地自建 (On-Premise) |
|---|---|---|
| 时间成本 | 极低。无需配置驱动和 Docker,5 分钟起跑。 | 高。环境调试和显卡驱动可能耗时数天。 |
| 资金成本 | 按需付费。适合短期任务,无需采购昂贵显卡。 | 固定资产投入。适合长期、高频的微调任务。 |
| 数据安全 | 存在风险。即便有协议,数据仍需上传至第三方服务器。 | 极高。物理隔离,数据主权完全掌控。 |
3. 混合范式:2026 年的“最优解”
通过对同行的访谈,我们总结出一套成熟的落地路径:
- Demo 阶段:使用 阿里百炼 或 火山引擎。用少量脱敏数据快速微调,验证该模型在当前业务场景下是否“有潜力”。
- 中试阶段:在本地使用 Llama-Factory 配合 24.03-py3 镜像进行小规模实验,对齐云端参数。
- 生产阶段:对于核心资产(如公司私有协议、财务逻辑),坚持在本地机房进行全参数或 LoRA 微调,确保知识不出域。
不要把时间浪费在重复造轮子上。如果你的目标是快速交付一个“数字员工”原型,请优先使用集成平台。只有当你需要极致的性能优化,或者面临严苛的审计合规时,才是投入人力去维护本地微调集群的时机。
6.5 大模型推理引擎:私有化部署的动力心脏
在 2026 年,如果你还单纯依赖在线 API 来构建核心业务,你将面临三个日渐尖锐的问题:成本不可控(超大模型涨价已成定局)、延迟不可控(公有云的潮汐效应和网络抖动)、以及数据不可控(敏感业务数据一旦离开私有网络,合规就是一颗定时炸弹)。部署私有推理引擎,是开发者从"调包侠"迈向"大模型架构师"的成人礼。
但"私有化部署"四个字背后,是一张远比想象中复杂的博弈地图。选哪个引擎?它偏重吞吐还是延迟?你的显卡是 H100 还是 Mac 的 M3?你跑的是纯文本对话,还是需要同时处理图像生成和语音识别?
这节要做的,就是把这张地图摊开。
我们将 2026 年的推理引擎生态分为六大阵营来审视:
工业级高并发阵营——vLLM、SGLang、TGI。这是企业部署的"三驾马车"。vLLM 凭借 PagedAttention 成为事实标准;SGLang 以 RadixAttention 在 Agent 场景中后来居上;TGI 则是保守派的最爱,功能冻结但稳如磐石。
极致性能与硬件加速阵营——TensorRT-LLM、TurboMind、DeepSpeed-MII。它们的目标是榨干每一张显卡的最后一滴算力。NVIDIA 亲儿子 TensorRT-LLM 直接操控 CUDA 底层;TurboMind 对国产模型和国产 GPU 做了深度适配;DeepSpeed-MII 则是百亿参数以上超大模型的分布式推理专家。
跨平台与边缘计算阵营——llama.cpp、Xinference、ONNX Runtime。如果你不在数据中心,而是在自己的 MacBook 或没有任何 GPU 的服务器上跑模型,这个阵营就是你的答案。llama.cpp 让大模型跑在 CPU 上成为现实;Xinference 更是将 LLM、ASR、图像生成等任务统一纳管,是"一个框架搞定全栈 AI"的代表。
特殊用途引擎——TEI(Text Embeddings Inference)。它不参与对话,但在 RAG 架构中扮演着不可替代的角色:专门为向量化和重排序加速,是所有知识增强系统的"无声引擎"。
Ollama:本地模型的"Docker" ——如果 llama.cpp 是发动机,Ollama 就是驾驶室。它将模型量化、参数配置和环境依赖封装进一个 Modelfile,让拉取、运行、管理模型像操作 Docker 容器一样简单。在 2026 年,它已成为个人开发者和 Agent 工具链的默认后端。
LiteLLM:协议转换的路由器——当你需要同时对接 OpenAI、Anthropic、本地 vLLM 和 Ollama 时,LiteLLM 用一套 OpenAI 标准格式帮你屏蔽了所有 API 差异。更重要的是,它内置的负载均衡和自动故障切换,是生产环境高可用的安全保障。
除了这六大阵营,我们还会涉及多模态推理的特殊生态——ComfyUI 用节点图管理复杂的视觉生成流水线,Diffusers 作为底层驱动库支撑所有主流图像模型。最后,我们将给出一张实战选型表:从"企业通用 API 部署"到"个人 Mac 本地开发",帮你根据自己的硬件和业务逻辑,找到最适合的那颗"心脏"。
本节没有唯一正确的答案,但读完它,你至少能画出自己的决策树。
6.5.1 工业级高并发阵营(吞吐量之王)
你已经知道私有化部署能从成本、延迟、数据三个维度夺回主动权。但真动手时,第一个问题不是"选哪个引擎"——而是"我的显卡能同时撑几路请求"。
这就是工业级高并发阵营要解决的问题。vLLM、SGLang、TGI 三者的核心目标高度一致:在有限的 GPU 显存里,尽可能多地塞进并发用户的 KV Cache,用连续批处理把吞吐量打满。 它们是企业部署的"三驾马车",也是 2026 年生产环境中装机量最高的推理引擎阵列。
vLLM:PagedAttention 的开山之作与事实标准
地位:vLLM 由 UC Berkeley Sky Computing Lab 从零实现,是目前最广泛采用的开源推理引擎。截至 2026 年,几乎所有主流模型发布时都会默认提供 vLLM 的部署镜像,其地位相当于 LLM 推理领域的"Linux 内核"——你未必锁定它,但你绕不开它定义的接口。
核心:PagedAttention。这个算法的灵感直接来自操作系统的虚拟内存管理。传统推理引擎把每个请求的 KV Cache 当成一整块连续内存分配,一旦请求长度不同,就会产生大量内部碎片——就像 C 语言里 malloc 大块内存后不得不 free 再重来的窘境。PagedAttention 的思路是把 KV Cache 切成固定大小的"页"(block),按需分配,不要求连续。一个请求用几页就分配几页,换出、换入、回收都在页粒度下完成。结果是:同样的显存,vLLM 能承载的并发请求数通常是 HuggingFace Transformers 原生推理的 14-24 倍[15]。
特性:
- 连续批处理(Continuous Batching):不等整批请求完成才释放资源,而是每个 token 生成后立即将资源回池。这让长请求不会憋死短请求。
- OpenAI 兼容 API:启动时加
--served-model-name,OpenAI SDK 的client.chat.completions.create()不改一行代码就能走 vLLM。这是"迁移零风险"的关键落地策略。 - 多 LoRA 共用基座:一个基座模型可以同时挂载多个 LoRA adapter,不同租户或不同下游任务共享显存,大幅降低多租户部署的硬件成本。
适用场景:你需要部署一个稳定、兼容、开箱即用的生产级 API 服务,团队已经在用 OpenAI SDK。vLLM 是默认选项,也是最安全的选项。
下面的代码在一张 H100 上启动 Qwen3-8B 并直接对接 OpenAI SDK:
bash
# 启动 vLLM 服务(需要约 20GB 显存)
pip install vllm
vllm serve Qwen/Qwen3-8B \
  --host 0.0.0.0 --port 8000 \
  --served-model-name qwen3-8b \
  --max-model-len 8192 \
  --gpu-memory-utilization 0.90
python
# 用标准 OpenAI SDK 调用
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="not-needed"  # 本地服务不需要真实 key
)

response = client.chat.completions.create(
    model="qwen3-8b",
    messages=[
        {"role": "system", "content": "你是一个 Python 专家。"},
        {"role": "user", "content": "解释什么是 GIL,用比喻。"}
    ],
    temperature=0.7,
    max_tokens=300
)
print(response.choices[0].message.content)关键参数说明:--gpu-memory-utilization 0.90 表示 vLLM 会占用显卡 90% 的显存作为 KV Cache 池,留给 CUDA 核心运算的 10% 是安全边界;--max-model-len 8192 限制了单请求的最大上下文长度,超过的请求会被拒绝而不是崩溃。
SGLang:RadixAttention 与 Agent 场景"黑马"
地位:SGLang 由 LMSYS Org(Chatbot Arena 的运营方)出品,2024 年初发版后迅速从学术项目进化为工业级引擎,2026 年已成为高性能推理的标杆选项。如果说 vLLM 是"稳",SGLang 就是"快"——尤其是在多轮对话和 Agent 场景中。
核心:RadixAttention。PagedAttention 解决了显存碎片,但并没有专门优化缓存复用。在多轮对话中,用户的新一轮请求通常共享了前面几乎所有轮次的前缀——系统提示词 + 对话历史。传统做法是每次重新计算这些前缀的 KV Cache,浪费了宝贵的 FLOPS。RadixAttention 的做法是在服务端维护一棵基数树(Radix Tree),所有请求的前缀都挂在这棵树上。当新请求到达时,SGLang 遍历树找到最长匹配的前缀节点,直接复用已有的 KV Cache,只计算新增的部分。对于典型的 Agent 工作流——"系统提示 + 工具定义 + 多轮调用"——前缀缓存命中率常年保持在 80% 以上,实测推理速度可达到 vLLM 的 2-5 倍[16]。
特性:
- 原生结构化生成:
regex和json_schema约束直接集成在推理层,不是事后 parser 裁剪。这意味着生成即合规,不存在"token 生成完才发现 JSON 不合法"的性能浪费。 - 拆分式预填充/解码(Disaggregated Prefill/Decode):可以将"理解 prompt"(prefill)和"逐 token 生成"(decode)部署在不同的 GPU 上,对超长上下文场景的延迟优化效果显著。
- DeepSeek V3/V3.2/R1 的原生支持:作为 SGLang 重点适配的 MoE 模型族,在多机多卡推理上表现最优。
适用场景:构建 Agent 系统——循环调用工具、维持长对话上下文、需要频繁复用系统提示词。如果你的架构中有"一个 Agent 带着 50 个 tool 定义反复调用"的模式,SGLang 是性价比最高的选择。
bash
# 启动 SGLang 服务
pip install "sglang[all]"
python -m sglang.launch_server \
  --model-path Qwen/Qwen3-8B \
  --host 0.0.0.0 --port 30000 \
  --mem-fraction-static 0.85
python
# SGLang 原生前端:在 prompt 中嵌入控制逻辑
import sglang as sgl

@sgl.function
def code_review(s, code: str):
    s += sgl.system("你是一个资深代码审查专家。")
    s += sgl.user(f"审查以下代码,列出 3 个改进点:\n```python\n{code}\n```")
    s += sgl.assistant(sgl.gen("review", max_tokens=500))

# 多次调用自动复用系统提示词前缀
code = """
def calc(x):
    return x + 1
"""
state = code_review.run(code=code)
print(state["review"])
注意 SGLang 的 @sgl.function 装饰器:它允许你在生成过程中嵌入程序逻辑(如 fork 多条分支、select 不同选项),而不是把一切交给单次 API 调用。这种"编程式生成"在前缀缓存场景下威力最大——同一个函数里的 system 调用只计算一次。
TGI:Hugging Face 的"保守派标杆"
地位:TGI(Text Generation Inference)由 Hugging Face 官方维护,是这三个引擎中历史最久、生产环境踩坑最多的项目。2025 年后 HF 已将主力研发资源转向新架构,TGI 进入维护模式——新特性节奏放缓,但基本稳定性和正确性是三个引擎中最可靠的。
核心:如果说 vLLM 和 SGLang 在"更快"上竞赛,TGI 的核心竞争力从来不是绝对性能,而是正确性优先(correctness-first)。它的设计哲学是:宁慢一秒,不错一个 token。所有 HuggingFace Hub 上的模型,TGI 都能做到零配置启动——不需要纠结 trust_remote_code、不需要手动配置 tokenizer、不需要担心 attention 实现差异。它就像一个钝但永远不会卷刃的刀片。
特性:
- 水印(Watermark):内置的文本水印算法,生成的文本可以追溯来源,这在金融合规和法律文档生成中至关重要。
- 引导生成(Guidance):通过约束 grammar 来控制输出格式,与 SGLang 的 regex 约束属于同类竞争力,但实现更保守——使用 HuggingFace 生态内的
outlines库,兼容性更好。 - 量化就绪:支持 GPTQ、AWQ、bitsandbytes 等多种量化后端,与 HF Transformers 的量化生态完全对齐。
适用场景:你的团队深度绑定了 HuggingFace 生态,模型来自 Hub,数据走 Datasets,评估用 Evaluate——TGI 是插件,直接拧进去即可。也适合对稳定性要求极高的传统业务(银行、保险、政务),性能不是第一指标,无事故才是。
bash
# TGI Docker 部署(推荐方式)
model=Qwen/Qwen3-8B
volume=/data/models
docker run --gpus all --shm-size 1g \
  -p 8080:80 \
  -v $volume:/data \
  ghcr.io/huggingface/text-generation-inference:latest \
  --model-id $model \
  --max-total-tokens 8192 \
  --max-batch-prefill-tokens 4096
python
# TGI 调用(使用 HuggingFace 的 text_generation 客户端)
from text_generation import Client

client = Client("http://localhost:8080")
response = client.chat(
    messages=[
        {"role": "user", "content": "用一句话解释什么是梯度消失。"}
    ],
    max_new_tokens=200,
    temperature=0.5
)
print(response.choices[0].message.content)
三驾马车的选型速查
没有银弹,只有适合。下面的速查表帮你做第一轮筛选:
| 维度 | vLLM | SGLang | TGI |
|---|---|---|---|
| 首选场景 | 通用 API 部署 | Agent / 多轮对话 | HF 生态存量业务 |
| 核心优势 | PagedAttention + 生态成熟 | RadixAttention + 结构化生成 | 准确性 + 零配置 |
| 前缀缓存 | Automatic Prefix Caching (APC) | RadixAttention(基数树) | 不支持 |
| OpenAI 兼容 | ✅ 原生 | ✅ 原生 | ❌(需适配层) |
| HF Hub 兼容 | 中等 | 中等 | 🟢 完美 |
| 多 LoRA | ✅ | ✅ | ❌ |
| 2026 活跃度 | 🔥 持续迭代 | 🔥 高速迭代 | 🟡 维护模式 |
选 vLLM 因为你不想选错;选 SGLang 因为你需要更快;选 TGI 因为你今天下午就要上线到 HF Inference Endpoints 上——而且你老板绝不会容忍一次 down 机。
下一节,我们离开"够用"的舒适区,进入极致性能阵营——那些直接在 CUDA 底层动手、把显卡榨到最后一瓦特的硬件加速引擎。
6.5.2 极致性能与硬件加速阵营:算力榨汁机
上一节讲了以 vLLM 为代表的工业级高并发方案,它们解决的是"如何在生产环境中稳定地处理海量请求"。但如果你对延迟有近乎变态的要求——比如你需要把一张 H100 的吞吐从 3000 tokens/s 压榨到 5000 tokens/s,或者你需要让一个 130B 的模型在八卡集群上同步推理——那么你需要进入另一个领域:极致性能与硬件加速。
这个阵营的引擎有一个共同特点:它们不是在模型层面做优化,而是在算子级别、编译器级别、甚至 GPU 驱动级别重新定义推理的计算方式。 代价也显而易见——更高的上手门槛、更长的编译时间、以及更窄的硬件适用范围。
一、TensorRT-LLM / Triton Inference Server:NVIDIA 亲儿子的组合拳
如果说 vLLM 是站在 PyTorch 的地基上盖高楼,那 TensorRT-LLM 就是直接在 CUDA 的岩石层上打桩。
TensorRT-LLM 是 NVIDIA 官方推出的推理框架,它最核心的能力是图优化与算子融合——将 Transformer 模型中零散的 CUDA kernel 调用合并成少数几个高度优化的 kernel launch。举个例子,一个标准的 Attention 计算在 PyTorch 中可能涉及矩阵乘、Softmax、再矩阵乘三个独立操作,每次都要在 CPU 和 GPU 之间来回握手;TensorRT-LLM 把它们融合成一个 kernel,所有计算都在 GPU 内部一口气完成。这种"融合"的粒度细到令人发指——NVIDIA 甚至为特定架构(sm89、sm90a)单独编写了汇编级优化。
更重要的是,TensorRT-LLM 支持一种叫 In-Flight Batching(飞行批处理) 的调度策略。传统的 static batching 必须等一个 batch 内所有请求完成才处理下一批,短的请求被长的请求拖死;vLLM 的 continuous batching 解决了这个问题,但 TensorRT-LLM 在此基础上更进一步——它允许请求在 GPU kernel 正在执行的间隙插入或移除,实现了真正的"不停机调度"。这个设计带来的延迟改善在图文理解等多模态场景中尤为显著,因为不同请求的 token 长度差异极大。
与 TensorRT-LLM 配套的是 Triton Inference Server,这不是 OpenAI 那个 Python Triton,而是 NVIDIA 的多模型推理服务器。它的价值在于"多模型编排"——一个 Triton 实例可以同时托管 LLM、Embedding 模型、Ranking 模型,并通过 gRPC 或 HTTP 对外暴露统一接口。你的 RAG 系统不需要为每个模型单独部署一个服务,Triton 帮你搞定全部。
然而,TensorRT-LLM 的代价也很诚实:
- 编译时间长。 一个 LLaMA-70B 的 TensorRT 引擎编译可能需要 2-6 小时,且生成的 engine 文件绑定特定 GPU 型号(H100 编译的在 A100 上不能跑)。
- 模型覆盖有限。 只支持主流架构(LLaMA、GPT、Mixtral 等),遇到冷门模型需要自己写构建脚本。
- 调试困难。 一旦 kernel 层面出错,报错信息往往是 CUDA 错误码而非人类可读的日志。
一句话总结:如果你有 H100/B200、有专业的 SRE 团队、对延迟要求到毫秒级,TensorRT-LLM + Triton 是目前性能最强的组合。
下面是一个通过 Triton 启动 TensorRT-LLM 引擎的最小化部署示例。你需要在已有 Python 3.10+ 和 CUDA 12.x 的环境中安装相关依赖:
bash
# 安装 TensorRT-LLM(以 v0.15.0 为例,版本需匹配 CUDA 版本)
pip install tensorrt_llm==0.15.0 -U --extra-index-url https://pypi.nvidia.com

# 构建一个 LLaMA-7B 的 TensorRT 引擎(该步骤耗时长,生产环境通常离线构建)
# 先将 HuggingFace 模型转为 TensorRT 引擎
python /path/to/tensorrt_llm/examples/llama/build.py \
    --model_dir meta-llama/Llama-2-7b-hf \
    --dtype float16 \
    --use_gpt_attention_plugin float16 \
    --use_gemm_plugin float16 \
    --output_dir ./trt_engines/llama-7b-fp16

# 通过 Triton Inference Server 启动服务
# 将 triton_model_repo 指向包含 TensorRT 模型的目录
tritonserver --model-repository=/path/to/triton_model_repo --http-port=8000
python
# 客户端调用示例
import tritonclient.grpc as grpcclient
import numpy as np

# 连接到 Triton 服务
client = grpcclient.InferenceServerClient(url="localhost:8001")

# 准备输入(具体格式取决于模型配置,此处为示意)
input_ids = np.array([[1, 2, 3, 4]], dtype=np.int32)
input_tensor = grpcclient.InferInput("input_ids", [1, 4], "INT32")
input_tensor.set_data_from_numpy(input_ids)

# 发起推理
resp = client.infer(
    model_name="tensorrt_llm",
    inputs=[input_tensor],
    output_names=["output_ids"],
)
print(resp.as_numpy("output_ids"))
需要注意的是,实际部署 TensorRT-LLM + Triton 远比这个示例复杂——你通常需要理解 Triton 的 model configuration protobuf 格式、配置 dynamic batching 参数、以及设置适当的 KV cache 分块策略。但一旦配置正确,这套组合在 H100 上可以跑出单卡 5000+ tokens/s 的生成速度,是纯 PyTorch 推理的 3-5 倍。
二、TurboMind / LMDeploy:国产模型与国产硬件的深度适配
上海人工智能实验室(Shanghai AI Lab)的开源之作 LMDeploy,其推理核心就是 TurboMind。如果 TensorRT-LLM 是 NVIDIA GPU 上的性能天花板,那 TurboMind 就是国产模型和国产 GPU 生态中的最佳伴侣。
TurboMind 最独特的优势在于对开源中文大模型做了深度定制优化。它对书生(InternLM)、Qwen(通义千问)、DeepSeek 等模型有专门的 kernel 实现——不是通用框架"也能跑"的兼容模式,而是针对每个模型的 Attention 机制、激活函数和归一化层做了定制化加速。例如,InternLM2 的 MLA(Multi-Layer Attention)在通用框架中只能走串行计算,TurboMind 为其实现了 CUDA 级的并行融合。
另一个关键特性是 W4A16 量化——即 4-bit 权重量化、16-bit 激活计算。这种量化策略能在几乎不损失精度的情况下将显存占用降低到原来的 1/4,让一张 24GB 的 A10 显卡就能跑起原本需要 80GB 显存的 70B 模型。相比之下,TensorRT-LLM 更偏向 INT8 或 FP8 量化,对硬件有更高的架构要求。
TurboMind 还支持 PDL(Persistent Dynamic Lightweight)分离式前缀缓存。这个技术的本质是:在多轮对话中,系统提示词(system prompt)和前面几轮的历史 token 是重复出现的,TurboMind 会把它们的 KV Cache 持久化在显存中,新请求直接复用,不再重复计算。在 Agent 场景下(每轮都带长 system prompt),这个优化可以将首 token 延迟降低 60%-80%。
部署 LMDeploy 的体验非常简洁:
bash
# 安装
pip install lmdeploy

# 启动 API 服务(一行命令,自动识别模型架构)
lmdeploy serve api_server InternLM/internlm2-chat-7b --server-port 23333

# 使用 TurboMind 引擎(比默认 PyTorch 后端快 2-3 倍)
lmdeploy serve api_server Qwen/Qwen2.5-7B-Instruct \
    --backend turbomind \
    --server-port 23333
python
# 客户端调用——标准 OpenAI 兼容格式
from openai import OpenAI

client = OpenAI(
    api_key="not-needed",  # 本地服务无需认证
    base_url="http://localhost:23333/v1",
)

resp = client.chat.completions.create(
    model="Qwen2.5-7B-Instruct",
    messages=[{"role": "user", "content": "用 Python 写一个快速排序"}],
    temperature=0.7,
)
print(resp.choices[0].message.content)
LMDeploy 的另一大亮点是原生支持 OpenVINO 和 Huawei Ascend NPU,这让它在国产硬件生态中有独特地位。如果你的部署环境是昇腾 910B 或者寒武纪 MLU,TurboMind 可能是你为数不多能跑出生产级性能的选择。
一句话总结:跑国产模型、用国产 GPU、或者需要 W4A16 极限量化——TurboMind 是你的首选。
三、DeepSpeed-MII:分布式推理的巨兽驾驭者
微软的 DeepSpeed-MII(Model Implementations for Inference)不关心单卡跑多快——它关心的是如何让 100B+ 的超大模型在多台机器、多张显卡上高效协同推理。
这个定位决定了它的核心技术路线:
张量并行(Tensor Parallelism):将模型的一层的权重矩阵切分到多张 GPU 上,每张卡计算一部分然后 AllReduce 汇总。这是单机多卡最常用的并行策略。
流水线并行(Pipeline Parallelism):将模型按层切分,GPU0 负责前 10 层,GPU1 负责中间 10 层,以此类推。配合 micro-batch 交织调度,最大化每张卡的利用率。
ZeRO-Inference:延续 DeepSpeed 训练框架的 ZeRO 思想,在推理时也采用分片存储——模型的权重、优化器状态和梯度的存储分散到所有 GPU,只在计算需要时才临时汇聚。这几乎是将显存利用率推到了理论极限。
这三种策略可以任意组合,形成所谓的 3D 并行。对于 LLaMA-405B 这样的大模型,你需要 8 张 80GB A100 才能装下权重,但通过 DeepSpeed 的 ZeRO-3 切分 + 张量并行,同样的任务 4 张卡就能跑——显存效率直接翻倍。
DeepSpeed-MII 的 API 设计也很务实,屏蔽了底层的并行复杂度:
bash
# 安装
pip install deepspeed-mii

# 部署 LLaMA-2-70B(如有多卡,自动启用张量并行)
deepspeed --num_gpus 4 mii-deploy \
    --model "meta-llama/Llama-2-70b-hf" \
    --tensor-parallel 4 \
    --dtype fp16
python
# 客户端调用
import mii

# 连接到 DeepSpeed-MII 服务
client = mii.client("meta-llama/Llama-2-70b-hf")
output = client.generate(
    ["Explain the transformer architecture in three sentences."],
    max_new_tokens=200,
)
print(output[0])
需要注意,DeepSpeed-MII 的部署对分布式集群环境有较高要求——你需要配置 NCCL 通信、InfiniBand 网络、以及节点间的 SSH 免密。它在单机场景下不如 vLLM 方便,在极端性能压榨上不如 TensorRT-LLM。但如果你确实需要推理一个 100B+ 的模型,且预算不允许你买那么多 H100——它会是你手上最锋利的刀。
小结
| 引擎 | 核心优势 | 最佳场景 | 主要代价 |
|---|---|---|---|
| TensorRT-LLM + Triton | CUDA 级算子融合,延迟最低 | H100/B200,专业运维团队 | 编译 2-6 小时,模型覆盖窄 |
| TurboMind / LMDeploy | 国产模型深度优化,W4A16 量化 | 中文大模型,国产 GPU | 国际模型优化不如 TensorRT |
| DeepSpeed-MII | 分布式推理,3D 并行 | 100B+ 超大模型,多机多卡 | 单卡性能一般,集群配置复杂 |
这三个引擎的选择决策很简单:你的 GPU 是什么、你的模型多大、你的延迟要求多变态——这三个问题回答完了,答案就出来了。下一节我们将转向另一个极端:没有 GPU 或者只有消费级设备时,你能用什么。
6.5.3 跨平台与边缘计算阵营("随处可跑")
前面两节的工具,无论是 vLLM 还是 TensorRT-LLM,都默认你手里有一块或多块数据中心级的 GPU。但现实是:你可能在自己的 MacBook 上做实验,在只有 CPU 的云服务器上跑后台任务,甚至需要在 Windows 工控机上嵌入一个轻量推理模块。不是每个人都拥有 H100,但每个人都有一台能跑推理的机器。 本章要介绍的四个工具,覆盖的就是从"笔记本"到"边缘设备"的完整光谱。
llama.cpp:让大模型飞入寻常 CPU
如果说 TensorRT-LLM 是给 F1 赛车定制的燃油配方,那 llama.cpp 就是把引擎拆下来、重新设计成能烧 92 号汽油的奇迹。它是开源社区最具传奇色彩的项目之一——用纯 C/C++ 重写了 Transformer 推理的全链路,目标只有一个:让大模型在 CPU 上也能跑。
llama.cpp 的核心武器是 GGUF 格式(GGML Unified Format)。这是一种专为 CPU 推理优化的模型序列化格式,它把模型权重、分词器、超参数打包进一个文件,并且支持多种量化精度:从 q2_k(极限压缩,适合老旧设备)到 q8_0(准无损,适合本地实验)。一个 70B 的模型,用 Q4_K_M 量化后可以塞进 40GB 内存的 Mac 上勉强跑起来——这在 GGUF 出现之前是不可想象的。
更关键的是,llama.cpp 不仅仅是一个推理库。它自带了一个完整的 HTTP Server(llama-server),提供与 OpenAI 兼容的 /v1/chat/completions 接口。这意味着你用 llama.cpp 启动一个本地模型后,任何基于 OpenAI SDK 编写的代码都能无缝切换过来,只需要把 base_url 指向 http://localhost:8080。
bash
# 下载 GGUF 模型并启动服务
llama-server -m qwen2.5-7b-instruct-q4_k_m.gguf --port 8080
在 2026 年,llama.cpp 已经成为个人开发者本地实验的绝对首选。Ollama(见 §6.5.5)的底层推理引擎正是 llama.cpp——它把命令行封装成了更友好的 Modelfile,但如果你追求极致控制、喜欢手动调参,llama.cpp 才是直抵核心的路径。
Xinference:一个框架搞定全栈 AI
如果说 llama.cpp 解决的是"怎么跑"的问题,那 Xinference 解决的是"跑什么"的问题。它是国内开源社区中最具雄心的推理集成框架,由 xorbits 团队(NumPy 加速库 Xorbits 的作者)出品。
Xinference 最大的特点不是快,而是全。它不仅支持 2026 年主流的 LLM(包括 Qwen、DeepSeek、GLM、Llama 系列),还统一纳管了:
- 语音识别(ASR):集成 FunASR 和 Whisper,可以直接部署语音转文字服务;
- 图像生成:支持 Stable Diffusion 系列(SD1.5 到 SDXL),通过 Web UI 即可管理文生图模型;
- 向量化(Embedding):内置 BGE、M3E 等主流嵌入模型,开箱即用于 RAG;
- 重排序(Rerank):集成 bge-reranker,为检索结果精排提供支持。
这意味着,如果你想搭建一个完整的"AI 中台"——文本对话 + 语音转文字 + 文档检索 + 图片生成——Xinference 一个框架就能全部搞定,不需要分别部署 vLLM、TEI 和 ComfyUI。它提供了 Web 管理界面和 RESTful API,模型的上传、启动、扩缩容都可以在浏览器里点几下完成。
对于中小团队来说,这种"一站式"体验的价值在于降低认知负载。你不需要了解每个后端的量化参数和 CUDA 版本兼容性,Xinference 帮你完成了这个脏活。当然,代价是它的单卡吞吐量不如 vLLM 或 SGLang 这些专项引擎——它是瑞士军刀,不是手术刀。
ONNX Runtime GenAI:把模型变成 .exe
微软的 ONNX Runtime GenAI(以下简称 ORT GenAI)走的是另一条完全不同的路。它不关心 Python 生态的便利性,而是致力于一个目标:让 AI 推理像普通 Windows 软件一样分发和运行。
ORT GenAI 的核心思路是:将 HuggingFace 格式的模型转换为 ONNX 中间表示(Open Neural Network Exchange),然后通过 ORT 的跨平台运行时执行推理。这个过程屏蔽了底层框架差异——无论原始模型是 PyTorch 还是 TensorFlow 训练的,转成 ONNX 之后,推理链路就统一了。
这个方案的独特价值在于部署形态。传统的大模型推理服务需要 Python 环境、PyTorch、CUDA 工具链——一套下来动辄几个 GB 的依赖。而 ORT GenAI 可以直接编译为原生二进制,在 Windows 上就是一个 .exe 文件,在 C# 应用里就是一个 NuGet 包。对于需要将 AI 嵌入到桌面软件或工控设备的场景,这种"去 Python 化"的能力是不可替代的。
不过,ORT GenAI 的覆盖率在 2026 年仍然有限。它的模型库主要覆盖 Phi、Llama、Mistral 等主流基础模型,对国产模型和新兴架构的支持相对滞后。如果你的技术栈恰好落在微软生态内,它是一个优雅的选择;如果不是,它的学习成本可能比直接用 llama.cpp 更高。
CTranslate2:CPU 上的翻译加速专家
如果说前面三个工具都是"通用型"引擎,CTranslate2 的定位则更加精准:为 Transformer 模型在 CPU 上提供极致的推理加速。 它的作者是 OpenNMT 项目团队,因此它的核心场景天然偏向机器翻译和文本生成任务。
CTranslate2 的加速来源于两个核心优化。第一,它把模型权重量化为低精度整数(INT8/INT16),在 CPU 上利用现代指令集(AVX2、AVX-512)做向量化运算。第二,它对注意力机制做了算法层面的重构——将自注意力的 Key/Value 缓存压缩为更紧凑的表示结构,显著降低了长序列推理时的内存占用。
在翻译类任务上,CTranslate2 的表现堪称惊艳。以 Opus-MT 这类翻译模型为例,CTranslate2 在纯 CPU 环境下的速度可以达到 PyTorch 原生的 3-4 倍。如果你需要部署一个不依赖 GPU、吞吐量又高的多语言翻译服务,它是最务实的选择。
将它放入本章,是因为它代表了一种重要的工程思想:不求大而全,只在对的方向上做到极致。 当其他引擎在拼 H100 吞吐量的时候,CTranslate2 在思考怎么让一台二手 Xeon 服务器也能稳定地跑翻译——这种"工具即场景"的定位,对于大模型架构师的选型决策而言,比性能数字更有启发。
读完这四个工具,你应该能感受到这个阵营的独特气质:它们不是给数据中心设计的,但它们让推理变得无处不在。llama.cpp 让 CPU 不再是二等公民,Xinference 把多模态 AI 的管理成本降到零,ORT GenAI 把 AI 从 Python 环境中解放出来,CTranslate2 则证明了"专精一样"也有自己的市场。下一节,我们将离开通用推理的赛道,去看一个完全不同的战场——专为向量化和重排序设计的 TEI。
6.5.4 特殊用途引擎:RAG 管道中最容易被忽视的加速器
前面三大阵营——工业高并发、极致加速、跨平台——解决的是同一个问题:让大模型"说话"更快。但在 2026 年的实际生产环境中,大模型"说话"只占整个推理管道的一小部分。当你的应用需要先检索 10 万份文档,再让模型基于检索结果回答问题,真正拖慢系统的,往往不是模型推理本身,而是"查找相关资料"这一步。
这就是本节要讨论的:特殊用途引擎。它不为对话而生,而是为 RAG(检索增强生成)架构中的核心预处理步骤——向量化(Embedding) 与 重排序(Reranking) ——提供专用加速。
TEI(Text Embeddings Inference):专为"查资料"设计的加速引擎
TEI 的全称是 Text Embeddings Inference,由 Hugging Face 团队开发维护。把它放进"推理引擎"这个话题下,可能会让很多人困惑——因为它根本不参与文本生成。但把它放在这里,恰恰是为了帮你建立正确的认知模型:RAG 管道中,向量化和重排序的计算开销往往被严重低估。
一个典型的 RAG 请求流程是这样的:
用户提问
  → Embedding 模型将问题向量化(一次推理)
    → 向量数据库中检索 Top-K 相关文档
      → Rerank 模型对 Top-K 重新排序(若干次推理)
        → 拼接上下文 + 原始问题 → 发给 LLM 生成回答
在这个流程里,如果你用 vLLM 或 SGLang 跑 LLM 推理,它确实很快。但 Embedding 和 Rerank 步骤如果也跑在通用推理引擎上,性能就会严重退化——通用引擎的 Continuous Batching、PagedAttention 等优化都是为自回归生成设计的,对 Embedding 任务不仅没有帮助,反而会增加延迟开销。
TEI 的解决思路是"术业有专攻"。 它在以下几个方面做了深度专项优化:
- Flash Attention 专项适配:TEI 内置了针对 BERT 架构(Embedding 模型的主流骨架)和现代 decoder-only 架构 Embedding 模型的 Flash Attention 内核,在大批量向量化场景中吞吐量可达通用方案的 3-5 倍。
- Token 级池化策略:Embedding 模型输出的是 token 级向量,需要池化为一个文档级向量。TEI 支持
cls、mean、last_token等多种池化模式,并且这些操作在 GPU 上原地完成,不产生 CPU-GPU 之间的数据传输抖动。 - 原生 Rerank 支持:TEI 是少数将 Rerank 作为一等公民支持的引擎。它为交叉编码器(Cross-Encoder)——Rerank 模型的核心架构——提供了专门的批处理优化,在知识库检索的"质量最后一公里"上形成显著差异。
- 与 Hugging Face 生态深度集成:任何 Hugging Face Hub 上的 Embedding 或 Rerank 模型,一条命令即可部署。不需要写推理代码,不需要手动处理 tokenizer。
一句话总结 TEI 的定位:vLLM 让 LLM 说话快,TEI 让 LLM 找到该说的话。在 RAG 架构中,这两件事同样重要。
这个类别为什么单独存在?
把 TEI 和 vLLM、llama.cpp 放在同一层讨论,还有一个更深层的原因:推理引擎正在从"通用对话加速"走向"任务特化"。2024 年,大家关心的是哪个引擎跑对话最快。到了 2026 年,成熟的 RAG 系统架构师会问另一个问题:我的 Embedding 服务、Rerank 服务、对话生成服务,是否需要不同的后端?
答案越来越明确:是。 就如同你不会用同一台机器既跑数据库又跑 Web 服务器,将 Embedding/Rerank 与对话生成分离到专用引擎上,是现代 RAG 系统的基本架构原则。TEI 是这个原则目前最成熟的实践范本。
从下一节开始,我们将离开推理加速这个主题,进入一个更靠近开发者日常体验的话题:Ollama。如果说 llama.cpp 让模型在任何硬件上都能跑起来,Ollama 要解决的问题更"人性化"——让模型的拉取、配置和管理,像操作 Docker 容器一样简单。
6.5.5 Ollama:本地模型的"Docker"与分发标准
上一节讲 llama.cpp,我们得到了一个能在各种硬件上裸跑 GGUF 模型的"发动机"。但发动机装好了,你还得自己配燃油比、调点火正时、搞定散热系统——这是乐趣,也是负担。Ollama 要做的事情很简单:把发动机装进一个有方向盘、仪表盘和空调的车厢里。
在 2026 年,Ollama 已经成为个人开发者和轻量级企业部署的事实标准。它的最大创新不在于推理性能(底层就是 llama.cpp),而在于把模型量化、参数配置和环境依赖,封装成了类似 Dockerfile 的 Modelfile。这让大模型的"构建—分发—运行"流程,第一次有了和容器镜像同等体感的开发体验。
快速体验:三分钟上手
如果你还没用过 Ollama,下面三行命令就是它的全部入门成本:
bash
# macOS/Linux 安装(一条命令)
curl -fsSL https://ollama.com/install.sh | sh

# 拉取并运行 DeepSeek
ollama run deepseek-v3:14b
第一条命令安装 Ollama 服务(后台常驻进程 ollama serve),第二条命令自动下载并启动对话。如果你用的是带 GPU 的机器,Ollama 会自动检测 CUDA/Metal 并将模型加载到显存;如果你只有 CPU,它也能跑——不过速度会慢一个数量级。你不需要手动指定量化精度、不需要配置 CUDA 版本、不需要处理 Python 环境。这就是 Ollama 的核心体验:大模型不再是研究者的玩具,而是普通开发者的命令行工具。
为什么它在 2026 年绕不开?
Agent 工具链的默认后端。 你每天可能已经在用 Ollama,只是没有意识到。从 Claude Code(cc)到 OpenClaw,从 Continue 到 Cursor 的本地模式,2026 年几乎所有主流 AI 编程和 Agent 工具的原厂配置中,都能找到 Ollama 的 API 端点选项。这不是巧合——Ollama 提供了一个零配置、跨平台(macOS/Linux/Windows)的本地模型运行时,让这些工具可以只写一套 OpenAI 兼容代码,就能在用户本地无缝启动推理服务。
"拉取即用"的模型管理。 拉一个模型不再是"找 GGUF 下载链接 → 手动下载 → 配置路径 → 指定量化参数"这个流程。一条 ollama pull deepseek-v3,Ollama 自动完成分片下载、校验和 GPU Offloading。你甚至可以同时管理多个模型:
bash
ollama pull qwen2.5-coder:14b      # 编程专用
ollama pull llama3.2-vision:11b    # 看图写报告
ollama pull mxbai-embed-large      # Embedding 向量化
ollama list                         # 查看本地已有模型
Ollama Library 的作用在这里体现得最清楚——它像一个本地模型版的 Docker Hub。社区微调的模型被标准化为 {name}:{tag} 格式,任何人都可以像拉取容器镜像一样获取、切换。对于团队来说,这意味着"对齐环境"的成本几乎为零。
Modelfile 将配置固化,实现模型的可复现分发。 这是 Ollama 对模型分发的最大贡献。Modelfile 的定义和 Dockerfile 在哲学上一模一样——用声明式语法描述"这个模型需要什么 System Prompt、什么推理参数",然后通过 ollama create 生成一个可复现的模型镜像。来看一个典型 Modelfile:
dockerfile
# Modelfile
FROM ./qwen2.5-7b-finetuned-q4_k_m.gguf

PARAMETER temperature 0.7
PARAMETER top_p 0.9
PARAMETER num_ctx 32768
PARAMETER stop "<|im_end|>"

SYSTEM """
你是一个专业的技术文档写作助手。
回答应当结构清晰、有代码示例。
"""
然后通过一条命令生成私有模型:
bash
ollama create tech-writer -f Modelfile这个 Modelfile 定义了一整套运行时行为:基础模型是微调后导出的 GGUF 文件,温度、top_p、上下文窗口、停止标记和 System Prompt 全部固化在镜像里。任何一个同事拿到这个 Modelfile + GGUF 文件,执行同一条 ollama create 命令,就能得到一个与你完全一致的行为环境。"在我的机器上能跑"从此不再是借口。
大模型架构师的三个最佳实践
Ollama 的默认配置适合个人实验,但生产环境需要调优。以下是 2026 年实际项目中被反复验证的三个关键配置。
1. 并发:OLLAMA_NUM_PARALLEL
Ollama 的默认行为是同一时刻只处理一个请求。这对个人在终端里敲 ollama run 来说完全够用,但如果你把 Ollama 作为整个开发团队的共享后端,10 个人同时问 Continue 就要排队了。
bash
# 启动 Ollama 服务时指定并行请求数
OLLAMA_NUM_PARALLEL=4 ollama serve
在 2026 年的实测中,设置为 4 是一个"黄金比例"——对于消费级 GPU(RTX 4090,24GB 显存)跑 7B 量化模型时,4 路并发能充分利用 GPU 的批处理能力,而不会触发 OOM。如果你的场景是单用户高并发(比如 Agent 同时开了 10 个并行工具调用),建议设为 8 甚至更高,前提是显存充足。
2. KV 缓存量化:OLLAMA_KV_CACHE_TYPE
长上下文是高成本操作。当你让模型分析一个 10000 行的代码文件,Attention 的 Key/Value 缓存本身就可能吃掉几个 GB 显存。Ollama 提供了 KV 缓存的量化选项,用精度换空间:
bash
# q8_0(~2x 压缩)→ q4_0(~4x 压缩)
OLLAMA_KV_CACHE_TYPE=q4_0 ollama serve对于代码审查、长文档分析等场景,q8_0 是性价比最高的选择——压缩率接近 2 倍,质量损失在大多数 benchmark 上小于 1%。q4_0 则适合极端场景(如 32K 上下文 + 消费级显卡),代价是注意力精度可能下降 3-5%,对数学密集型任务不友好。如果你跑的是编程类模型(如 Qwen-Coder),建议至少用 q8_0,因为代码逻辑对注意力精度更敏感。
3. OpenAI API 兼容:改一行 base_url 即可迁移
这是 Ollama 在工程上最务实的决策:原生提供与 OpenAI 完全兼容的 /v1/chat/completions 接口。
python
from openai import OpenAI

# 改为调用本地 Ollama,只改一行:
client = OpenAI(
    base_url="http://localhost:11434/v1",  # Ollama 默认端口
    api_key="ollama"                        # 本地无需真实 API Key
)

response = client.chat.completions.create(
    model="deepseek-v3:14b",
    messages=[{"role": "user", "content": "用四句话解释 PagedAttention 的原理"}]
)
print(response.choices[0].message.content)
这段代码可以直接运行——只要本地 Ollama 服务已启动且 deepseek-v3:14b 已拉取。它的"杀伤力"在于:任何基于 OpenAI SDK 编写的应用程序,切换到本地模型只需改两行配置。所有现有的 LangChain、LlamaIndex、AutoGen、CrewAI 代码,不需要修改任何业务逻辑,就能从云端 API 无缝迁移到本地 Ollama。这对于"开发阶段用本地模型省钱,部署阶段上云端 API 追求性能"的混合策略来说,几乎是零切换成本。
闭环:从微调到分发的私有化模型流水线
Ollama 真正的价值,要放进一条完整的"私有化模型生产流水线"里才能看全。这条流水线在 2026 年的企业 AI 实践中已经成为标配:
text
LLaMA-Factory 微调 → 导出 GGUF → 编写 Modelfile → ollama create → 全公司分发具体来说:
在 LLaMA-Factory 中完成微调。用你的业务数据(客服对话、内部 wiki、代码仓库)对基座模型做 LoRA 微调,产出一个理解你公司术语和规范的专属权重。
导出为 GGUF 格式。LLaMA-Factory 原生支持将 LoRA 权重合并后直接导出为 GGUF,选择合适的量化级别(如
q4_k_m平衡体积和质量,或q8_0追求准无损推理),得到一个.gguf文件。编写 Modelfile。将 GGUF 文件路径、System Prompt(例如"你是 XX 公司的内部技术支持,请优先从内部知识库中引用信息")、推理参数写入 Modelfile。
生成私有模型镜像:
ollama create my-company-model -f Modelfile。这一条命令将 GGUF + 配置 + Prompt 打包成一个 Ollama 可识别的本地"镜像"。分发。团队成员通过
ollama pull从内部 Registry 拉取,或将 Modelfile + GGUF 文件通过 Git LFS 分发,各自在本地执行ollama create。
这条流水线将"模型微调"从研究员手上的 Jupyter Notebook 实验,变成了软件工程的标准化产线。正如 Docker 让应用从"在我机器上能跑"进化到"在任何机器上都能跑",Ollama 的 Modelfile 正在让大模型从"在我们的 GPU 服务器上能用"进化到"在团队每个人电脑上都能用"。
这就是 Ollama 在 2026 年的生态位:它不追求极限的吞吐量和最低的延迟——那是 vLLM 和 TensorRT-LLM 的领域。但它是让私有化模型从"能跑"变成"好用"的那最后一公里。当你需要在团队中快速对齐模型环境,或者让 Agent 工具在你的 MacBook 上无障碍运行时,Ollama 是当前最务实的选择。
下一节我们将走出单引擎的世界,进入一个更复杂但更真实的生产场景:当你需要同时对接 OpenAI、Anthropic、本地 vLLM 和 Ollama 时,如何用 LiteLLM 统一所有协议。
6.5.6 协议转换的路由器:LiteLLM
上一节介绍了 Ollama,它将本地模型封装成类似 Docker 容器的运行单元,还贴心地暴露了 OpenAI 兼容的 API 端点。但现实世界中,你可能同时对接 OpenAI、Anthropic、本地 Ollama、自建的 vLLM 集群、国产模型的私有网关……如果每接一个新的模型后端都要写一套适配代码,这跟水管工每接一根新管子就得换一套扳手有什么区别?
LiteLLM 就是那把"万能扳手"。
协议大一统:用一套格式调用 100+ 模型
LiteLLM 的核心理念非常简单:它将 100 多种不同厂商的 API(从 GPT-4o 到 DeepSeek-V3,从 Ollama 到 Vertex AI),全部翻译成 OpenAI 的请求/响应格式。对上层应用来说,你永远只跟一个"OpenAI"对话,而 LiteLLM 在底层帮你完成所有的协议转换、认证适配和重试逻辑。
python
import litellm

# 同一套调用方式,后端可以完全不同
response = litellm.completion(
    model="openai/gpt-4o",
    messages=[{"role": "user", "content": "总结这份财报"}]
)

response = litellm.completion(
    model="deepseek/deepseek-chat",  # 或 "ollama/llama3"
    messages=[{"role": "user", "content": "总结这份财报"}]
)
关键点在 model 参数的前缀:openai/、anthropic/、ollama/、huggingface/、vertex_ai/、bedrock/……只需替换这个前缀,你的代码一行不改,就能在几十个模型之间自由切换。对于需要频繁做 A/B 测试、模型对标的团队来说,这个能力节省的不是几分钟,而是数周的适配工作量。
不只是翻译器:生产级的网关能力
如果 LiteLLM 只做协议转换,它就是一个"翻译器"。但 2026 年的 LiteLLM 远不止于此——它已经进化为一款生产级的 AI Gateway,对标 Kong 或 Nginx 在传统 API 管理中的角色。
负载均衡与自动故障切换
这是生产环境中最"救命"的功能。你可以配置一组备选模型,当主模型超时、限流或不可用时,LiteLLM 自动降级到备选模型:
python
from litellm import Router

router = Router(
    model_list=[
        {
            "model_name": "gpt-4o",
            "litellm_params": {
                "model": "azure/gpt-4o",
                "api_key": "azure-key",
                "rpm": 60
            }
        },
        {
            "model_name": "gpt-4o",
            "litellm_params": {
                "model": "openai/gpt-4o",
                "api_key": "openai-key"
            }
        }
    ],
    fallbacks=[{"gpt-4o": ["gpt-4o-mini"]}],
    num_retries=3
)

response = await router.acompletion(
    model="gpt-4o",
    messages=[{"role": "user", "content": "你好"}]
)
Router 会自动在 Azure 和 OpenAI 两个 GPT-4o 实例之间做负载均衡;当两者都不可用时,降级到 gpt-4o-mini 兜底。对于依赖大模型的核心业务——比如金融风控、实时客服——这种"软着陆"能力不是锦上添花,而是刚需。
更进一步,LiteLLM 支持 回退链(Fallback Chain)——当主模型不可用时,可以依次尝试多个备选模型,而不是直接跳到最后一个兜底模型:
python
# 多级回退:gpt-4o → claude-sonnet-4 → deepseek-chat → gpt-4o-mini
fallbacks_list = [
    {"gpt-4o": ["claude-sonnet-4"]},
    {"claude-sonnet-4": ["deepseek-chat"]},
    {"deepseek-chat": ["gpt-4o-mini"]}
]
成本追踪与速率控制
LiteLLM 内置了 Token 消耗统计,你可以精确知道每次调用花了多少钱。当你的系统同时使用 DeepSeek(约 ¥1/百万 Token)和 Claude Opus(约 $15/百万 Token)时,这种差异一目了然。配合 Router 的 rpm(每分钟请求数)和 tpm(每分钟 token 数)限制,你能在预算可控的前提下最大化吞吐。
LiteLLM 还支持基于成本的智能路由(Cost-Based Routing)——当多个模型都能完成同一任务时,Router 自动选择最便宜的那个,只在高价模型的结果显著优于低价模型时才切换。这是预算敏感的初创团队最实用的功能之一。
快速启动:从零到运行只需三行命令
LiteLLM 的安装和启动非常简洁:
bash
pip install 'litellm[proxy]'版本安全提示:截至 2026 年 6 月,安全版本为 v1.83.0+。避免安装 v1.82.7 和 v1.82.8(已被确认含恶意代码)。建议在生产环境中固定版本号:
pip install litellm==1.83.0[proxy]。
[proxy] 是额外依赖组,安装代理模式所需的 fastapi、uvicorn 等组件。装好后,直接启动代理服务器:
bash
litellm --model ollama/deepseek-v3此时 LiteLLM 会在 http://localhost:4000 启动一个兼容 OpenAI 格式的 API 端点。任何向 http://localhost:4000/v1/chat/completions 发送的 OpenAI 格式请求,都会被自动转发到本地的 Ollama DeepSeek-V3 模型。如果你之前用 OpenAI SDK 写的代码,只需改一行 base_url,就能无缝切换。
对于多模型场景,推荐使用 YAML 配置文件来管理所有后端:
yaml
# litellm_config.yaml
model_list:
  - model_name: cheap-model
    litellm_params:
      model: deepseek/deepseek-chat
      api_key: ${DEEPSEEK_API_KEY}
      rpm: 120
  - model_name: smart-model
    litellm_params:
      model: anthropic/claude-sonnet-4-20250514
      api_key: ${ANTHROPIC_API_KEY}
      rpm: 50

general_settings:
  master_key: ${LITELLM_MASTER_KEY}

router_settings:
  num_retries: 3
  allowed_fails: 10
  cooldown_time: 30
  routing_strategy: "usage-based"  # 可选: latency-based, cost-based
然后启动:
bash
litellm --config litellm_config.yamlAgent 开发者的"解耦层"
这正是 LiteLLM 对本书核心主题——Agent 开发——最重要的价值所在。
当你用 LangChain、CrewAI 或 OpenClaw 构建 Agent 时,Agent 的逻辑层本质上不关心调用的到底是 DeepSeek 还是 Claude——它只关心"我拿到了一段高质量的推理结果"。但如果你把模型选择硬编码在 Agent 代码里,那么切换后端就意味着动代码、重新测试、重新部署。
LiteLLM 充当了一个"协议中间层":Agent 只面向 LiteLLM 的 OpenAI 标准接口编程,后端的模型选择、切换、限流、容灾全部由 LiteLLM 的配置文件管理。举个实际的例子:
python
# Agent 代码 — 完全不需要知道后端是谁
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:4000/v1",
    api_key="not-needed"  # LiteLLM 自己处理认证
)

# Agent 调用"便宜模型"做批量分析
response = client.chat.completions.create(
    model="cheap-model",
    messages=[{"role": "user", "content": "分析 1000 条用户评论中的情感趋势"}]
)
运维同学可以随时在 LiteLLM 的 YAML 配置中把 cheap-model 从 DeepSeek 替换为 Qwen3-Max,或新增一个部署在美国西岸的负载均衡节点——Agent 代码纹丝不动。
这就是架构师常说的 关注点分离(Separation of Concerns):Agent 逻辑与推理引擎之间的解耦,能让你的系统在模型快速迭代的 2026 年始终保持灵活性。你可以在凌晨 3 点静默切换模型后端,而你的用户——以及你的 Agent——甚至不会察觉到任何变化。
什么时候不需要 LiteLLM
没有"永远正确"的工具。LiteLLM 引入了一个额外的网络跳转(你的应用 → LiteLLM Proxy → 模型后端),在以下场景中这个开销可能得不偿失:
- 单一模型后端:如果你只对接 OpenAI 或只对接本地的 Ollama,直接使用原生 SDK 更简单,延迟也更低。
- 极致延迟要求:在实时语音对话等对延迟要求达到百毫秒级的场景下,每一层代理都会增加尾部延迟。
- 已有 API 网关:如果你的基础设施中已经部署了 Kong、Envoy 等 API 网关,它们已有的限流、认证和路由能力可能与 LiteLLM 的功能重复。
本质上,LiteLLM 解决的是"多模型异构"问题。当你的系统中只存在一个模型时,问题本身就不存在——不需要一个解决方案来"解决不存在的问题"。
安全性警示
作为一本立足 2026 年的工程实战指南,我们必须提一个重要的安全事件:2026 年 3 月 24 日,LiteLLM 的 PyPI 包(v1.82.7 和 v1.82.8)被发现存在供应链投毒,攻击者通过 CI/CD 流水线中的 Trivy 依赖漏洞注入恶意代码。这两个版本在 PyPI 上存活了约 40 分钟后被下架。安全版本 v1.83.0 已于 3 月 30 日通过全新的 CI/CD v2 流水线发布。
这次事件给所有开发者的警示是清晰的:在生产环境中,优先使用 Docker 镜像部署而非直接从 PyPI 安装包。官方 LiteLLM Proxy Docker 镜像在攻击中全程未受影响,因为它通过 requirements.txt 锁定依赖版本,不依赖 PyPI 的即时拉取。同时,定期的依赖审计(如 pip-audit、safety 工具)和版本锁定(pip freeze > requirements.txt 而不是 pip install litellm),是 2026 年任何 AI 基础设施的基本操作。
小结
在 Ollama 帮你管理本地模型、vLLM 帮你提供高并发推理之后,LiteLLM 完成了"推理引擎全景图"的最后一块拼图——通信协议的标准化。它让分布在不同云、不同机房、不同框架背后的 100+ 模型,对你的代码呈现为同一个接口。配合 Router 的负载均衡、自动故障切换和成本路由能力,它是生产级 Agent 系统不可或缺的"网关大脑"。
但截至目前,我们讨论的都还是纯文本模型。当你的业务需要生成图像、合成语音、识别视频时,整个推理引擎的版图又会发生怎样的变化?下一节,我们进入多模态推理的世界。
6.5.7 多模态推理的"流水线":Diffusers、ComfyUI 与工作流引擎
前面六个阵营解决的都是文本模型的推理问题——自动回归地生成 token,按序列依次产出文字。但当你把镜头转向图像和视频生成时,推理逻辑发生了根本性的变化。图像生成不是"写"出来的,是"去噪"出来的。 一张图片在隐空间中经历数十步迭代去噪,每一步都依赖前一步的输出,整个推理过程更像一条精密的生产流水线,而非打字机那样一行行输出。
这条流水线上的核心工具,就是 Diffusers、ComfyUI,以及经典的 WebUI 阵营。
Diffusers:视觉生成的"零件库"
如果你在 2026 年想要基于 Stable Diffusion、Flux 或 Kandinsky 等模型开发定制化的图像生成 Agent,Diffusers 是你绕不开的代码底座。
它不是推理引擎,而是构建推理管线的零件库。 它由 Hugging Face 维护,提供了组成一条扩散模型推理管线的所有标准组件:文本编码器(将 prompt 转为向量)、UNet(去噪过程的核心网络)、调度器(控制每一步去噪的强度)、以及 VAE(隐空间与像素空间的编解码)。你可以像搭积木一样组合这些零件,也可以直接调用它封装好的高级 Pipeline。
以下是一个最简化的、可在单卡上运行的文本到图像 Pipeline:
python
from diffusers import StableDiffusionPipeline
import torch

# 加载预训练模型(首次运行会自动下载到 HF cache)
pipe = StableDiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-2-1",
    torch_dtype=torch.float16,
    use_safetensors=True
)
pipe = pipe.to("cuda")  # 移至 GPU

# 一行生成
image = pipe(
    prompt="A serene lake at sunset, oil painting style",
    negative_prompt="blurry, low quality",
    num_inference_steps=25,
    guidance_scale=7.5
).images[0]

image.save("sunset_lake.png")
代码本身并不复杂——Diffusers 把所有复杂度封装在了 from_pretrained 和 __call__ 两个接口里。但真正值得关注的是它的可组合性。如果你的 Agent 需要先用 ControlNet 提取参考图的姿态骨架、再用 IP-Adapter 注入风格、最后在自定义的 LoRA 下生成结果,Diffusers 允许你将这些模块按需拼接到同一根管线上。它是所有上层视觉工具(ComfyUI、A1111 等)共享的底层依赖,也是你从"调预训练模型"走向"设计生成管线"的转折点。
ComfyUI:专业视觉创作的工作流引擎
如果你对 Diffusers 的印象是"像搭积木一样搭管线",那 ComfyUI 就是把搭好的积木图变成了可执行、可复用、可量产的工程资产。
ComfyUI 在 2026 年已是专业视觉创作领域的事实标准。 它将推理过程抽象为一张节点图——每个节点(Load Checkpoint、CLIP Text Encode、KSampler、VAE Decode)代表管线中的一个步骤,节点之间的连线代表数据流转。这张图不是一个静态的示意图,而是可以执行的推理程序。
它的核心竞争力有两点。
第一,极致的显存管理。传统的一次性加载整个管线的做法,会在 GPU 显存中同时驻留多个模型组件。ComfyUI 按节点按需加载和卸载模型,在 24G 的 RTX 4090 上就可以进行 4K 分辨率的视频生成和复杂图像合成——这在传统方案下需要 48G 以上的显存。
第二,完整的 API 驱动能力。ComfyUI 不只是鼠标连线的图形界面,它提供了完整的 REST API 和 WebSocket 接口,允许你的 Python 程序通过 JSON 发送工作流来驱动图像生成。这意味着你可以在 Agent 的逻辑中封装一个"生成函数":
python
import json, uuid, requests

# ComfyUI API 地址(假设运行在本地 8188 端口)
COMFYUI_URL = "http://127.0.0.1:8188"

# 加载预先设计好的工作流 JSON(在 ComfyUI 界面中设计后导出)
with open("workflow_api.json", "r") as f:
    workflow = json.load(f)

# 动态修改 prompt 节点
workflow["6"]["inputs"]["text"] = "A cyberpunk city skyline at night, neon lights"

# 提交工作流执行
response = requests.post(
    f"{COMFYUI_URL}/prompt",
    json={"prompt": workflow, "client_id": str(uuid.uuid4())}
)

prompt_id = response.json()["prompt_id"]
print(f"Workflow submitted: {prompt_id}")
代码逻辑异常清晰:你可以在 ComfyUI 的可视化界面中反复调试节点图,一旦调试满意,导出为 API 格式的 JSON,之后所有执行都通过这个 JSON 驱动。可视化调试 + 编程化执行,这是 ComfyUI 区别于 Diffusers 的关键设计哲学。
在真实的生产场景中,这种模式带来了极高的工程自由度——一个负责生成海报的数字员工 Agent 可以用 ComfyUI API 封装 30+ 种预置风格模板,大模型只需根据用户意图选择模板并填入 prompt,剩下的都交给 ComfyUI 的工作流处理。
Automatic1111 / ForgeUI:Web 交互的经典阵营
相比之下,Automatic1111 WebUI 和 ForgeUI 代表了另一个方向:以交互操作为中心,而非以程序化调用为中心。
Automatic1111 是最早让 Stable Diffusion 走入大众视野的 Web 界面。它把 txt2img、img2img、inpainting 等功能集中在一个浏览器标签页里,适合快速实验和手工调参。但它的架构设计较为陈旧,显存利用率不高,在大规模自动化场景下不够灵活。
ForgeUI 则是 Automatic1111 的现代化接班人。 它在保留 A1111 所有功能的基础上,对推理核心做了重构,专门针对 2026 年主流的 RTX 40/50 系列 GPU 做了显存优化。如果你只需要快速体验模型效果、验证 prompt 思路、或为训练数据集做手工标注,ForgeUI 是门槛最低的起点——打开浏览器就能用,不需要写一行代码。
但需要明确指出:在 Agent 驱动的自动化场景中,WebUI 阵营不是最优选。它们的 API 能力有但不成熟,更适合作为"人工工作台"而非"机器调用后端"。
大模型架构师的选型博弈:代码 Agent 与视觉 Agent 的分流
到这里,我们可以停下来做一个总结性的选型判断。前面六个文本推理阵营加上本节的多模态工具,构成了 2026 年推理引擎的完整版图。但在实际架构中,不同类型的 Agent 应该选择不同的推理后端,不存在一套方案通吃所有场景。
如果你在开发代码 Agent(如 Coding Agent、数据分析 Agent):
将 LiteLLM 放在 Agent 和所有模型之间。代码 Agent 的核心需求是灵活切换模型(主生成用 Claude,简单任务用本地 Qwen,紧急备份切换为 Grok),LiteLLM 提供的协议统一层让你只用一套 OpenAI 格式的 chat.completions.create 就能访问所有后端。同时,LiteLLM 的负载均衡和自动故障切换是生产环境的安全网——当某个后端的 API 键配额耗尽或服务不响应时,它会自动路由到备用端点。
如果你在开发视觉 Agent(如自动生成海报、商品图、社媒配图的数字员工):
将 ComfyUI 作为你的推理后端。不要试图在代码中直接拼装 Diffusers Pipeline——前期调试成本高、显存管理差、可维护性低。正确的方式是:在 ComfyUI 的可视化界面中完成管线设计和调参 → 导出 API 格式 JSON → 在 Agent 代码中通过 HTTP 请求驱动执行。这样你获得了"可视化调试的效率 + 程序化调用的灵活性",且 ComfyUI 的显存管理可以让你在一张消费级显卡上运行复杂的多模型组合工作流。
换句话说:文本推理的复杂度在"调度"(管模型),视觉推理的复杂度在"管线"(管流程)。 理解了这个分野,你就不再会被满屏的选项淹没——你需要的不是一把万能工具,而是两张分别匹配不同问题域的选型地图。
当你把这两张地图叠在一起看,才会发现 2026 年推理引擎生态的全貌:一面是文本模型的"多引擎并联 + 路由调度";另一面是视觉模型的"工作流串联 + 管线编排"。二者的交汇处,就是你的 Agent 真正开始运转的地方。
6.5.8 大模型推理引擎选型指南:把你的约束画成决策树
前面四节,我们从工业级高并发一路走到跨平台、极致加速、特殊用途引擎,介绍了将近十个推理引擎。你可能会觉得眼花缭乱——这么多选项,我怎么知道该选哪个?
这正是架构师面对的真实困境:没有最好的引擎,只有最适合的心脏。 选型不是做排行榜,是把你的硬件约束、业务场景和团队能力像拼图一样拼在一起,找到唯一一块吻合的。本节的目标,就是帮你完成这最后一公里的拼图。
五类典型场景的决策表
我们先把最常见的五类部署场景和对应的首选引擎列清楚。这不是"最优引擎排行榜",而是"如果你符合左列条件,右边是性价比最高的起点"。
| 你的场景 | 首选引擎 | 为什么 |
|---|---|---|
| 🏢 企业通用 API 部署:团队在用 OpenAI SDK,需要稳定、兼容、社区支持好 | vLLM | PagedAttention + 连续批处理是生产环境的工业标准;OpenAI 兼容 API 零迁移成本;几乎每篇推理性能论文都以它做 baseline |
| 🤖 Agent 开发 / 多轮对话:系统提示词长、工具调用频繁、前缀复用率高 | SGLang | RadixAttention 的基数树前缀缓存在 Agent 场景下命中率 80%+;原生结构化生成保证 JSON 格式不出错;对 DeepSeek 等 MoE 模型有专项优化 |
| 💻 个人 Mac / 无 GPU 开发:在笔记本上做实验、跑本地 AI | llama.cpp | GGUF 量化让 7B 模型在 Mac 内存上流畅运行;自带 OpenAI 兼容 HTTP Server;Ollama 底层引擎就是它 |
| ⚡ 极致延迟要求:对延迟要求到毫秒级,有 H100/B200,有专业运维 | TensorRT-LLM | CUDA 级算子融合 + In-Flight Batching,引擎编译后可达 vLLM 3-5 倍吞吐;Triton Server 多模型编排 |
| 🧩 混合多模态服务:需要同时部署 LLM + Embedding + ASR + 图像生成 | Xinference | 一个框架纳管文本、语音、图像、向量化、重排序五类模型;Web 管理界面 + RESTful API,中小团队降低认知负载 |
选型决策树
如果你对上面的表还有犹豫,下面的决策树可以帮你做更细粒度的筛选。从你的硬件出发,逐层判断:
两个你容易忽略的维度
选型不只是"什么引擎最快"。在实际落地中,下面两个维度常常被遗忘,但它们决定了你的选型能不能活过第一个生产事故。
1. 运维复杂度 = 隐形成本。
vLLM 和 SGLang 都提供 OpenAI 兼容 API,你不需要让业务团队改代码;TensorRT-LLM 需要 2-6 小时编译,且 engine 绑定特定 GPU 型号——H100 编译的搬不到 A100 上。如果你的核心业务不是 AI 基础设施本身,而是医疗诊断、金融风控或法律服务,那"运维复杂度"的权重应该远高于"极限吞吐量"。选 vLLM 或 TGI,让团队少加班。
2. 生态锁定 = 长期风险。
TGI 深度绑定 HuggingFace 生态,ONNX Runtime GenAI 绑定微软,TensorRT-LLM 绑定 NVIDIA 硬件。如果你的模型来源或硬件供应商未来可能变化,选择生态中立的引擎(vLLM、SGLang、llama.cpp)能给你更多腾挪空间。架构师的选择不是在今天画一个完美的圆,而是让这个圆有足够的半径容纳未来的不确定性。
一句话总结
读完 6.5 节,你不需要记住所有引擎的参数和 benchmark——你只需要记住三点:
- 你的 GPU 什么牌子,决定了你能进哪个阵营;
- 你的业务是什么形态(API 服务 / Agent 循环 / RAG 管道 / 多模态混合),决定了哪个引擎的专项优化对你真正有用;
- 你的团队有多少人,决定了你能承受多高的运维复杂度。
把这三个问题写在白板上,逐一回答。答案指向的那个引擎,就是你现在最好的选择——不是排行榜上最好的,是你的约束下最好的。而这正是这一节导语中说的那句话的真正含义:选型这张地图很难,但画出来了,脚下的路就有了方向。
6.6 大模型知识增强
上一节我们讨论了推理引擎——如何让模型"跑得快、跑得稳"。但跑起来只是第一步:一个能工作的 AI 系统,更需要解决"知道什么"和"从哪里知道"的问题。
这就是知识增强要回答的两个核心问题:
- 如何组织知识:你的文档、数据库、API——这些散落在各处的信息,怎样才能变成模型能理解、能利用的结构化上下文?这一侧,我们称为 RAG(检索增强生成),它负责知识的"生产力"——加工、索引、召回。
- 如何访问知识:当知识已经组织好了,模型用什么方式去连接它?每换一个数据源就要重写一套代码吗?这一侧,我们称为 MCP(模型上下文协议),它负责知识的"生产关系"——标准化连接、协议映射、权限管控。
把这两个维度分开,是理解 2026 年知识增强技术栈的关键。RAG 解决"加工",MCP 解决"连接",二者各自演化又互相咬合。
本节将沿这条双线展开:先回溯 RAG 从 1.0 到 3.0 的演进路径——从朴素语义检索到基于 MCP 的分布式知识服务;再介绍 Dify、RAGFlow、FastGPT 等集成框架的实际选型;然后是 Coze、Dify Cloud 等服务平台如何让知识增强"开箱即用";最后讨论上下文管理——这套"大模型系统的动态内存"如何让信息在有限的上下文窗口中发挥最大价值。
6.6.1 RAG:大模型知识的生产端
RAG 不是一个技术,而是一条技术路线的统称。从 2023 年到现在,它经历了三次明显的形态变化:检索从"相似度匹配"变成"意图驱动",再变成"协议化的分布式服务"。理解这条演进线,比记住任何一个具体工具都重要——因为工具会换,问题不会。
6.6.1.1 RAG 1.0:基于语义相似度的朴素检索
在 2023-2024 年的大模型拓荒期,RAG 1.0 用一个朴素但有效的配方解决了大模型最尴尬的问题——"我不知道那件事"。这个配方可以概括为三个词:切片、向量化、填充。把知识文档切成小块,用 Embedding 模型转成向量存入数据库,收到用户问题时以同样的方式向量化问题,检索最相似的片段,把它们塞进 Prompt,让模型基于这些外部知识生成答案。
RAG 1.0 验证了一个核心真理:外部搜索比内部记忆更可靠。 模型 的参数量再大,训练截止日期之后的知识、企业内部的私有文档、实时变化的数据——这些东西它"记"不住。与其让模型死记硬背,不如给它一个"查资料"的能力。这个思路本身没有错,至今仍是所有高阶 RAG 系统的起点。
但它也暴露了四个结构性的局限。
局限一:语义孤岛。 RAG 1.0 检索的逻辑是"找相似的字",不是"找能回答问题的信息"。当你搜索"乔布斯的公司"时,向量模型可能会因为语义相似度把"苹果果园种植基地"排在前面——这两个"苹果"在向量空间里确实很近,但它们不是一回事。RAG 1.0 没有能力区分"同词不同义",也不理解"乔布斯"和"公司"之间是一段"创始人—所属实体"的逻辑关系。它在向量空间里找邻居,但知识图谱里的邻居和向量空间里的邻居是两套坐标系。
局限二:上下文断裂。 为了让检索系统能工作,原始文档必须被切分成一个个小块(Chunk)。这个切分是刚性的、无感知的——它不知道哪里是一个论证的起点和终点,也不知道表格的表头和表身不应分家。你切出来的可能是半句话、半张表、或者一个脱离了"因为"只剩"所以"的结论。模型拿到的是一堆碎片,它需要自己拼图。对于"对比方案A和方案B的优劣"这种需要跨片段综合的问题,碎片式的输入意味着模型连完整的 A 方案和 B 方案都没看到,谈何对比?
局限三:意图迷失。 用户问"为什么我的模型训练到第3轮就崩了?",RAG 1.0 把这句话向量化之后,开始找和它相似的文档片段。但用户真正需要的不是"训练崩溃"相关的文章,而是一个能诊断他具体错误的排查步骤。朴素检索没有"意图理解"这一步——它不区分"我在寻求解释"和"我在求助排查",也不考虑提问者的技术水平。一模一样的检索词,给初学者和给资深工程师,它返回的是同一批结果。
局限四:组件臃肿。 即便是一个最小化的 RAG 1.0 系统,你也要维护至少五类组件:文档解析器、向量数据库、Embedding 服务、重排模型、编排框架。早期的 LangChain 试图用一个框架把这些都包起来,但它走向了另一个极端——过度抽象。为了"支持一切",它的内部封装层叠床架屋,一行调用背后藏着几十层代理。调试时你根本不知道是哪一个组件出了问题,排查路径像走迷宫。
正是因为这些局限,RAG 1.0 在今天已经被视为一个"已过时的整体架构"。但任何过时的架构都会留下遗产——RAG 1.0 在数据解析、向量化、语义转换和精排四个环节沉淀下来的工具,至今仍是不可替代的零件。以下是五个你在 2026 年仍然要了解的技术组件。
① 数据解析:PyMuPDF4LLM
- 资源:github.com/pymupdf/pymupdf4llm,
pip install "pymupdf4llm<2"(2.0 是空壳包,装 1.x)。 - 功能:将 PDF 转换为 LLM 友好的 Markdown 格式,保留表格结构并标注图片锚点。与通用 PDF 解析库不同,它是专为大模型上下文设计的——输出的不是"看起来像文本"的字符串,而是结构化的、可以直接喂给模型的 Markdown。
- 状态:RAG 1.0 时代的技术遗产中少数至今仍处统治地位的工具。不是因为 PDF 解析没有进步,而是因为它把"高保真"这件事做到了一个临界点——再进一步的工具(如 RAGFlow 的深度学习解析)需要 GPU 和更大的投入,而 PyMuPDF4LLM 用纯 CPU 就能做到 90 分的水平。
- 最佳实践:处理含复杂表格的 PDF 时,使用
to_markdown()模式而非to_text()。Markdown 的表格语法是当前大模型理解结构化数据最友好的格式。 - 避坑:它处理的是原生 PDF 的文本和结构,不是图片里的字。如果你面对的是一堆扫描件(图片 PDF),PyMuPDF4LLM 帮不了你——你需要先上 OCR 流程。
② 向量数据库:Milvus
- 资源:milvus.io,推荐 Docker Compose 一键部署。
- 功能:专为亿级向量检索设计的分布式数据库。支持 HNSW、IVF 等多种近似最近邻索引,通过分区(Partition)机制支持向量与标量的混合过滤,具备天然的水平扩展能力。在你需要处理千万级以上的文档量时,它和 Faiss 这类轻量库的差距会迅速拉大。
- 状态:中大型企业 RAG 系统的实际标配,仍在快速迭代中。社区活跃,与 LangChain、LlamaIndex 等主流框架的集成最成熟。
- 最佳实践:按业务维度(如日期、部门)建立 Partition,而非将所有向量堆在一个集合里。100 万向量全量扫描和 10 个 Partition 分区检索,延迟可能是 10 倍的差距。
- 避坑:Milvus 的 HNSW 索引构建极其消耗内存。在 2026 年,如果你的生产环境内存低于 32GB,不要尝试构建全量 HNSW 索引——使用 IVF 索引或增加 Partition 数量来分散内存压力。
③ 语义转换:BGE-M3
- 资源:huggingface.co/BAAI/bge-m3,通过
Sentence-Transformers库加载。 - 功能:BGE-M3 的上一个"3"代表它同时具备三种能力——多语言(Multi-lingual)、多粒度(Multi-granularity)、多功能(Multi-function)。它不仅产出稠密向量(Dense),还能同时输出稀疏向量(Sparse),原生支持混合检索。对中文专业文档的语义理解,实测优于同尺寸的 OpenAI
text-embedding-3-small,且支持完全本地部署。 - 状态:2026 年国产 Embedding 开源方案中最稳的选择。BGE 系列已形成完整生态(BGE-M3 做 Embedding,BGE-Reranker 做精排),成为国内 RAG 系统的默认搭配。
- 最佳实践:在同一套系统里,用 BGE-M3 的稠密向量做初筛(快),用稀疏向量做关键词补充(准),避免因专业术语导致纯稠密检索的漏召。
- 避坑:Embedding 向量维度必须与向量数据库的集合定义一致。BGE-M3 默认输出 1024 维,而 OpenAI
text-embedding-3-small默认 1536 维——如果你在一个生产系统里混用模型,先统一维度配置,否则会直接报向量维度不匹配的底层错误。
④ 精排:BGE-Reranker
- 资源:huggingface.co/BAAI/bge-reranker-v2-m3。
- 功能:RAG 1.0 时代最重要的工程发现之一:向量检索处理"广度",精排模型处理"精度"。BGE-Reranker 对向量检索返回的 Top-N 候选片段做逐对语义比对,输出一个相关性分数并以此重新排序。它不是简单地比较向量夹角,而是用一个小型交叉编码器模型完整阅读"问题+候选文档"对,判断这一对是否真的在回答同一个问题。
- 状态:防止大模型"胡说八道"的第一道防线。2026 年的共识是:没有 Reranker 的 RAG 系统是不可靠的。向量检索的 Recall 可以达到 90% 以上,但 Top-5 的 Precision 往往只有 50%~60%——Reranker 就是把那 50% 拉到 90% 的关键环节。
- 最佳实践:二阶段检索架构——第一轮向量检索召回 100 条(追求高召回,不追求精度),第二轮 Reranker 精选前 5 条(追求高精度)。这个 100→5 的漏斗是 2026 年 RAG 的高性价比黄金配比。
- 避坑:Reranker 的计算量远大于 Embedding。100 条候选做精排可以控制在 200ms 以内,超过 200 条则延迟会成倍增长。如果你的场景需要更大的召回池,考虑分批次精排或引入更轻量的评分模型做预筛。
⑤ 编排框架:Early LangChain(已过时)
- 功能:LangChain 的历史价值在于它首创了"Chain"的概念——将模型调用、Prompt、工具访问串成一个可配置的管道。在 2023 年,这套抽象让很多人第一次看到了"大模型应用"的完整形态。
- 状态:已过时(Legacy)。不是 LangChain 做错了什么,而是它的抽象层过于厚重。为了实现"适配一切",它的内部封装多达十几层,一个简单的检索调用背后是
Retriever → RetrieverTool → AgentExecutor → Chain的套娃。调试时 Trace 栈深到让人绝望。 - 最佳实践:在 2026 年,用 LiteLLM 替代 LangChain 的模型调用层,用直接的 API 调用替代 LangChain 的工具链。不要试图在 LangChain 的旧框架上搭建新的生产系统。
- 避坑:如果你接手了一个用 LangChain 构建的遗留 RAG 系统,不要尝试重构 LangChain 内部的逻辑——直接在它的外层包一层 LiteLLM Router,把模型调用逐步迁移出去。渐进式替换比推倒重来更可控。
RAG 1.0 的墓碑上应该刻这样一行字:它让大模型学会了"查资料",但从未学会"理解问题"。 下一节我们将看到 RAG 2.0 如何通过意图识别和混合检索,把一个盲目的搬运工升级为一个知道"该找什么"的调度总监。
6.6.1.2 RAG 2.0:以大模型为决策中枢的意图驱动检索
上一节列了 RAG 1.0 的四个局限。其中三个——语义孤岛、上下文断裂、组件臃肿——病在管道内部;只有第四个「意图迷失」病在管道的入口:问题在进入检索之前,就已经被简化成了一段字符串。
RAG 2.0 的全部工作都落在这个入口上:把"理解问题"这道关交给大模型自己。 由此引出的三个动作,各自对应一处具体的失灵。
失灵一:意图不只决定"搜什么",还决定"用什么词去搜"。
上一节的局限三讲过,朴素检索不区分"我在寻求解释"和"我在求助排查"。落到检索链路上,这个缺陷有一个更直接的后果:用户的原话往往不是好的检索词。 你在客服机器人里输入"我上个月买的东西还没到,怎么办",RAG 1.0 把这句话整体向量化,找回来的是"如何处理物流延迟投诉"——听起来对,但你要的其实是"未发货订单的退款流程"。用户说的是现象,答案在流程里,两者字面上毫不相似。
失灵二:编号与术语在向量空间里没有位置。
向量检索擅长语义相近,不擅长精确匹配。你搜"GB/T 28181",它可能返回一堆"视频监控国标"的科普段落,却漏掉那份只写了一次编号的配置手册——因为在语义空间里,一串编号携带的信息太少。反过来,关键词检索(BM25)对编号一抓一个准,遇到"我上个月买的东西"这种口语则完全无能。两种检索各有盲区,而 RAG 1.0 只装了其中一种。
失灵三:搜错了没有第二次机会。
RAG 1.0 是一次性管道:检索 → 拼上下文 → 生成。如果第一步召回的文档里没有答案,模型只能硬答,或者承认不知道。它不具备"这条路不通、换一条"的能力。
RAG 2.0 就是针对这三处失灵的三次手术,而执刀的,都是大模型自己。
第一次手术:让模型先想清楚再搜(Query Rewriting 与 HyDE)
最直接的一刀,是在检索之前加一个改写环节:把用户的原始问题交给大模型,让它输出一个更适合检索的查询。
"我上个月买的东西还没到,怎么办"经过改写,变成两条并行查询:
未发货订单 退款流程
物流延迟 客服处理规范原来一句话检索变成了两条意图明确的查询。这一步实现很轻——一次额外的模型调用,外加一段提示词;但改得好不好是另一回事,它依赖提示词设计、领域词表和一批真实问题的评估集。不做评估就把口语问题批量改写,很可能把一条本来还行的查询改得更差。
更激进的做法叫 HyDE(Hypothetical Document Embeddings,假设性文档嵌入)[2]。它的思路反直觉:与其用"问题"去找"答案",不如先让模型编一个假答案,再用这个假答案去找真答案。
为什么有效?因为问题和答案在向量空间里往往不在同一个邻域。问句是疑问语气、简短、缺主语;文档是陈述语气、完整、术语密集。用问句的向量去找文档的向量,本身就有结构性偏差。 而一个假答案,即使内容全是编的,它的语气、句式、术语密度已经和真文档对齐了——它落在正确的邻域里,只是坐标略有偏差。用这个坐标去搜,命中率明显提升。
python
# HyDE 的核心就三步,不需要任何向量库特有 API
def hyde_retrieve(question, llm, vector_store, k=5):
    # 1. 让模型编一段"看起来像答案"的文本
    draft = llm.invoke(
        f"请写一段包含技术细节的回答草稿,用于检索。问题:{question}"
    )
    # 2. 用草稿(而不是问题)去检索
    hits = vector_store.similarity_search(draft, k=k)
return hits坑:HyDE 在简单事实上会帮倒忙。"今天天气怎么样"这种问题,模型编出来的草稿反而引入噪声——它可能编出一个具体的城市和温度,把你带偏。判据是问题是否需要背景知识:需要的用 HyDE,不需要的别用。工程上常见的做法是加一个路由层,先判断问题类型,再决定走不走 HyDE。
第二次手术:两套检索并行,但先得解决"分数不可比"(Hybrid Search)
这件事在 RAG 1.0 里其实已经出现过一次:上一节的 BGE-M3 最佳实践就是"稠密向量做初筛、稀疏向量补关键词"。但那是一个模型顺带吐出的两种向量——能力属于 Embedding 模型,你不需要做任何架构决策。
RAG 2.0 把这件事拆开了:两套独立索引、两套独立召回、两个各自为政的分数。一旦拆开,第一个问题立刻出现——BM25 的分数可能是三十几分,余弦相似度是 0.72,这两个数字没有任何可比性,加起来毫无意义。所以"两套并行"真正的技术难点不是并行,是融合。
融合算法通常用 RRF(Reciprocal Rank Fusion,倒数排名融合)[17]:不看绝对分数,只看排名。每个文档的得分等于它在各套结果中排名的倒数和:
python
def rrf_fuse(rank_lists, k=60):
    """rank_lists: [[doc_id, ...], [doc_id, ...]],每套检索一个有序列表"""
    scores = {}
    for ranks in rank_lists:
        for i, doc_id in enumerate(ranks):
            scores[doc_id] = scores.get(doc_id, 0) + 1.0 / (k + i + 1)
    return sorted(scores.items(), key=lambda x: -x[1])
k=60 是原论文的经验值,作用是压平头部差距、避免某一路的绝对优势压死另一路。这个函数只有五行,但今天主流的检索栈——LangChain、LlamaIndex、Elasticsearch、Vespa——都内置了它。
接上第一步的改写,整条链路变成:改写 → 向量检索 + 关键词检索 → RRF 融合 → 重排序(Reranking,业内亦称精排)→ 拼上下文。
这里要单独说明一点:重排序不是 RAG 2.0 的发明。 上一节讲的 BGE-Reranker 在 1.0 时代就已经是标配零件。2.0 改变的不是这项能力,而是它的地位——从"有就用"的可选优化,变成流水线上的固定环节。在 2.0 的链路里,没有精排就不该上线。
第三次手术:让检索变成一个循环(Agentic RAG)
前两次手术解决"搜得准",第三次解决"搜不到怎么办"。
Agentic RAG 的核心转变是:检索不再是一个固定步骤,而是模型可以反复调用的工具。模型拿到第一轮结果后,自己判断够不够——不够就换个关键词再查,或者顺着已知实体做第二跳。
一个典型的多跳场景:"我们公司去年采购的那批 GPU 服务器,保修期到什么时候?"
第一轮检索能找到"2025 年 Q3 采购 GPU 服务器 20 台",但合同号不在这段文本里。模型需要:
- 从第一轮结果里提取合同编号;
- 用合同编号发起第二轮检索;
- 从合同条款里读出保修期限。
RAG 1.0 在这里必然失败——它的管道只有一次机会。而 Agentic RAG 把这当成一次正常的推理过程。
这里必须划一条边界:这一轮循环的每一步,仍然发生在你自己的一套索引里。多跳是"在同一批文档里换几次问法",不是"跨系统换知识源"。能不能跨源是另一件事——那正是 RAG 3.0 要动的那堵墙。
围绕这个循环,被引用最多的两个改进方向是 Self-RAG [3] 和 Corrective RAG [4]:
- Self-RAG 让模型在生成过程中自己判断三件事:该不该检索、检索到的东西有没有用、我的输出有没有被检索结果支撑。要注意它不是加一段提示词就能复现的——它依赖一组专门训练过的反思标记(reflection token),是需要改造模型的方案。
- Corrective RAG(CRAG) 在检索之后放一个轻量判别器,给召回结果打三档:正确的,先做一次知识精炼(把段落拆成句子、滤掉无关句、再重新组合)再送去生成;错误的,直接丢弃,改走网络或外部检索;模糊的,把内部精炼结果与外部检索结果并用,一起拼进上下文。它的核心不是"重检",而是先判断这批检索结果值不值得信,再决定用内部、用外部、还是两者合用。
代价很实在:每一次循环都是一次完整的模型调用。 一个需要三跳的问题,Token 消耗是单跳的数倍,首字延迟也从百毫秒级进入秒级。
GraphRAG:当答案不是一段文字,而是一张网
还有一类问题,任何向量检索都答不好:"我们这几个供应商之间有没有共同的二级分包商?"
答案不在任何一段文档里,它存在于文档之间的关系中。这类问题需要的是图,不是片段。
GraphRAG(微软研究院 2024 年上半年开源)[5] 的做法是:先用大模型从全部文档里抽取实体和关系,建成知识图谱;再对图做社区检测(Leiden 算法),为每个社区生成摘要;查询时先定位相关社区,再沿着边做多跳遍历。
它在"全局性提问"上优势明显——比如"这批文档的主要风险主题有哪些",向量检索根本无从下手,而图谱可以按社区摘要汇总。
代价同样明显:建图成本极高。这个成本的量级不是"多跑一次索引",而是接近一次重训练级别的工程投入:全部文档要过一遍模型抽取,每次文档更新都要增量重跑,而且抽取质量本身要靠人工兜底——大模型抽出来的关系有相当比例是错的或冗余的,人工校验的工作量常常超过收益。
经验上,只有当你的问题里有相当比例(比如说三成以上)属于"关系型 / 全局型"时,GraphRAG 才值得上。如果绝大多数问题仍是"这个参数怎么配",用 GraphRAG 是拿推土机拧螺丝。
代价清单:什么时候不该上 RAG 2.0
这些能力没有一个是免费的——每一项都在钱、延迟或复杂度上标了价。上线前先算三笔账:
| 升级项 | 换来什么 | 付出什么 | 什么情况下不值得 |
|---|---|---|---|
| Query 改写 | 口语问题的召回明显改善,术语密集的库上尤其明显 | 一次模型调用 | 用户查询本身就是精确术语(日志检索、代码搜索) |
| HyDE | 跨语气的检索命中改善 | 一次生成调用 | 事实型短问句为主、知识库领域窄 |
| Hybrid Search | 编号与术语不再漏召 | 维护两套索引 + 一个融合层 | 知识库只有几十篇文档 |
| 精排常态化 | 把高召回兑现成高精度 | 一次专用模型推理 | 召回结果本来就只有三到五条 |
| Agentic 循环 | 需要多步推理的问题变得可解 | Token 与延迟成倍上涨 | 绝大多数请求是单跳事实问答 |
| GraphRAG | 关系型、全局型问题第一次变得可答 | 建图 + 持续维护 + 人工校验 | 单跳事实问答占绝大多数 |
一个务实的做法:先把 RAG 1.0 跑到能用,再逐项加。 每加一项,用同一批真实问题测一次;召回率和端到端正确率没有明显提升,就回滚。RAG 2.0 不是一套必须全套部署的架构,它是六个可以独立开关的旋钮。
把"理解"做到极致之后,剩下的还是那堵墙
到这里,RAG 2.0 把"问题怎样被翻译成一次查询"这件事,几乎做到了极致:会改写、会混合检索、会多跳、会自我纠错。
但要说清楚一件事:上一节的局限二(上下文断裂)本节并没有解决。 改写、双索引、多跳都不改变切块的边界,半句话还是半句话,半张表还是半张表。那要靠文档解析与切块策略,属于工程层,不是检索算法层——下一节的框架会再撞上它。
而比这更硬的,是另一堵墙:所有知识都必须先被搬进你自己的检索系统里。 改写、双索引、多跳,动的全是"进来之后怎么找";"怎么进来"这一步,本节一个字都没碰。这堵墙不在算法侧,在协议侧——留给下一节。
[1] Cormack, G. V., Clarke, C. L. A., Buettcher, S. "Reciprocal Rank Fusion Outperforms Condorcet and Individual Rank Learning Methods." SIGIR 2009. [2] Gao, L. et al. "Precise Zero-Shot Dense Retrieval without Relevance Labels." (HyDE) arXiv:2212.10496, 2022. [3] Asai, A. et al. "Self-RAG: Learning to Retrieve, Generate and Critique through Self-Reflection." ICLR 2024. [4] Yan, S.-Q. et al. "Corrective Retrieval Augmented Generation." arXiv:2401.15884, 2024. [5] Edge, D. et al. "From Local to Global: A Graph RAG Approach to Query-Focused Summarization." Microsoft Research, 2024. 开源实现:https://github.com/microsoft/graphrag
6.6.1.3 RAG 3.0:基于 MCP 的分布式知识服务
上一节我们讨论了 RAG 2.0——它让检索从"盲目搬运"进化为"意图驱动的调度"。大模型不再是检索结果的被动消费者,而是整个检索链路的决策中枢。但 RAG 2.0 有一堵看不见的墙:不管内部逻辑多么精巧,所有知识都必须预先"灌"进你自己的系统。 你的向量库、你的知识图谱、你的重排流水线——这一切都是自建自管的。当一个用户的提问涉及 Jira 里的 Bug 历史、GitHub 上的代码更新和 Confluence 里的设计文档时,你能做的不过是把这些来源分别导出一份快照,塞进同一个向量库。
问题是:知识不在原地,你就永远在追赶它的版本。
RAG 3.0 的核心理念是把"查资料"变成"调服务"。 它不要求你预先搬运知识,而是通过 MCP(Model Context Protocol) 为每一个知识源建立一个标准化的访问接口。Jira、GitHub、SQL 数据库、实时网页——它们在模型眼中不再是被切碎后塞进向量库的二次制品,而是独立的、活的、可查询的知识服务节点。这一转变带来的不是修修补补的改进,而是知识架构范式的根本迁移。
从 2026 年上半年的落地实践来看,RAG 3.0 已经形成了三个区别于前代的明确特征。
特征一:知识即服务(Knowledge as a Service, KaaS)
在 RAG 1.0 和 2.0 的世界里,知识是被"搬运"的——你要么把 PDF 转成 Markdown 放进向量库,要么自建知识图谱(像 GraphRAG 那样用模型抽取实体和关系)。知识源变了,这套搬运流水线就要重新跑一遍。RAG 3.0 的策略是反过来的:让知识留在原地,给模型一个标准化的"读"接口。
这个接口就是 MCP Server。每个知识源——一套 Jira 实例、一个 GitHub 仓库、一个 SQL 数据库——都通过一个轻量的 MCP Server 对外暴露。每个 Server 通过 MCP 协议提供三类能力:Resources(静态文档和知识条目的读取接口)、Tools(让模型执行特定操作,如执行 SQL 查询、搜索 GitHub Issues)、Prompts(预定义的交互模板,引导模型如何有效地"问"这个知识源)。
关键设计在于:模型不关心知识源的后端是什么。 它只知道自己调了一个叫 jira-server 的 MCP 节点,传入了查询参数,收到了一段 Markdown 格式的结构化结果。这背后是 REST 调用还是 gRPC 流、数据库是 PostgreSQL 还是 MongoDB——对模型来说完全透明。这个抽象层带来的工程收益是巨大的:你不需要为"接入新数据源"每次都重写一套 ETL 流水线和向量化脚本,只需要为它编写一个 MCP Server 的描述文件。
特征二:联邦检索(Federated Retrieval)
当知识源都变成了独立的 MCP Server,一次查询就不再是"在向量库里翻东西",而是向多个服务节点同时发起请求,在上下文窗口中动态合并结果。
这个过程不是简单的多源并发,而是一个有推理参与的多轮编排。以"这个 Bug 修复是否影响了 API 兼容性?"为例:
- Agent 首先将请求路由到 Jira MCP Server,查到相关 Bug 的描述和修复日志。
- 拿到 Bug ID 后,Agent 向 GitHub MCP Server 请求该 Bug 对应的 PR diff。
- 从 diff 中提取到变动的 API 端点列表后,Agent 向 SQL MCP Server 查询最近一周这些端点的调用日志,对比修复前后的错误率变化。
这三步不是并行的(后两步依赖第一步的结果),也不是一次性检索(三步之间有逻辑推理)。RAG 2.0 的意图识别与单库内的多跳,已经能让模型判断"该去找什么"、并在同一批文档里换几次问法;但它的每一步都还在自己那套索引里。RAG 3.0 的联邦检索更进一步——它利用 MCP 的标准化接口,让模型在检索间隙进行推理,根据中间结果动态调整下一步的检索方向。
MCP 2026-07-28 版本引入的无状态协议设计进一步强化了这种模式 [17]。旧版 MCP 需要客户端和服务器之间维持一个长连接会话(Session),每次请求必须路由到同一个服务器实例——这在多节点联邦检索场景下是一个明显的瓶颈。新版取消了握手协议和 Session ID,任意请求可以命中任意服务器实例,故障转移从"需要感知"变成了"天然发生"。对联邦检索来说,这意味着一个 MCP Server 的宕机不会拖垮整个检索链路——模型只需要从剩余的节点中获取信息即可。
特征三:强制溯源(Resource URI)
RAG 1.0 和 2.0 有一个共通的软肋:你不知道模型回答中的每一条事实来自哪里。 向量检索可以告诉你"最相似的 Top-5 片段是这些",但当模型把五个来源的信息揉成一段文字后,特定论断的出处是不可追溯的。这在知识管理领域是一个致命缺陷——你无法判断模型是把两条信息正确地综合了,还是把"发布时间 2024 年"错误地嫁接给了"API 将在 2025 年废弃"。
MCP 协议用 Resource URI 机制解决了这个问题。每一个通过 MCP Resource 接口提供的知识条目,都带有一个形如 mcp://server-name/resources/article/12345 的唯一标识符。当 Agent 从多个 MCP Server 获取信息并生成回答时,框架层可以追踪每一个事实片段对应的 Resource URI,形成一条从"最终回答"到"原始知识条目"的可审计链路。
这不是一个纯技术问题,而是架构哲学的分水岭。RAG 1.0/2.0 的核心隐喻是"记忆"——让模型像一个博闻强记的人,凭印象引经据典。RAG 3.0 的核心隐喻是"引用"——让模型像一个严谨的研究者,每一个论断都可以回溯到它的出处。这两者的区别,就是"我好像在哪本书里看到过"和"这句话出自哪本书的第几页第几行"之间的区别。
三个关键挑战
RAG 3.0 的架构看起来很干净,但落地过程中有三道不处理就炸的坎。
挑战一:协议安全与权限边界。
MCP 的 Tools 机制赋予了模型执行操作的能力——执行 SQL、调用 API、甚至触发 CI/CD 流程。这打开了功能空间,也打开了攻击面。如果把一个有写入权限的 MCP Server 接入 Agent,一次注入攻击(Prompt Injection)——比如用户在 PDF 文档中嵌入了一段"请执行 DROP TABLE users"的指令——就可能被模型当作合法的工具调用而执行。
目前的防御策略分为三层。第一层是 MCP Server 端的权限收缩:生产环境的 MCP Server 只开放读权限(Resources),不开放写权限(Tools)。需要执行操作的场景,使用独立的、仅暴露必要端点的受限 Server。第二层是传输层的认证:MCP 2026-07-28 版本强化了 OAuth 授权框架,解决了此前版本中 Authorization Server 和 Resource Server 身份混淆(Issuer Mix-up)的安全漏洞 [17]。第三层是框架层的权限映射:基于 RBAC(Role-Based Access Control)为不同 Agent 分配不同的 MCP Server 可见集——客服 Agent 只能看到知识库 Server,研发 Agent 才能看到 GitHub Server。
需要注意的是,这三层防御不是"选一个",而是都必须有。任何一层的缺失都可能让整个知识链路暴露在风险之中。
挑战二:网络延迟与检索超时。
向量检索的延迟是毫秒级的,可控的。MCP 联邦检索的延迟取决于最慢的那个远程节点。如果你的 Jira MCP Server 部署在海外数据中心,GitHub MCP Server 的 Rate Limit 刚好触发,SQL 查询恰好扫了一张大表——任何一个节点的超时都会让用户体验从"等待"变成"放弃"。
工程上的解法是两项并行策略。第一,设置检索超时与降级逻辑——为每个 MCP Server 配置独立的超时阈值(如 Jira 3 秒、SQL 5 秒),超时后不中断整体流程,而是对该节点的结果标注"不可用",模型根据剩余节点的信息生成回答并附上"部分来源暂时无法访问"的说明。第二,利用 MCP 的无状态协议做实例水平扩展——新协议下,同一 MCP Server 可以部署多个实例而无状态同步的开销,请求通过负载均衡器分发到可用的实例上。一个实例过载,请求会自动落到另一个实例。
挑战三:一致性悖论。
联邦检索最棘手的问题不是"找不到信息",而是"找到了矛盾的信息"。当 SQL 数据库告诉你"库存余量为 520",而最新的一封邮件里写"库存已告罄"——模型应该相信哪一个?RAG 1.0/2.0 没有这个问题,因为它们只有一个检索源。RAG 3.0 的多源特征把这个矛盾从"理论上可能"变成了"日常会发生"。
目前没有理想的通用解法,但有三个工程方向在并行探索:① 时间戳仲裁——优先相信更新时间更近的来源;② 来源置信度加权——结构化数据库(SQL)的可信度高于非结构化文档(Wiki),系统在检索时对来源标注置信度等级,模型在综合判断时显式告知用户信息冲突的存在;③ 显式降级展示——当两个来源冲突且无法自动仲裁时,不强行二选一,而是把两边的信息并列呈现给用户,标注各自的来源和时间。第三种方式虽然"不够智能",但在 2026 年的工程实践中恰恰是最稳健的选择——它承认了 AI 判断的局限性,把最终决策权还给人类。
RAG 3.0 技术五件套
以下是从当前生态中筛选出的五个在 RAG 3.0 架构中发挥核心作用的技术组件,按协议层→工具层→增强层的顺序展开。
① MCP 协议(Anthropic)——分布式知识的统一总线
- 资源:modelcontextprotocol.io,Python SDK:
pip install mcp。 - 功能:定义了大模型与外部知识/工具交互的标准协议。核心抽象是三要素——Resources(知识条目的唯一寻址接口)、Tools(模型可调用的操作接口)、Prompts(预定义的交互模板)。协议底层基于 JSON-RPC 2.0,所有交互都是请求-响应模式,不依赖长连接。
- 状态:2026 年大模型生态的绝对核心协议。Anthropic 于 2025 年 3 月发布初版后,OpenAI、Google DeepMind、Microsoft 相继宣布支持。2026 年 7 月的无状态版本(2026-07-28)标志着协议从"可用"迈向"可运维" [17]。
- 最佳实践:善用 Resource-Centric 设计思路。不经常变动的文档(操作手册、设计规范)通过
Resources暴露,提供静态 URI;需要实时计算的数据(库存、日志统计)通过Tools暴露,保留计算灵活性。对于知识密集型场景,Resources 比重应当大于 Tools——因为 Resources 天然支持溯源,而 Tools 的返回值是可变的,溯源需要额外的日志层。 - 避坑:严禁给生产环境的 MCP Server 分配写入/删除权限。把"只读知识服务"和"可写操作服务"分离为两个独立的 Server,是当前业界共识的最低保安基线。如果确实需要模型执行写操作(如自动创建 Jira Ticket),使用独立的受限 Server 并通过 OAuth 的 Scope 机制限定权限范围。
② MCP Inspector / MCP SDK——开发调试工具链
- 资源:MCP Python SDK,MCP Inspector 内置在 SDK 中。
- 功能:MCP Inspector 是开发阶段的调试面板,让你在不启动完整 Agent 的情况下手动测试 MCP Server 的接口输出。SDK 提供了 Python/TypeScript 两种语言的 Server 开发脚手架,内置 JSON-RPC 消息处理、Transport 适配(Stdio/SSE/HTTP)和 Resources/Tools/Prompts 的类型化注册接口。
- 状态:开发调试 MCP 环境的必备工具。Inspector 与 SDK 迭代同步,SDK 已支持 2026-07-28 的无状态模式。
- 最佳实践:在将 MCP Server 接入生产 Agent 之前,用 Inspector 手动测试每一个 Resources 和 Tools 端点的输出格式。特别是验证返回结果的 Markdown 结构:表格对齐、空值处理、字符编码——这些表面细节会直接影响模型的解析准确率。一次预检的 10 分钟,可能省去上线后几天排查"回答不准"的时间。
- 避坑:不同 MCP Server 应在独立的 Docker 容器或虚拟环境中运行,避免依赖冲突。一个 Server 更新了其依赖库版本(如 Python 的
requests或pydantic),不应影响其他 Server 的运行。容器化隔离是保持知识链路整体稳定性的最低成本方案。
③ Firecrawl / Jina Reader——实时网页的知识管道
- 资源:Firecrawl,Jina Reader。
- 功能:将网页内容转化为结构化的 Markdown。在 RAG 3.0 架构中,这两个工具通常以 MCP Server 的形式运行——Agent 传入一个 URL,Server 返回清洗后的页面正文。Firecrawl 更侧重批量抓取和深度爬取,Jina Reader 以"极简单页读取"为卖点,输入一个 URL 直接拿到 Markdown,不需要 API Key 即可试用。
- 状态:RAG 3.0 实现"即时学习"能力的核心管道。不同于传统 RAG 需要预先爬取网页并入库,Firecrawl/Jina 作为 MCP Resource 提供的是"查询时抓取"——模型判断需要的最新信息还未入库,实时去源头抓。
- 最佳实践:配置
scrape_options过滤导航栏、广告、页脚等噪音区域,只保留主体内容。噪音内容不仅浪费 Token,更会在检索结果中制造语义干扰——模型的注意力被无关文本稀释。同时设置合理的缓存策略:对于频繁访问的页面,缓存清洗后的 Markdown 结果(TTL 按页面更新频率设置),避免重复抓取和 IP 被封。 - 避坑:生产环境中频繁爬取同一域名会触发反爬虫机制导致 IP 被封。务必要时用代理池(Proxy Pool)做请求分发,并在请求间设置合理的冷却间隔(Crawl Delay)。对于敏感的法律或金融类网站,建议使用其官方 API 而非页面抓取。
④ Mem0——Agent 的智能记忆层
- 资源:mem0.ai,GitHub: mem0ai/mem0,
pip install mem0ai。 - 功能:Mem0 解决的是传统 RAG 完全忽视的一个维度——用户意图的历史。传统 RAG 检索的是"文档说了什么",Mem0 记录的是"用户关心什么"。它自动从对话中提取用户的偏好、过去的决策、重复出现的关注点,将其抽象为结构化的"记忆条目",并在未来的查询中作为 Context 注入 Prompt [2]。
- 状态:2026 年 Agent 长期记忆领域的标杆方案。Mem0 已从早期的"对话摘要器"演进为具备语义搜索、增量更新、用户级隔离的完整记忆基础设施。其 V3 版本引入了图记忆(Graph Memory)——在向量检索之外,通过实体链接捕捉记忆之间的逻辑关联。
- 最佳实践:在每次有意义的对话结束后触发一次
add()操作,让 Mem0 自动从对话中提取可复用的知识点。不要手动编写记忆条目——Mem0 的内置提取模型比人工总结更擅长过滤掉闲聊噪音、保留有长期价值的决策和偏好。对于多用户场景,利用 Mem0 的user_id机制做严格的用户级记忆隔离——A 用户的偏好不应泄露到 B 用户的对话中。 - 避坑:记忆污染(Memory Poisoning)是 Mem0 的最大风险 [3]。如果用户在对话中故意或无意地提供了错误信息(如"我的账号余额是 100 万"),这项错误信息可能被 Mem0 作为"用户偏好"存入记忆层,并在后续对话中被反复引用。防御策略包括:对记忆添加"置信度"标记(用户明确声明的信息 vs. 从上下文推断的信息),定期清理低置信度的记忆条目,以及提供"忘记我"的用户端控制接口。
⑤ LiteLLM MCP Proxy——多源检索的统一适配层
- 资源:litellm.ai,
pip install litellm。 - 功能:LiteLLM 的核心价值在于"把一切都翻译成 OpenAI API 格式"。在 RAG 3.0 场景中,LiteLLM 承担的角色更进一步:作为 MCP 多 Server 的前端代理,将多个 MCP 节点的输出统一映射为单个 OpenAI 兼容的上下文流。对于从 RAG 2.0 迁移过来的系统(原有的调用逻辑已经假设后端是 OpenAI API),LiteLLM 让 MCP 的引入对调用方透明。
- 状态:解决 RAG 2.0 遗留系统向 3.0 迁移的过渡神器。LiteLLM 的 Router 子模块原生支持基于查询内容的路由——根据 Prompt 中是否包含"Jira"或"GitHub"等关键词,自动将请求分发到对应的 MCP Server。
- 最佳实践:利用 LiteLLM Router 做检索分类分发,而非在业务代码里写 if-else 路由。Router 的配置是一份声明式的 YAML,新增数据源时只需添加一条路由规则,不需要修改业务逻辑。同时利用 LiteLLM 的内置重试和超时机制做联邦检索的容错:某个 MCP Server 响应超时,Router 自动 Fallback 到次级数据源或返回"部分来源不可用"的标记。
- 避坑:LiteLLM 的 MCP Proxy 模式引入了一层额外的网络跳转,在高 QPS 下可能成为瓶颈。建议在 LiteLLM 和 MCP Server 之间使用本地网络(同集群或同 VPC)部署,将额外的网络延迟控制在 10ms 以内。
从 RAG 到知识网格
回顾 RAG 三个世代的演进,一条主线是非常清晰的:知识从"中心化囤积"走向"分布式服务"。 RAG 1.0 把所有知识塞进一个向量库,1.0 的问题是怎么把东西找出来。RAG 2.0 在向量库之上引入了意图理解和混合检索,2.0 的问题是怎么理解你到底想找什么。RAG 3.0 把"库"的概念打散——知识不再集中存储,而是作为独立的 MCP 服务分布在各处,由协议保证其被发现、被访问、被溯源。
这条演进路径与软件工程的"巨石 → 服务化 → 网格"轨迹高度平行。RAG 1.0 是知识领域的巨石应用,RAG 2.0 引入了内部编排,RAG 3.0 是知识的微服务化。而 2026 年下半年正在萌生的方向——知识网格(Knowledge Mesh)——可能成为下一次跃迁:在分布式的 MCP 节点之上,叠加统一的元数据注册中心、智能路由、跨源一致性协议等网格层能力,让知识服务的运维从"手工作坊"进入"自动化治理"。
这不是一个已经完成的故事,但我们至少看清了故事的走向。
引用来源: [1] WorkOS, "The biggest MCP spec update ships July 28: What changes for AI agent authentication," 2026. workos.com [2] Mem0 Engineering Team, "State of AI Agent Memory 2026: Benchmarks, Architectures," Mem0 Blog, 2026. mem0.ai [3] Mem0 Blog, "Memory Poisoning in AI Agents: How Bad Inputs Corrupt Agent Memory," June 22, 2026. mem0.ai
6.6.1.4 RAG 集成开源框架
前三节我们沿着 RAG 1.0 → 2.0 → 3.0 的时间线梳理了一套从"朴素检索"到"分布式知识服务"的完整技术链条。截至这里讨论的都是离散的技术组件——数据解析工具、向量数据库、Embedding 模型、意图重写、MCP 协议——它们各自解决了 RAG 管道中的一个环节。但在 2026 年的实际工程中,很少有人从零开始把这些组件拼装起来。你需要的是一个集成框架——把前述的检索、重排、编排与协议映射封装成一套可部署、可运维的工业级平台。
目前开源社区形成了三足鼎立的格局。三者的定位不同,选型错误会让你交一笔不菲的工程学费。下面逐一拆解。
① Dify:Agentic RAG 编排引擎
Dify 是 2026 年全球最活跃的 LLM 应用开发平台,GitHub 上已经积累了超过 80K 的星标。它解决的问题不是"怎么检索得更准",而是**"怎么让检索成为 Agent 思考链条中的一个可编排环节"**。
- 资源:github.com/langgenius/dify,推荐 Docker Compose 一键部署。
- 核心理念:可视化工作流编排。Dify 的灵魂不在检索算法里,而在它的画布上——你可以像画流程图一样拖拽"知识检索""LLM 推理""条件判断""HTTP 请求"等节点,连线构成完整的业务逻辑。一个典型的场景是:用户问题进入 → 先做意图分类节点(投诉还是咨询)→ 根据分类走不同分支 → 各自检索不同知识库 → 各自用不同的 System Prompt 生成回答。整套逻辑不需要写 Python 代码,画布上的每个节点都有独立的配置面板。
- RAG 能力:原生支持混合检索(向量 + 关键词)、Reranker、多知识库联合召回、以及对检索结果的二次筛选(Top-K + Score Threshold)。它的知识库不是"一个向量集",而是可以被工作流节点按需引用的可组合模块。一个对话型 Agent 可以同时查"产品手册""FAQ 库""政策文档"三个库,并在 Prompt 中分别标注来源。
- 生态系统:内置了对几乎所有主流推理引擎(vLLM、Ollama、SGLang)和向量数据库(Milvus、Qdrant、Weaviate)的适配。LLM 后端通过一个统一配置面板切换,不需要改动工作流。这意味着你可以用本地 Ollama 跑开发和测试,上线时把后端切到云端 GPU 集群的 vLLM,工作流本身零修改。
- 版本控制:Dify 的 DSL 导出功能是整个 RAG 生态中少有的重视"配置即代码"的设计。你可以把整个应用的配置(工作流、知识库定义、模型参数、Prompt 模板)导出为一个 YAML 文件,放入 Git 管理。开发环境导出 DSL → 生产环境导入 → 配置版本可追溯、可回滚。对于需要多环境一致的团队,这是杀手级功能。
- 最佳实践:
- 把高频调用、逻辑简单的检索场景做成独立的知识库 API,供下游 Agent 直接调用;复杂的多步推理放到工作流画布里编排。
- 使用"条件节点"做路由而非在 Prompt 里枚举所有可能性——前者可控、可测、可观测,后者依赖模型的零样本推理能力,出错了没法定位到哪一步。
- 避坑:Dify 的部署依赖 PostgreSQL、Redis 和至少一个向量库服务(Weaviate/Qdrant/Milvus),是一个微服务集合而非单体应用。每次版本升级前务必全量备份数据库——它不是简单替换 Docker 镜像就能安全完成的。生产环境的备份策略应覆盖 PostgreSQL 数据和向量库索引两个层面。
② RAGFlow:深度文档理解引擎
如果说 Dify 的强项是"编排",RAGFlow 的强项就是**"读懂文档"**。它解决的是一个 Dify 和大多数 RAG 框架都处理不好的问题:复杂排版下文档信息的完整提取。
- 资源:github.com/infiniflow/ragflow,推荐 Docker 部署。
- 核心理念:深度学习驱动的文档结构解析。传统解析器(如 PyMuPDF4LLM)的工作方式是"读 PDF 文本流"——你能拿到字,但格式的语义信息(哪个是标题、哪个是正文、哪个是表格标题、哪个是页脚注释)丢失了。RAGFlow 换了一条路径:它用深度学习视觉模型先"看懂"文档的物理布局(Layout Analysis),识别出标题区、正文区、表格区、图片区、页眉页脚,然后在各自的区域内做文本提取。
- 智能分块(Intelligent Chunking):这是 RAGFlow 最区别于同行的能力。传统 Chunking 按固定长度(如 500 字)或固定分隔符(如换行)切分,不知道哪里是语义边界。RAGFlow 基于视觉布局识别结果切分——表格会作为一个整体保留(不会被拦腰切断),跨页的表格会通过布局分析自动合并,标题和其下正文保持在同一块内。这直接解决了 RAG 1.0 最头疼的"表头表身分离"问题。
- 所见即所得调试:RAGFlow 的管理后台会可视化展示每个文档被切分后的结果——你能看到原始 PDF 上标记的分块边界,直接验证"这个表格是不是被切断了"。对于文档质量参差不齐的场景(如同时包含扫描件、原生 PDF 和图片的归档文件),这种可视化的反馈闭环能帮你快速定位是解析器的问题还是 Chunking 策略的问题。
- 硬件门槛:这是 RAGFlow 最大的限制。视觉布局分析模型和内置的 OCR 引擎需要 GPU 支持,没有 GPU 时处理速度会下降到不可用的程度。官方建议的最低配置是有 GPU 的服务器,内存不低于 32GB。不要在只有 16GB 内存且无 GPU 的机器上尝试全量部署——你会得到的结果是能启动但处理一份 50 页 PDF 耗时数分钟。
- 最佳实践:
- 把 RAGFlow 定位为数据预处理管道,而非端到端应用平台。用它做好文档解析和智能分块,把产出的结构化数据写入你自己的向量库,上层应用逻辑交给 Dify 或自研系统。
- 对于扫描件较多的场景,务必开启内置 OCR 增强并配合 BGE-M3 级别的 Embedding 模型——低质量 OCR 文本搭配弱 Embedding 模型的检索效果会雪崩式下跌。
- 避坑:RAGFlow 的 GPU 显存占用取决于同时处理的文档数量和模型配置。处理大批量文档时,建议分批提交而非一次性导入全部——既能控制显存峰值,也便于在发现切分问题时及时调整参数后重跑。
③ FastGPT:私有化知识库的稳定器
FastGPT 是三款框架中最"克制"的一款。它不追求编排能力,不追求文档理解深度,它的目标极其聚焦:以最小的运维成本和最高的稳定性,提供一个可私有部署的问答知识库。
- 资源:github.com/labring/FastGPT。
- 核心理念:问答对(Q&A Pair)管理 + 精确检索。FastGPT 的知识库不是以"文档"为单位组织的,而是以"问答对"为最小单元。你可以直接导入 FAQ 列表(CSV 格式、问题-答案对),系统会自动向量化并为每个问答对建立索引。对于有现成 FAQ 库的企业来说,这个路径比"上传 PDF → 等解析 → 修切分"快得多。即便没有现成 FAQ,FastGPT 也提供了 AI 辅助将文档拆分为问答对的功能。
- 中文友好:FastGPT 是国产开源项目,其 UI、文档、Prompt 模板默认面向中文场景进行了优化。在中文多级分类知识库管理(如按部门 → 按产品线 → 按版本号)的场景下,它的交互设计比 Dify 更直观——分类树直接映射到前端左侧导航,不需要在画布里画路由逻辑。
- 部署简洁:相比于 Dify 的微服务矩阵和 RAGFlow 的 GPU 依赖,FastGPT 的部署负担最轻。核心依赖是 MongoDB(用于问答对和对话记录存储)、PostgreSQL 和向量库。实测在 2C4G 的轻量云服务器上即可跑通小规模知识库服务,前端页面直接可用。
- 性能优势:由于检索逻辑被简化为"在已拆分的问答对中做向量匹配",FastGPT 的检索延迟远低于需要实时做文档切分和上下文拼接的方案。在客服机器人、内部 IT 助手这类"问法固定、答案明确"的场景中,它的响应速度比通用 RAG 框架快得多。代价是灵活性——如果你的用户会问"上周的销售数据和前年的同期比差了多少"这种跨文档、需要多段信息综合的问题,FastGPT 不是设计用来解决这类问题的。
- 避坑:FastGPT 对 MongoDB 有较强的依赖,问答对、对话历史、用户会话状态都存储在 MongoDB 中。部署时务必配置 MongoDB 的持久化卷(Volume),默认配置下容器重启会导致数据丢失。另外,如果你的知识资产主要形态是长文档而非离散的 FAQ,不建议硬上 FastGPT——把一本 200 页的操作手册拆成上千个问答对是一个费力不讨好的过程,这种场景更适合 RAGFlow 做文档解析 + Dify 做检索编排的组合。
> 大模型架构师的选型:三个框架不是"谁更好",是"你更需要什么"
这三个框架代表了 RAG 落地过程中的三种不同需求,它们不是相互替代的关系:
选 Dify,是因为你的 RAG 不是一个独立功能,而是 Agent 逻辑链条上的一环。你需要的是检索、推理、外部工具调用和条件分支在同一个画布里被编排,且配置需要版本管理、多环境一致。——Dify 是"数字员工"的组装线,你用它把检索和其他能力拼在一起,而不是让它单独查数据库。
选 RAGFlow,是因为你的文档是"硬骨头"。PDF 堆积如山、表格嵌套复杂、扫描件和原生文档混在一起——这些文档不先被"读懂",再好的检索框架也白搭。——RAGFlow 是文档理解的深加工车间,它负责把难啃的原料变成干净的输入,而不是直接面对最终用户。
选 FastGPT,是因为你的需求清晰、边界明确。一个内部知识库,问法固定、答案明确、不需要花式编排。——FastGPT 是快刀手,它用最少的组件做一件事:把已有的知识通过问答形式输出给用的人。不图花哨,但求稳定。
这三个定位的差异也意味着:在实际项目中,一套完整的 RAG 管线完全可以由多框架拼合而成。典型的中大型项目架构是:RAGFlow 负责前端文档深加工 → 产出的结构化数据写入 Dify 管理的知识库 → Dify 工作流负责检索编排 + Agent 逻辑 → FastGPT 覆盖 FAQ 类和标准化问答场景。 三者在一条管线里各司其职,各取所长。
但如果不是大型项目、不需要全链路覆盖,按照自己的核心需求选一个就够了——选错的代价不是功能缺失,而是运维成本翻倍。
6.6.1.5 RAG 服务平台
上一节我们讨论了三款开源框架——它们需要你部署、维护、升级。但并非所有项目都需要这种"全栈掌控"。在 2026 年,如果你不想维护向量数据库和 Docker 集群,RAG 服务平台(RAG-as-a-Service) 是一条更轻量的路径。它们将文档解析、切片、向量化、检索、重排和模型生成全部封装在云端,你只需通过 Web 界面或 API 上传文档即可完成"知识喂养"——省下的运维精力可以直接花在业务逻辑上。
当然,代价也相应存在:数据不在你的服务器上,定制化能力受限于平台提供的能力边界。这是所有 SaaS 服务的经典权衡——本节介绍的四个平台,本质上是在不同维度上对这个权衡做出了不同的取舍。
① Coze(字节跳动 / 扣子):消费级 Agent 的快速通道
Coze 是 2026 年全球最活跃的 Agent/RAG 平台,背靠字节跳动旗下豆包大模型。
- 资源:Coze.cn(国内版)/ Coze.com(国际版)。
- 核心卖点:极致的生态连接。Coze 不是孤立的知识库工具——它的知识库天然连接着飞书文档、飞书多维表格和抖音生态。你可以把公司维护在飞书多维表格中的产品数据直接映射为知识库,用户提问时检索的不是文档片段,而是结构化的字段值。这种"以结构化数据替代非结构化文档检索"的思路,在实际准确率上远高于同等 Embedding 模型下的纯 PDF 向量检索。
- MCP 原生支持:Coze 是业界最早大规模集成 MCP 协议的平台之一。你可以在插件市场中为 Agent 挂载外部 API 能力——从天气查询到股票数据到内部系统接口——这些插件以 MCP 标准化方式接入,Agent 在工作流中按需调用。这使得 Coze 上的 Bot 不只是"问答机器人",而可以是一个能查数据、能发消息、能推送通知的自动化 Agent。
- 分发渠道:如果你的目标是"做一个机器人并分发到飞书、抖音或微信公众号",Coze 的发布流程是四个平台中最流畅的——几步配置就能上线,不需要额外写适配层的代码。
- 数据局限:数据主权在平台手中。对于金融合规、医疗患者数据、政府涉密文件等场景,这是刚性不可接受的约束。有数据主权要求请回到 6.6.1.4 节选择 Dify 开源版或 RAGFlow 私有化部署。
- 最佳实践:优先用飞书多维表格替代 PDF 作为知识库的数据源——结构化字段的检索准确率远高于非结构化文档的语义匹配。
② Dify Cloud:从原型到生产的平滑路径
Dify Cloud 是 Dify 开源版的托管版本,核心体验与自部署版完全一致,区别在于底层基础设施由 Dify 团队代管。
- 资源:dify.ai。
- 核心卖点:模型无关 + 迁移平滑。与 Coze 绑定豆包、百度千帆绑定文心不同,Dify Cloud 允许你在同一个工作流内自由切换模型后端——OpenAI、Claude、DeepSeek、通义千问、本地 vLLM——切换模型只需要在配置面板改一行,不需要改动你的工作流和 Prompt。这对需要"A/B 测试不同模型在同一个 RAG 任务上的表现"的团队来说,是难以替代的能力。
- 混合云路径:Dify Cloud 的独特优势在于它的"退路"。你用 Dify Cloud 做原型验证和初期运营,当数据量增长到需要私有化部署时,导出工作流 DSL 文件,导入自部署的 Dify 开源版,整套业务逻辑几乎零迁移成本。这是 Coze 和百度千帆做不到的——它们的编排格式是平台私有格式,无法导出到自建环境。
- 成本注意:免费额度消耗较快。Dify Cloud 的免费套餐适合开发阶段的文档测试(几十页),一旦进入生产环境的大规模文档索引和检索,建议仔细评估按量付费的成本——大文档量场景下,自部署 Dify 开源版可能会在月度费用上更划算。
- 最佳实践:开发阶段用 Dify Cloud 快速验证工作流逻辑 → 确认方案可行后导出 DSL → 生产环境用自部署版承载全量数据和流量。这条路径同时解决了"开发效率"和"长期成本"两个矛盾的需求。
③ 百度千帆 AppBuilder:中文理解 + 实时搜索的强力组合
百度千帆 AppBuilder 是在文心一言模型上构建的 RAG 应用开发平台,它的差异化竞争力来自两个方向。
- 资源:百度智能云千帆平台。
- 核心卖点一:文心深度集成。千帆对文心模型的 RAG 链路做了端到端的对齐优化——从文档解析的分词策略到检索阶段的语义匹配,整条管道为文心模型做了针对性的调优。如果你的整个模型栈已经选定了文心,千帆是效率最高的选择。
- 核心卖点二:百度搜索深度集成。这是千帆最不可替代的能力。在千帆的 Agent 配置中,你可以勾选"联网搜索"并指定使用百度搜索——Agent 会自动将搜索返回的实时网页信息作为上下文注入 Prompt。对于需要结合最新政策、行业动态、新闻事件来回答问题的场景(如法律咨询、政策解读、行业分析),这个能力是实现"实时 RAG"的最短路径——不需要自己写爬虫、不需要额外维护网页索引。
- 合规优势:在国内政企领域,百度千帆的合规性认证(等保、数据安全管理认证)和国产化生态适配(飞桨、昆仑芯片)是其他国外/跨平台方案无法比拟的。这是技术之外的刚性决策因素。
- 锁定风险:千帆的某些组件与百度云生态深度绑定。如果你采用了百度搜索插件、文心模型的特定能力、或基于百度的存储方案,未来跨云迁移的工作量会比 Dify 的"导出 DSL → 重新导入"大得多。选千帆的心态应该是"我主动选择百度生态",而不是"我先用用再看"。
④ AWS Bedrock Knowledge Bases:全球企业级 RAG 的工业标准
如果你所在的企业已经在 AWS 上运行着整套基础设施,AWS Bedrock Knowledge Bases 是路径依赖最短的选择。它不是"另一个 RAG 平台",而是 AWS 云服务体系中原生的知识检索基础设施。
- 资源:AWS Bedrock Knowledge Bases。
- 核心理念:全自动 RAG 管道。你只需指定一个 S3 存储桶作为数据源,Bedrock 会自动完成文档摄取、分块、向量化、存入 OpenSearch 向量引擎的全过程。你不需要手动配置 Chunking 策略、不需要管理 OpenSearch 集群——这些都是 Bedrock 服务内部完成的。从 S3 到可查询的知识库,全流程通过 AWS 控制台或 SDK 完成,不需要写一行 RAG 处理的代码。
- 企业合规:Bedrock 的服务体系已经通过了 SOC、HIPAA、FedRAMP 等全球主流合规认证。对于医疗(HIPAA)、金融(PCI-DSS)、政府(FedRAMP)等强监管行业,这意味着你不需要自证合规——AWS 的认证可以覆盖到服务层面。
- 模型选择:Bedrock Knowledge Bases 支持亚马逊自己的 Titan 模型、Claude(Anthropic)、Llama 3(Meta)等多种基础模型做检索增强生成。模型切换通过 API 参数控制,检索管道不变。
- 代价:AWS 账单的不可预测性是一个真实的问题。OpenSearch 集群的规模和检索请求量是主要的成本驱动因素——在小规模测试阶段几乎感觉不到,但一旦用户量上来,建议启用预算告警和请求限制。
RAG 选型决策参考
| 核心场景 | 推荐平台 | 理由 |
|---|---|---|
| 快速做飞书/抖音/微信机器人 | Coze | 生态连接最强:多维表格知识库 + 插件市场 + 分发渠道,三者都成熟。 |
| 需要灵活切换不同大模型后端 | Dify Cloud | 模型无关架构,工作流 DSL 可导出、可私有化迁移,无厂商锁定风险。 |
| 需要实时搜索 + 中文理解深度 | 百度千帆 AppBuilder | 百度搜索插件不可替代,文心模型 RAG 链路端到端优化。 |
| 金融/医疗/政府等强合规数据 | 排除平台 | 回到 6.6.1.4 节,选择 Dify 开源版或 RAGFlow 的私有化部署。 |
| 已在 AWS 上运行全栈基础设施 | AWS Bedrock KB | 零额外集成成本:S3 → OpenSearch 管道全自动,合规认证现成。 |
实践建议:
服务平台和开源框架不是非此即彼的关系。它们解决的是同一个问题在不同阶段的不同解法。2026 年一个成熟团队的典型策略是:用 Coze 跑 PoC(概念验证),用 Dify Cloud 做 MVP(最小可行产品),用自部署 Dify/RAGFlow 上生产。
买服务是为了买时间,做私有化是为了买安全——这两个方向不是"选一个",而是在不同的项目阶段做出不同的选择。优秀的架构师应该能在 10 分钟内用 Coze 跑通 Demo,在 1 小时内用 Dify 实现生产级编排,并且清楚地知道什么时候该从托管服务切换到私有部署——那通常不是"上了量"的时候,而是"业务需要可控的运维边界"的时候。
6.6.2 上下文管理:大模型系统的"动态内存"
前面几节我们花了大量篇幅讨论 RAG 如何组织知识、如何把正确的片段找出来——这解决的是"知识从哪里来"的问题。但一个同样紧迫的问题随之浮现:知识来了以后,放在哪里?怎么用?
这就是上下文管理要回答的问题。
如果把大模型(LLM)比作执行指令的 CPU,把知识增强层(RAG/MCP)比作海量数据的硬盘,那么上下文管理就是整套系统的内存(RAM)。它不负责"存"知识——那是 RAG 的事;也不负责"算"知识——那是 LLM 的事。它只负责一件事:在当前这一刻,让模型"看到"它最该看到的那些信息,并屏蔽掉所有不该看到的噪音。
这块"内存"极其昂贵。2026 年,主流模型的上下文窗口已经扩展到 128K 甚至 1M Token,但这不是说你可以无脑把所有东西塞进去——因为上下文越长,推理成本越高、速度越慢、信噪比越低。上下文管理的本质,就是在"够用"和"不贵"之间找到一个动态平衡点。
6.6.2.1 上下文管理的三重角色
要理解上下文管理,光看技术名词是不够的。我们先从它在系统中扮演的三重角色入手:
角色一:时序导航员(Temporal Navigator)
对话不是线性的。用户可能说了半天技术方案,突然问一句"对了,咱们最开始说的那个预算表还在吗?"——这时模型必须能回溯到几轮之前的上下文,而不是死盯着最近的三条消息。上下文管理的第一个职责,就是管理对话的连贯性,支持用户在话题分支间自由切换与回溯,防止模型"迷失在历史的废话中"。
角色二:语义蒸馏器(Semantic Distiller)
十轮对话不等于十条消息。用户的真实意图——"我想用 Python 做一个自动生成周报的工具"——可能是在第三轮提出的,后面七轮全在讨论依赖版本和 API key 怎么配。如果模型每次都读十轮完整对话,大部分 Token 都浪费在"试了 pip install 但报错了"这种一次性信息上。语义蒸馏器的任务,就是把冗长的原始对话压缩为高浓度的"知识状态",提高推理的信噪比。
角色三:价值转换器(Value Converter)
上下文管理不仅服务于"当下",还服务于"将来"。当它发现用户反复强调某个偏好——比如"我特别在意成本,别推荐贵的方案"——就不应该让这个信息随会话结束而消失。价值转换器的任务,就是捕捉对话中的优质内容,将其转化为长期知识图谱或用户画像,让应用实现"越用越懂你"的自我进化。
三重角色听起来抽象,但在工程落地时,它们分别对应着一组具体的工具和技术。下面这个技术字典,就是你在 2026 年搭建上下文管理系统的工具箱。
6.6.2.2 上下文管理技术字典
1. 动态滑窗与优先级裁剪
上下文窗口不是越大越好,而是越精准越好。动态滑窗(Sliding Window)是上下文管理最朴素的思想——始终保持最新的 N 轮对话在窗口内,超出的直接丢弃。但朴素的滑窗有个致命问题:它不会判断"哪些历史是重要历史"。
优先级裁剪是对滑窗的升级。其核心逻辑是:当 Token 接近上限时,不是简单地丢掉最老的内容,而是根据每条消息的"权重标签"来决定删谁、留谁。关键转折点——用户确认的决策、核心参数设定、偏好声明——永远保留;中间的寒暄、重复解释、失败的尝试——优先丢。
最佳实践:1+N+M 模式
工程上,一个成熟的优先级裁剪策略通常采用 1+N+M 模式:
- 1 — 永远保留系统提示词(System Prompt)。这是模型的"身份卡"和"行为手册",丢了它,模型就不知道自己是干什么的了。
- N — 保留 N 条核心意图摘要。不是原始对话,而是经过语义蒸馏后的压缩结果,比如"用户想用 Python 实现周报自动化,预算不超过 500 元/月"。
- M — 保留最近 M 条原始对话。保证模型对"当下正在发生什么"有精确感知。
避坑指南:Lost in the Middle
即使你精细地裁剪了上下文,还有最后一个陷阱等着你——Lost in the Middle 现象。大量研究表明,大语言模型在读取长文本时,对开头和结尾的内容最敏感,而对中间部分的理解力明显下降[17]。这意味着,如果你把最重要的指令放在窗口中间,模型大概率会"忽略"它。
破解方法很简单:把最重要的指令放在 System Prompt 的最前面,把当前最相关的上下文放在窗口的末尾。 "首尾原则"是上下文工程的第一条铁律。
2. 多路分支管理
动态滑窗解决了"纵向"的上下文取舍问题,但还有"横向"的挑战:对话不是线性的,而是树状的。
考虑这个场景:你正在跟一个代码助手讨论重构方案,已经聊了 20 轮。突然你想起一个完全不相关的问题——"对了,昨天那个 Bug 你帮我查了原因吗?"——助手需要立刻切换到一个截然不同的上下文。如果此时它把重构对话和历史 Bug 分析混在一起,两个话题都会烂掉。
解决方案:上下文快照(Context Snapshot)
思路不复杂:在每个对话阶段的关键节点,将当前上下文状态"拍照"保存——包括 System Prompt、压缩后的意图摘要、当前活跃的原始消息——存入 Redis 或向量数据库。每组对话分配一个唯一的 Parent_ID 作为标识。
当用户切换话题时,系统根据 Parent_ID 快速重装(Reload)目标快照,物理隔绝当前话题的噪音。这不是"魔法",而是和操作系统保存进程上下文(Context Switching)完全相同的思路。
目前状态:多路分支管理已经是复杂 Agent 任务(代码重构、多轮技术选型、长周期项目管理)的刚需。没有它,Agent 就是"翻脸不认人"的健忘症患者。
3. 语义压缩与记忆提取:Mem0 / Zep
优先级裁剪和快照管理解决的是"短期记忆"问题。但一个真正有用的系统,还需要"长期记忆"——不是记住每一句话,而是记住用户是个什么样的人。
Mem0 和 Zep 是 2026 年语境下最活跃的两个记忆层工具。
Mem0(mem0.ai)的核心思路是"自动化用户画像":它从对话中自动提取实体和偏好——"用户喜欢用 Python 开发""用户对成本很敏感""团队的技术栈是 Go + PostgreSQL"——并持久化存储,在后续对话中自动注入这些"事实陈述"。
Zep(getzep/zep)则更侧重对话的时序建模,它能识别"用户在第 3 轮说喜欢方案 A、在第 7 轮又推翻了这个选择"这样的演化轨迹。
最佳实践:异步压缩
不要在高频对话中同步跑记忆提取——那会让用户干等。工程上的正确做法是在对话空闲期异步运行压缩逻辑。一个典型的效果:10 轮对话被压缩为不到 300 字的"事实陈述",后续调用时只需注入这 300 字,就能让模型"记得"用户的核心偏好,而不用重复消费几千 Token 的历史对话。
目前状态:记忆层在 2026 年已经从"可选优化"升级为"标配组件"。没有它,你的系统永远停留在"聊一次忘一次"的水平。
4. 实时安全拦截:Context Guardrail
上下文管理不仅要管"该放什么进窗口",还要管"什么绝对不能放进去"。
核心问题:隐私泄漏
一个典型的安全事故路径是这样的:用户在一次对话中输入了身份证号,你的上下文管理系统忠实地把这条消息存入了向量数据库。下次检索时,这条敏感信息被召回并注入到另一个用户的 Prompt 中——这就是一起严重的数据泄漏事故。
解决方案:动态脱敏(Dynamic Masking)
在上下文组装阶段——即将注入 Prompt 之前——过一遍轻量级的敏感信息过滤器。身份证号 → 130****1234,API Key → sk-****-abcd,手机号 → 138****5678。规则不复杂,但必须严格执行。
铁律:入库前脱敏,而非出库后补救。 严禁将原始敏感信息直接存入向量数据库。一旦原始数据入库,你永远无法保证它在未来的某一刻不会被某个检索查询命中。
5. 显存优化:KV Cache 管理
前面讲的都是"管哪些内容",最后这个技术关注的是"底层怎么高效存"。
每处理一个 Token,推理引擎就会在 GPU 显存中生成一组 KV(Key-Value)矩阵,用于后续 Token 的注意力计算。上下文越长,KV Cache 占用的显存越大。如果有 100 个用户同时对话、每人 10K Token 的上下文,KV Cache 会迅速吞噬显存。
PagedAttention 与 Prefix Caching
vLLM 等推理引擎引入了 PagedAttention 技术,其核心思想和操作系统中的虚拟内存如出一辙:将 KV Cache 切分为固定大小的"页",不连续存储在物理显存中,就像内存分页一样按需调度。这有效避免了显存碎片化,让推理引擎能同时服务更多用户。
Prefix Caching 则更进一步:如果多个用户共用一段相同的系统提示词——这在 SaaS 产品中极为常见——那么这段提示词只需要计算一次 KV Cache,所有用户共享复用。这是一个看似简单但效果立竿见影的优化:在 128K Token 的上下文窗口中,一份 2K Token 的系统提示词如果被 50 个用户复用,节省的显存是 50 × 2K 的 KV Cache。
开发者须知:你不需要自己实现 PagedAttention——那是推理引擎的事。但你应该知道
max_num_seqs这类参数的含义:它控制引擎同时处理的序列数上限,在多用户场景中直接影响首 Token 延迟和显存占用之间的权衡。
实践建议:
"平庸的系统只是在堆叠历史,优秀的系统在管理状态。上下文管理不是一门'消息队列'技术,而是一门'信息工程学'——你在有限的内存中放什么、不放什么、怎么压缩、怎么切换,直接决定了一个 Agent 是'聊完即忘'的复读机,还是一个'越用越聪明'的数字专家。在 2026 年,上下文管理的好坏,比 Prompt 写得好坏更能决定一个系统的上限。"
6.7 和大模型的交互模式
第六章到这里,我们已经把大模型技术生态中"搭基础设施"的环节全部讲完了——从底层的 PyTorch 框架、微调工具链、推理引擎,到上层的 RAG 知识增强和 MCP 协议。这些组件解决的是同一个问题:如何让模型跑起来、记得住、连得上。
但还有一个问题没有被直接回答:你拿什么跟模型说话?
模型跑起来了,数据喂进去了,工具连上了——然后呢?你打一句话进去,它回一段话出来?这就是全部的交互方式吗?
事实证明,和你与模型交流的方式,决定了模型在你手上能发挥多高的上限。 同一个模型,同样的硬件配置,两个人用出来可能有十倍的效果差距。差距不在模型本身——在交互模式。
交互模式是人与大模型之间的接口层。它不像 PyTorch 那样是底层框架,也不像推理引擎那样管部署,更没有 RAG 那样扎实的"查资料"功能。但它决定了前面所有这些组件最终能不能被"用对"。你可以把知识库建得再完善,把推理引擎调得再快——如果你发给模型的只是一个随意打完的句子,模型给你的大概率也只是一个随意的回答。反过来,如果你能把意图、约束和推理逻辑清晰地组织成结构化的交互,同样的模型会表现出完全不同的能力层级。
本节覆盖三种核心交互范式,它们构成了一个从"说清楚"到"想清楚"的递进:
6.7.1 提示词工程(Prompt Engineering) 解决的是"说清楚"。它研究如何系统化地构建指令,让模型准确理解你的意图。从 2023 年的人工试错,到 2026 年基于 CO-STAR 框架的结构化 Prompt 和 DSPy 的程序化自动化,提示词工程已经从"手艺"演变为"工程"——你的 Prompt 可以被模板引擎自动生成,可以被编译器自动优化,可以被评估管线自动校验。
6.7.2 思维链(Chain of Thought) 解决的是"想清楚"。如果你的 Prompt 是一个问题,Ctrl+C / Ctrl+V 得到的就是一个答案——但这个答案靠不靠谱,你没有判断的依据。思维链要求模型在给出答案之前先展示推理过程,把"黑盒输出"变成"可审查的逻辑链"。它不仅提升了模型在数学和推理任务上的表现,更重要的是让模型变得可调试、可信任。
6.7.3 交互模式的技术字典 解决的是"想得更深"。Auto-CoT 让模型自己学会写推理示例,把手工编写推理链的人力瓶颈变为自动化流水线;ToT(思维树)把单线程的推理路径扩展为多分支的搜索树,在复杂决策任务中实现"多想几步再选最优";SGLang 等动态推理控制框架则把推理过程的控制权从模型内部交还给开发者——你可以在 Prompt 中嵌入 Python 控制逻辑,精确控制模型在什么时机停止推理、什么时候输出答案。
这三节放在一起,描绘的是一条清晰的演进轨迹:从"只告诉模型做什么"到"要求模型展示为什么这么想",再到"赋予模型系统性深度推理的能力"。 交互模式不是锦上添花——对于 2026 年构建复杂 Agent 系统的工程师来说,它是决定模型从"能用"到"好用"的分水岭。
6.7.1 大模型的唤醒者:提示词(Prompt Engineering)
如果你问一个2023年底入门大模型的人"什么叫Prompt Engineering",他大概率会回答"就是写提示词"。这个回答对当时的应用阶段来说不算错——彼时大家确实在用精心雕琢的自然语言指令去"哄"模型给出好答案。
但如果你在2026年还这么回答,说明你错过了整个行业两年间的范式转变。
Prompt Engineering已从一门"手艺"变成了一项"工程"。 从人工试错到结构化框架,再从结构化框架到算法自动优化——这个演进路径背后有一个朴素的驱动力:手动调Prompt根本不可扩展。
想想看:你在2023年为一个客户问答场景写了20条Prompt模板,每条精心调整了措辞和示例。效果不错。但2024年业务扩展到50个场景,写1000条Prompt?2025年模型从GPT-4换了到DeepSeek-V3,同样的Prompt在新模型上效果跳水?2026年你要为每个用户动态生成个性化Prompt,而不是用固定模板?这些场景下,靠手工写Prompt的人力成本和品质一致性都不可接受。
这就是提示词工程在2026年的核心命题:如何系统化地、可复用地、可优化地让模型听懂你的意图。
CO-STAR:结构化Prompt的六要素框架
CO-STAR框架是目前业界最成熟的结构化Prompt设计方法论之一。它把"写提示词"这件看似艺术化的事拆解为六个要素,每个要素对应工程上的一个参数化维度。它的价值不在于"这样写Prompt效果更好"——而在于"这样写Prompt可以被系统化地管理、替换和评估"。
Context(背景):给模型一张"身份牌"。
背景不是简单地写一句"你是一个客服"。它要告诉模型三件事:它此刻在什么场景下工作、它知道什么信息、它不知道什么信息。
差的Context写法:
你是一个有帮助的助手。工程化的Context写法:
你正在为一家电商平台的售后工单系统工作。
你知道的信息:当前用户订单号 #N202606231045,该订单商品为"AX200蓝牙耳机",
  物流状态为"已签收",签收时间为2026-06-20 14:30。
你可以查的信息:通过调用 order_history() 获取用户历史订单,
  通过调用 return_policy(product_id) 获取退货政策。
你无权操作:不能发起退款、不能修改订单状态、不能承诺赔偿金额。
这个区别在工程上是本质的。第一个Prompt换到另一个场景完全不能用。第二个Prompt的Context部分可以被模板引擎自动生成——订单号、物流状态、商品名都是系统传进来的变量。这意味着:同一套Prompt代码可以服务所有订单,不需要为每个订单手写一个版本。
Context也是后续工具调用(Function Calling)的基础。模型需要知道"我能调用order_history()",否则它不会产生调用工具的意图。在Agent系统中,Context通常由上下文管理器(Context Manager)在运行时动态组装。
Objective(目标):把"想干什么"变成可验证的指令。
好的目标是可判定完成/未完成的。不是"回答用户问题",而是"根据退货政策判断用户是否符合退货条件,并在回复中明确给出'可退货'或'不可退货'的结论"。
工程上的技巧是:把Objective拆成"任务清单+约束条件"。
你的任务:
1. 确认用户退货请求的商品是否符合7天无理由退货时间条件。
2. 根据退货政策判定商品状态(已拆封/未拆封、附件齐全/缺失)。
3. 给出结论:"可退货" 或 "不可退货",并附理由。
约束条件:
- 如果用户未提供商品状态信息,在回复中追问,不要自行推测。
- 不得在结论中使用模糊措辞(如"可能""或许")。
- 回复总长度不超过200字。
拆成清单+约束之后,这个Objective可以被系统自动校验——你可以在评估流程里检查回复中是否出现了"可退货"或"不可退货",是否包含了追问逻辑。模糊的Objective"回答问题"无法做自动化评估。
Style(风格)与Tone(语调):给输出的"语气光谱"调准。
很多人把Style和Tone混为一谈。它们的工程含义是不同的。
Style是产出形式的结构特征。比如:"用技术文档风格""用小红书种草文风格""用学术论文风格"。它决定了输出的句式复杂度、是否使用emoji、段落长度、名词的专业程度。
Tone是产出内容的情感色彩。比如:"积极热情""中立客观""警惕慎重"。它决定了输出中的措辞倾向——"我们很高兴为您处理"(积极)vs "根据政策,您的请求正在处理中"(中立)。
在工程上,Style和Tone往往通过Prompt中的few-shot示例来控制,比抽象描述更可靠。与其写"语气要温和",不如给两个示例:一个正确的温和回复和一个错误的生硬回复,让模型从对比中学习比从形容词中学习的精度高得多。
Audience(受众):对齐输出内容的知识水位。
写给技术主管看的报告和写给客户看的说明,内容差别巨大。Audience要素解决的就是这个"知识水位对齐"问题。
它的工程价值在面对多角色系统时尤其明显。同一个模型,同一个场景,面对不同的受众需要不同的输出。在Prompt层面指定Audience,比事后用代码做格式转换更高效,因为模型的生成质量天然会考虑受众的知识背景。
Audience: 没有技术背景的普通消费者,初中文化水平即可理解。加上这一行之后,模型会自动避开"退换货流程中的逆向物流环节"这种术语,改用"我们把商品寄回去的流程"。这是Prompt层面对齐的效果,不需要下游再做一个"术语翻译层"。
Response(响应格式):把"模型说了什么"变成"代码能读的"。
这是六个要素中最具工程价值的一环。如果不指定Response格式,模型可能返回一段优美的散文——你没法用代码解析它。
在2026年的标准实践中,Response要素要做三件事:
- 指定输出格式:JSON、Markdown、纯文本。
- 给出Schema:JSON要有字段定义和示例值。
- 指定异常模式:如果模型无法完成任务,怎么返回。
Response格式(严格遵守JSON):
{
  "is_returnable": true/false,
  "reason": "判定理由,不超过50字",
  "next_steps": ["步骤1", "步骤2"],
  "needs_manual_review": true/false
}

如果信息不足无法判定:
{
  "is_returnable": null,
  "reason": "需要用户补充:商品状态(已拆封/未拆封)",
  "next_steps": [],
  "needs_manual_review": false
}指定了Schema之后,你的代码就可以直接json.loads()解析返回值做业务逻辑。Schema也是评估自动化的基础——你可以用代码检查返回的JSON字段是否齐全、类型是否正确,而不需要每次人工review。
CO-STAR的综合工程意义。
单独看每个要素,似乎都是常识。但CO-STAR的真正价值在于把Prompt变成了一个六维参数空间。在这个空间里:
- 换一个场景?改Context即可,Objective和Response保持不动。
- 换一个受众?改Audience即可,其他五维不变。
- 换一个输出目的?改Objective和Response,其他不变。
这意味着你的Prompt不再是一个整体不可拆的"咒语",而是一个由六个独立参数组成的"配置项"。你可以在代码里管理这些参数——从数据库里读Context模板、从配置文件里读Style和Tone、从函数签名里推导Response的JSON Schema。
这就是从"手艺"到"工程"的跨越。
DSPy:当编译器开始替你写Prompt
CO-STAR框架解决的是"怎么把Prompt结构化"的问题。但它没有触及一个更深的问题:谁来告诉你这六个要素该填什么值?
传统做法是你自己填。Context怎么写更好?Objective用词是不是太模糊了?Audience从"普通用户"改成"技术用户"会不会提升准确率?你可能试了20个版本,选了准确率最高的那个。这个过程本质上是一个手工超参搜索——你在对Prompt做网格搜索(Grid Search),只是搜索空间不是数字,是自然语言。
这不是工程。工程意味着自动化、可重复、可扩展。
DSPy(Declarative Self-improving Python programs)就是在这种需求下诞生的。 它由斯坦福NLP实验室开发,核心思想一句话就能概括:你不再手写Prompt,你声明"我想要的输入输出行为",DSPy的编译器自动替你搜索最优的Prompt参数。
这句话值得停下来仔细理解。我们刚刚花了大量篇幅讨论CO-STAR六要素怎么填、每个要素有什么工程含义。在DSPy的世界观里,这些要素的填充不再是人工决策——它们是可优化的参数,和神经网络里的权重一样,可以通过数据和优化算法自动搜索得到。
DSPy的核心抽象:Signature和Module。
DSPy把每个大模型调用定义为一个带有**签名(Signature)**的程序模块(Module)。签名描述了输入和输出的字段:
python
import dspy

class ReturnJudge(dspy.Signature):
    """判断用户的退货申请是否合理。"""
    order_info = dspy.InputField()        # 订单信息
    return_request = dspy.InputField()    # 用户退货请求
    verdict = dspy.OutputField()          # 判定结果(可退货/不可退货)
reason = dspy.OutputField() # 判定理由注意这段代码里没有任何Prompt文本。没有"你是一个客服",没有"请回答JSON格式",没有"语气要温和"。你只声明了三件事:输入是什么(order_info, return_request)、输出是什么(verdict, reason)、这个模块要完成什么功能(判断用户的退货申请是否合理,写在docstring里)。
把所有精心雕琢的Prompt措辞都省略掉,这看起来不可思议——没有Prompt,模型怎么知道该怎么做?答案在下一步:
python
# 准备训练数据:输入 + 期望输出
trainset = [
    dspy.Example(
        order_info="订单#N001,商品AX200耳机,已签收3天",
        return_request="耳机有杂音,要求退货",
        verdict="可退货",
        reason="商品存在质量问题,在7天无理由退货期内"
    ).with_inputs("order_info", "return_request"),
    # ... 更多训练样例
]

# 评估指标:判对给 1 分(字段名要与 ReturnJudge 的输出字段一致)
def accuracy_metric(example, pred, trace=None):
    return example.verdict == pred.verdict

# 定义优化器:使用BootstrapFewShot策略
optimizer = dspy.BootstrapFewShot(metric=accuracy_metric)

# 编译:自动搜索最优Prompt结构
compiled_judge = optimizer.compile(dspy.Predict(ReturnJudge), trainset=trainset)

# 直接使用编译后的模块——不需要任何手写Prompt
result = compiled_judge(
    order_info="订单#N002,商品BX500键盘,已签收1天",
    return_request="不想要了,申请退货"
)
print(result.verdict, result.reason)发生了什么?optimizer.compile()在背后做的事,比"自动写Prompt"要窄得多,边界必须说清楚——否则你会以为换了个优化器它就会自动学会新任务:
- 逐条试跑,收集通过的轨迹。 它从训练集里逐条试跑当前程序,把能通过
metric的完整轨迹(输入、中间推理、最终输出)留下来当示范。凑够默认 4 条自举示例就停(max_bootstrapped_demos=4),不会把整个训练集跑完。默认max_rounds=1——每条样本只试一轮,跑通就收,跑不通就跳过。 - 挑示例,不改措辞。 留下来的是示例(demos):默认最多 4 条自举示例(
max_bootstrapped_demos=4)+ 最多 16 条带标注示例(max_labeled_demos=16),拼进 Prompt 的示例区。 - 不动指令,不动输出格式。 指令文本和输出字段都来自你自己写的
Signature,BootstrapFewShot一个字都不改。要让编译器去改写指令文本,得用MIPROv2/COPRO这类优化器——那不是BootstrapFewShot的职责。 - 签名里没有 valset。
compile(student, trainset=...)只收trainset,没有验证集参数。内部确实会把没跑通的样本收集到self.validation,但它只用于补足 labeled demo 的抽样池,不参与选优。所以也不存在“迭代到指标最优”这回事——想按验证集挑最优,得自己在外面套一层评估循环。
一句话把边界记住:BootstrapFewShot 是示例选择器,不是"自动调参到最优"的编译器。它做的事小而确定——把"挑哪几个 few-shot 例子"从手工变成可复现。这本身已经很有价值,但别指望它替你改 Prompt。
你不需要手写 few-shot 示例,也不需要为了“哪几个例子效果更好”反复做实验。你只声明输入输出的语义关系(Signature),挑选示范例这一步由编译器替你完成。
注意这里的分工:字段定义和任务描述仍然要你写对,DSPy 替你省掉的是“从训练集里找哪几个例子放进去”。这也是为什么下一节会强调——数据质量决定上限,因为编译器只能在给定的训练集里挑。
范式转变:从"人调Prompt"到"系统优化Prompt"。
这个转变的深刻程度,可以和"从手写SQL到ORM"、"从硬编码规则到机器学习"类比。过去你花的时间在调试模型的输入——反复修改Prompt文本看效果如何。DSPy让你的时间花在定义问题和准备数据上——Prompt优化是编译器的事。
这种转变在工程上意味着三件事:
第一,Prompt成为可版本管理的资产。 DSPy的编译结果是一个可序列化的程序对象,你可以保存它、加载它、在CI/CD流水线里自动重新编译它。当底层模型升级时,用新模型重新跑一遍编译器,得到适应新模型的最优Prompt——不需要人工"GPT-4→DeepSeek-V3迁移手册"。
第二,少量高质量数据驱动大规模优化。 CO-STAR框架里,Style和Tone要靠人工调整措辞。DSPy中,你只需要准备几十个带有标杆回复的样本,编译器就能自动学会该用什么风格和语调。你的角色从"Prompt工匠"变成了"数据标注师"——这是一个更可规模化的分工。
第三,Prompt优化从艺术变成科学。 你可以在不同的DSPy优化策略(BootstrapFewShot、MIPROv2、COPRO)之间做对比实验,用A/B测试的框架来决定哪个编译策略效果更好——就和选一个更好的优化器一样自然。
DSPy在工程实践中的定位。
DSPy不替代基础模型,也不替代推理引擎。它位于"应用逻辑"和"模型调用"之间,作为一个提示词优化的中间件。在2026年的Agent开发流程中,DSPy已逐渐成为高级Agent开发的标准组件——它的典型使用场景包括:
- 分类/判定任务:如垃圾邮件检测、意图识别、情感分析。用几十个标注样本编译一个分类模块,效果往往优于手写Prompt,且可维护性高得多。
- 多步骤Agent流水线:用DSPy的
ChainOfThought和ReAct模块构建推理流程,编译器自动为每一步生成最优提示词。 - 模型迁移:从OpenAI切换到Anthropic或开源模型时,只需换掉
lm配置,重新编译,无需重写所有Prompt。
一个必踩的坑:ChainOfThought 会多出一个输出字段。 上面的 dspy.Predict(ReturnJudge) 输出字段与 ReturnJudge 声明的一致。但把它换成 dspy.ChainOfThought(ReturnJudge) 后,模块会在你声明的字段之外自动增加一个 reasoning——这是它内置的思维链字段,不在你的 Signature 里。
实测(dspy 2.6.13)两个模块的输出字段:
| 模块 | 输出字段 |
|---|---|
dspy.Predict(ReturnJudge) | ['verdict', 'reason'] |
dspy.ChainOfThought(ReturnJudge) | ['reasoning', 'verdict', 'reason'] |
同一份 Signature,换模块就换字段集。若下游按固定字段解析,会碰上下面的报错:
ValueError: Expected dict_keys(['reasoning', 'verdict', 'reason'])
but got dict_keys(['verdict', 'reason'])注意一个陷阱:当 ChatAdapter 解析失败、自动回退到 JSONAdapter 时,你看到的表层报错会变成 AttributeError: 'list' object has no attribute 'items'。这是 chat_adapter.py 的回退逻辑(解析失败就用 JSONAdapter 重试一次)盖出来的——表层那条是假象,内层 ValueError 才是真因,直接搜表层报错会找不到答案。
写法上要按字段名取值,不要按位置解包:pred.verdict / pred.reason,需要思维链时用 getattr(pred, "reasoning", None);要整体导出用 pred.toDict()(实测返回三个键)。
补充:真模型下
reasoning由 CoT 自己生成,不会撞;主要是用桩模型或固定输出字段的假 LM 时才会碰上——而写测试时恰恰最容易用桩。
最小化可运行示例:一个完整的DSPy工作流(依赖:pip install dspy):
python
import dspy

# 1. 配置底层模型
lm = dspy.LM('openai/gpt-4o-mini')
dspy.configure(lm=lm)

# 2. 定义任务签名
class SentimentAnalysis(dspy.Signature):
    """分析中文电商评论的情感倾向。"""
    review = dspy.InputField(desc="用户评论原文")
    sentiment = dspy.OutputField(desc="positive/negative/neutral")
    confidence = dspy.OutputField(desc="0-1置信度")

# 3. 准备少量训练数据
samples = [
    dspy.Example(review="物流很快,耳机音质超好!", sentiment="positive", confidence=0.95),
    dspy.Example(review="用了两天就坏了,垃圾。", sentiment="negative", confidence=0.98),
    dspy.Example(review="包装还行,还没用不知道效果。", sentiment="neutral", confidence=0.7),
    dspy.Example(review="客服态度太差,但产品质量不错。", sentiment="negative", confidence=0.8),
    # 仅需几十个样本即可
]
# with_inputs 是 Example 的实例方法,列表要逐个调
trainset = [x.with_inputs("review") for x in samples]

# 4. 编译优化
classify = dspy.Predict(SentimentAnalysis)
optimized = dspy.BootstrapFewShot(metric=lambda ex, pred: 1.0 if ex.sentiment == pred.sentiment else 0.0)
compiled = optimized.compile(classify, trainset=trainset)

# 5. 使用编译后的模块——零手写Prompt
result = compiled(review="发货太慢了,但耳机本身质量还可以。")
print(f"情感: {result.sentiment}, 置信度: {result.confidence}")这个示例展示了一条完整的"数据驱动Prompt优化"管线。对比手工写Prompt方案:手工方案每换一个模型版本都可能要调整措辞和示例;DSPy方案只需换lm配置后重新编译。
实际应用场景与最佳实践
CO-STAR和DSPy不是互斥的,它们在工程中各有定位。在实际项目中,推荐按以下层次组合使用:
| 层次 | 方法 | 适用场景 | 维护模式 |
|---|---|---|---|
| L1 固定模板 | CO-STAR | 场景明确、逻辑稳定的任务(如工单分类、FAQ回复) | 人工更新模板 |
| L2 编译优化 | DSPy | 场景变化频繁、追求准确率上限的任务(如内容审核、个性化推荐) | 自动重编译 |
| L3 混合架构 | CO-STAR+DSPy | CO-STAR做Prompt骨架(框架层面),DSPy优化骨架内的变量部分(few-shot示例和指令措辞) | 骨架人工+变量自动 |
最佳实践清单:
不要从DSPy开始。 先用CO-STAR手写几个版本的Prompt,建立对任务的理解。你不知道"怎么算好"就去优化,优化器也会迷路。
标注数据是DSPy的燃料。 DSPy的质量上限不取决于你的Prompt技巧,而取决于你训练数据的质量。十几个精心标注的高质量样本,胜过几百个粗糙样本。
Response Schema是基础设施。 无论用CO-STAR还是DSPy,在所有工程化场景中,为模型输出定义严格的JSON Schema都是第一优先级的事——没有Schema,下游代码无法可靠消费模型输出。
Prompt的版本管理和模型版本绑定。 如果使用CO-STAR手写Prompt,把Prompt文本放入Git管理,并在文档中注明"此Prompt在模型X版本Y上测试通过"。如果使用DSPy,把编译后的程序对象和训练数据一起做版本管理。
不要迷信任何技术。 CO-STAR的价值是结构化和可管理,DSPy的价值是自动化和可优化。但在把数据喂给DSPy之前,先用CO-STAR把问题定义清楚——工具替代的是执行,不是思考。
6.7.2 大模型的工具书:思维链 (CoT, Chain of Thought)
先来看一个典型的翻车现场。你问大模型:
"我有120个苹果,给了张三3个,又给了李四5个,然后张三还了我2个。现在我有多少个苹果?"
模型回答:"114个。"你心算一下:120 - 3 - 5 + 2 = 114。正确。
你接着问:"如果这些苹果每个重150克,总重量是多少公斤?"
模型回答:"17.1公斤。"
问题来了:17.1公斤是怎么算出来的?模型可能在说"120 × 150 ÷ 1000 = 18",然后加上了刚才推理的偏差;也可能根本没算,只是基于训练语料中"114个苹果约重XX"的统计联想给出了一个数字。你不知道。你也无法信任。
这就是单纯"输入→输出"模式的天花板:模型给你一个答案,但没有给你相信它的理由。
思维链做了什么
思维链(Chain of Thought, CoT)做的事情听起来很朴素:在输出最终答案之前,先输出推理过程。
同样是上面的问题,启用思维链后模型的输出会变成:
"我先确定当前有多少个苹果:120 - 3 - 5 + 2 = 114个。 然后计算总重量:114 × 150 = 17100克。 转化为公斤:17100 ÷ 1000 = 17.1公斤。 答案:17.1公斤。"
区别在哪里?不只是格式好看。核心变化有三层:
第一,逻辑显性化。 推理步骤暴露在明面上,你可以检查每一步是否正确。如果模型在第三步"转化公斤"时用了100而不是1000,你能一眼定位到错误所在,而不是对着一个来路不明的数字干瞪眼。
第二,计算能力增强。 大模型的本质是"预测下一段最可能的文本",而不是"执行算术运算"。在没有中间步骤的情况下,模型面对"120-3-5+2×150÷1000"这种复合计算,实际上是在赌一个概率最高的答案。而 CoT 把每一步拆成简单的单步运算,每步的正确答案在训练语料中都有压倒性的统计优势——模型不需要"赌复合运算",只需要"回忆114×150这个乘法的常见结果",错误率大幅下降。
第三,减少幻觉。 幻觉的一个典型来源是模型在信息不足时"脑补"。但 CoT 的推理步骤创造了一种隐式约束:每一步的结论必须是上一步的前提推导出来的。如果模型在中间说"张三还了我3个苹果",读者马上可以发现这和题目条件("张三还了我2个")矛盾。推理链本身就是一面照妖镜,幻觉在步骤之间很难藏身。
一项发表在 NeurIPS 2022 的标志性研究(Wei et al., "Chain-of-Thought Prompting Elicits Reasoning in Large Language Models")证明了这一点:在 GSM8K 数学推理基准上,仅通过加入"Let's think step by step"这一句话,PaLM 540B 的准确率从 33% 提升到 56.5%(提升了 23.5 个百分点)。这个提升幅度相当于在同一基准上超越了当时 SOTA 的微调模型——而它只用了八个单词。
三种构建方式
2026年的工程实践中,思维链有三种实现方式,对应不同的应用场景和成本考量。
第一种:大模型原生推理(System 2 Thinking)
这是最简单的使用方式,也是最高级的实现方式。OpenAI o1、o3、DeepSeek-R1 等推理模型在训练阶段就已经内化了推理能力——它们不需要你在 Prompt 里写"让我们一步步思考",模型内部已经会自发地生成中间推理步骤。
在心理学中,Daniel Kahneman 将人类思维分为两个系统:System 1 是快速、直觉、自动的(比如你看到"2+2="大脑自动蹦出"4"),System 2 是缓慢、分析、需要刻意努力的(比如你在心算 37 × 58)。传统的 GPT-4 和 DeepSeek-V3 更接近 System 1——直接生成答案,快但不一定准。而 o1/R1 类模型本质上是把 System 2 的推理过程显式化了:模型在输出最终答案之前,会在内部经历一段"COT空间"——一个对用户不可见的隐藏推理区域。
这个设计有一个很妙的地方:用户不需要关心推理过程有多长、模型"自言自语"了多久。你只看到最终的、经过推理校验后的答案。代价是延迟——o1 类模型的首次 token 延迟(TTFT)可能比传统模型高一个数量级以上,因为它必须先完成整个内部推理链才能开始输出。
什么时候用原生推理?当任务需要多步逻辑推导(数学、编程、法律分析),且你能接受更高的延迟时,直接用 o1 或 R1,不需要在 Prompt 上做额外设计。
第二种:Few-shot CoT(示例引导推理)
不是所有模型都支持原生推理。GPT-4o、DeepSeek-V3、Claude 这些"标准模型"不会自发产生推理链——你需要通过 Prompt 引导它。
Few-shot CoT 的思路很直接:在 Prompt 中提供几个"问题→推理步骤→答案"的完整示例,让模型学会这种输出模式。比如:
Q: 小明有5个苹果,吃了2个,又买了3个,现在有几个?
A: 小明开始有5个苹果。
   他吃了2个,剩下5-2=3个。
   他又买了3个,现在有3+3=6个。
   答案:6个。

Q: [你的实际问题]
模型看到示例后,会自然地模仿"先推理、后答案"的输出结构。这个方法不需要任何代码层面的改动,纯粹靠 Prompt 设计就能生效。
但Few-shot CoT有一个工程上的坑:示例写得好不好,直接影响效果。 如果你给了一个有逻辑错误的示例,模型会忠实地学习这个错误模式。这也是为什么 DSPy(参见 §6.7.1)这类提示词自动优化工具在2026年变得重要——它可以用算法自动筛选和生成高质量的 CoT 示例,而不是靠人工一行一行地猜。
第三种:强制推理框架(程序化 CoT)
这是最工程化、也是最可控的方式。不依赖模型"自觉"产生推理,而是通过推理框架在代码层面强制插入推理步骤。
在2026年的工程实践中,SGLang 是实现程序化 CoT 的首选框架之一。SGLang 的核心能力是 RadixAttention——一种通过基数树管理 KV Cache 的技术,让多个共享前缀的生成请求可以复用注意力计算结果,这在 CoT 这种"前缀高度相似、后缀各自不同"的场景中带来显著的吞吐量提升。
下面的代码演示了如何用 SGLang 实现一个强制推理步骤的 CoT 流程:
python
import sglang as sgl

@sgl.function
def cot_reasoning(s, question):
    """强制模型按推理→答案的两阶段流程输出"""
    # 阶段1:显式插入思维链指令
    s += "Question: " + question + "\n"
    s += "Let's think step by step:\n"

    # 阶段2:生成中间推理过程
    # max_tokens 防止发散,stop 确保到达答案边界时停止
    s += sgl.gen(
        "reasoning",
        max_tokens=300,
        stop="\nFinal Answer:"
    )

    # 阶段3:基于推理输出最终答案
    s += "\nFinal Answer: " + sgl.gen("answer")

# 执行
state = cot_reasoning.run(
    question="如果 A 股目前处于 3200 点,且主力资金连续三日净流入超过 50 亿,"
             "根据历史统计,这种情况下一周内上涨的概率通常约为 65%。"
             "请给出你的判断和推理过程。"
)
print(f"推理路径: {state['reasoning']}")
print(f"最终结果: {state['answer']}")
这段代码的关键设计有两个:
stop="\nFinal Answer:"—— 明确告诉模型推理阶段的结束标记。没有这个停止字,模型可能在推理过程中就提前给出了答案,破坏了两阶段结构的完整性。sgl.gen("reasoning")和sgl.gen("answer")的分段生成——这两个字段是独立存储的,意味着你可以单独取走推理路径用于日志审计、或单独取走答案用于下游处理。不需要用正则表达式从一段混合文本中去拆。
SGLang 的另一个工程优势是结构化输出。你可以要求模型在 CoT 后输出固定格式的 JSON,不需要担心模型在推理阶段"想得很对"但答案阶段给你一段散文——这在需要将模型输出接入自动化流水线的场景中至关重要。
什么时候用哪种方式
这三种方式不是互斥的,而是形成了一个从"省事"到"可控"的梯度:
| 方式 | 适用场景 | 开发成本 | 推理延迟 | 可控性 |
|---|---|---|---|---|
| 原生推理(o1/R1) | 复杂逻辑推理、数学竞赛级问题 | 零 Prompt 设计 | 高 | 低(内部推理不可见) |
| Few-shot CoT | 标准问答、常规推理 | 中(写示例) | 中 | 中(Prompt 引导,但不保证) |
| SGLang 强制推理 | 自动化流水线、需要审计日志 | 高(写推理函数) | 可由参数控制 | 高(代码级控制) |
在2026年的实际项目中,你的选择通常取决于一个问题:这个推理结果接下来是谁在用?
如果是最终用户直接看答案,原生推理或 Few-shot CoT 足够了——用户不关心模型的推理过程,只关心答案对不对。
但如果答案要进自动化流水线——比如模型的推理结论驱动一个交易策略、触发一个工单创建——那你需要 SGLang 的强制推理框架。不是因为模型不会推理,而是因为在自动化场景中,你需要审计推理路径的可追溯性。当系统自动拒绝了一笔交易申请时,你需要能查到"模型在第三步的推理结果导致了拒绝决策",而不是面对一个无法解释的黑盒结果。
思维链不是让模型变得更聪明的魔法,而是给了你一件在工程上很朴素、却无比重要的东西:可解释的推理过程。 在 2026 年,这决定了你是把一个概率黑盒塞进生产系统,还是把一个有审计能力的推理组件接入自动化流水线。
6.7.3 交互模式的技术字典:Auto-CoT、ToT 与动态推理控制
在 6.7.2 节中,我们讨论了思维链(CoT)的基本原理——让模型"把思考过程写出来",从而在数学推理、符号运算等任务上获得质的提升。但那一节的 CoT 有一个前提:你需要手工设计推理示例(Few-shot CoT),或者依赖模型内置的推理能力(System 2 Thinking)。
手工写推理示例是件苦活。一个数学题还好,但如果你有五千个私有领域的问答对,每条都要配套手工编写推理步骤,这就从"技巧"变成了"瓶颈"。而且手工写的示例本质上是你个人对推理路径的理解——你的理解未必是最优解。
这一节我们介绍三种进阶交互技术。它们不是在 CoT 的基础上"再优化一点",而是在 "谁来构建推理路径" 这个问题上给出了完全不同的答案。Auto-CoT 把构建推理示例的责任从人转移到模型,ToT 把单一路径推理扩展为分支搜索,SGLang 则把推理过程的控制权从模型黑盒交还给开发者。三种技术构成了一个从"自动"到"可控"的光谱。
Auto-CoT:让模型自己写示例
问题从哪里来。
假设你是一家法律科技公司的工程师。公司有三千条真实判例问答——每条包含"案由描述+问题"和"判决结论"。你要用这些数据微调一个法律推理模型,让它不仅能回答"本案判决是什么",还能展示"为什么会这样判"的推理过程。
传统方案是:找三位律师,按 CoT 格式为每条判例手写推理步骤——"首先根据XX法条判断…其次考虑YY因素…最后得出结论…"。三千条,每条200字的推理过程,总计60万字的手写内容。人工费按每千字200元计算,这就是12万的成本。而且三位律师的推理风格不一致——有人喜欢先讲法条再讲事实,有人反过来。
这就是 Auto-CoT 要解决的问题。
核心机制。
Auto-CoT(Automatic Chain-of-Thought)的原理分为两步:
第一步,聚类采样。把三千条判例按语义特征聚成 K 个簇(比如按案由类型:合同纠纷、劳动仲裁、知识产权等),从每个簇中均匀采样,选出具有代表性的案例。这一步的目的是确保生成的推理示例覆盖所有案例类型,而不是集中在一个高频案由上。
第二步,零样本生成推理链。对每个采样的案例,不提供任何推理示例,直接问模型"请一步步推理并给出最终答案"。模型基于自身预训练中习得的推理能力,自动生成推理步骤。这一步被称为 Zero-shot CoT——模型在没有示例的情况下,靠"Let's think step by step"这句魔法触发语,自己走一遍推理过程。
两步合起来就是:先聚类采样选出代表案例,再用 Zero-shot CoT 为每个代表案例自动生成推理链。 生成的这些(案例+推理链+答案)三元组,就是后续 Few-shot CoT 推理的示例库。
核心价值在批量微调数据生成。
Auto-CoT 的自举能力在微调数据生成场景中价值最大。你不再需要律师手写推理步骤——让模型自己读判例、自己写推理链,你只需要审核生成结果的质量。
python
import sglang as sgl
from sklearn.cluster import KMeans
from sentence_transformers import SentenceTransformer

# 1. 聚类采样:从三千条判例中选出代表性案例
encoder = SentenceTransformer('BAAI/bge-large-zh-v1.5')
embeddings = encoder.encode(cases_texts)  # cases_texts: 三千条案由描述
clusters = KMeans(n_clusters=10).fit_predict(embeddings)
# 从每个簇随机采样3条,得到30条代表性案例
sampled = sample_per_cluster(cases, clusters, per_cluster=3)

@sgl.function
def auto_cot_example(s, case_description, question):
    s += f"案情描述:{case_description}\n"
    s += f"问题:{question}\n"
    s += "Let's think step by step:\n"
    s += sgl.gen("reasoning", max_tokens=400, stop="\n结论:")
    s += "\n结论: " + sgl.gen("verdict", max_tokens=200)

# 2. 为30条代表性案例生成Few-shot推理示例
cot_examples = []
for case in sampled:
    state = auto_cot_example.run(
        case_description=case['description'],
        question=case['question']
    )
    cot_examples.append({
        "description": case['description'],
        "question": case['question'],
        "reasoning": state['reasoning'],
        "verdict": state['verdict']
    })

# 3. 用生成的30条示例,为全部三千条案例做Few-shot CoT推理
# cot_examples 被嵌入到 Prompt 模板中作为推理示范
这个流程的工程收益是显著的。人工审核30条推理链的工作量,远小于手写3000条。而且因为示例由模型自己生成,它们在措辞风格、推理粒度上与模型自身的输出习惯天然一致——这比你手写的示例更容易被模型"学会"。研究者发现,Auto-CoT 生成的示例在某些任务上的推理准确率甚至超过人工手写示例,原因就在于"同源同构"的习得优势[18]。
限制与边界。
Auto-CoT 在两个条件下容易出问题。一是领域过于垂直——如果模型在预训练阶段很少见过某领域的文本,它的 Zero-shot CoT 推理链可能充满错误,生成的"示例"反而会误导后续推理。二是推理链的"幻觉自增强"——如果模型在生成第一条推理链时出错,这个错误会被写进示例库,污染后续所有推理。因此,Auto-CoT 不是一个"设定好就不用管"的工具,它需要人工审核把关,只选取推理链正确的示例进入示例库。
ToT:在推理空间中做搜索
单一路径的局限。
无论是 Few-shot CoT 还是 Auto-CoT,它们的推理过程都是线性的——一个步骤接着一个步骤,单向推进,从不回头。这很像走迷宫时永远只选择面前的第一条路,不回头、不比较、不分叉。
这种线性推理在简单问题上不是问题。但在以下场景中,它会暴露短板:
- 架构设计方案:微服务拆3个还是5个?数据库用 PostgreSQL 还是 MongoDB?每个选择引出一个分支,不同分支需要分别探索。
- 代码重构规划:先抽象接口还是先改实现?不同顺序可能影响重构的复杂度和风险。
- 数学证明:有些证明路径走到一半才发现走不通,需要回溯、换思路。
这些场景的共同特点是:推理空间不是一条线,而是一棵树。 这就是 ToT(Tree of Thoughts)设计的出发点。
分支+评估+搜索。
ToT 将推理过程建模为在思维树上的搜索。它的每一次推理步骤不是生成"下一个想法",而是:
- 生成多个候选想法(Branch):比如"代码重构方案A:先抽象接口"、"方案B:先改实现"、"方案C:先写测试然后同时重构"。这一步由模型的生成多样性(temperature > 0)驱动。
- 对每个想法做自我评估(Evaluate):模型阅读每个候选想法,给出评分或投票——"方案A的优点是多少,方案B的风险是多少"。这一步相当于模型自己做"代码审查"。
- 选择/剪枝(Select/Prune):保留高分想法、剪掉低分想法。可以使用广度优先搜索(BFS,探索所有同级分支再深入)或深度优先搜索(DFS,选定一个分支走到黑)。
- 进入下一层:以保留的想法为起点,继续分支→评估→剪枝,直到到达叶子节点(最终答案)。
整个过程自动执行。你只需要在 Prompt 中定义分支格式和评估标准。
代码视角:ToT 的实现骨架。
python
import sglang as sgl

@sgl.function
def generate_branches(s, problem, depth):
    """在推理树的某一层,生成3个候选想法"""
    s += f"当前问题:{problem}\n"
    s += f"当前推理深度:{depth}\n"
    s += "请生成3个不同的下一步推理方向:\n"
    for i in range(3):
        s += f"方向{i+1}: " + sgl.gen(f"branch_{i}", max_tokens=100, stop="\n")
    return s

@sgl.function
def evaluate_branches(s, problem, branches):
    """让模型自己评估每个候选想法的质量(1-10分)"""
    s += f"原问题:{problem}\n"
    s += "请对以下推理方向评分(1-10):\n"
    for i, branch in enumerate(branches):
        s += f"方向{i+1}: {branch}\n"
        s += f"评分: " + sgl.gen(f"score_{i}", max_tokens=10, stop="\n")
        s += f"理由: " + sgl.gen(f"reason_{i}", max_tokens=50, stop="\n")
    return s

# BFS搜索主循环
def tot_search(problem, max_depth=4, beam_width=3):
    current_level = [{"path": problem, "depth": 0}]

    for depth in range(1, max_depth + 1):
        next_level = []
        for node in current_level:
            # 1. 分支
            branch_state = generate_branches.run(
                problem=node["path"], depth=depth
            )
            branches = [branch_state[f"branch_{i}"] for i in range(3)]

            # 2. 评估
            eval_state = evaluate_branches.run(
                problem=problem, branches=branches
            )
            scored = [
                (branches[i], int(eval_state[f"score_{i}"]))
                for i in range(3)
            ]

            # 3. 剪枝:保留前 beam_width 个高分分支
            scored.sort(key=lambda x: x[1], reverse=True)
            for branch, score in scored[:beam_width]:
                next_level.append({
                    "path": node["path"] + " → " + branch,
                    "depth": depth
                })

        current_level = next_level

    return current_level  # 最优推理路径
这个骨架揭示了 ToT 的本质:它把 LLM 从一个"生成器"变成了一个"生成器+评估器+搜索控制器"的复合系统。 模型不再只是输出文字,而是自己生成、自己评分、自己筛选。
延迟陷阱:ToT 的成本清醒剂。
ToT 的威力来自它的计算量。每个推理层生成 B 个分支,每个分支调用一次模型;搜索到深度 D,总调用次数是 B^D 量级。假设 B=3,D=4,一次完整搜索就是 3^4=81 次模型调用。每次调用平均 1000 token,总消耗约 81000 token。而同样的问题,普通 CoT 可能只需要一次调用、500 token。
ToT 的时间开销通常是普通对话的 10 倍以上。 在实时客服、在线问答等延迟敏感场景中,ToT 不可用——用户不会等30秒看一个"深度推理"后的客服回复。
ToT 的合理应用场景是"慢思考"任务:架构设计评审、代码重构计划、数学定理证明、法律判决推理。这些场景中,几分钟甚至几十分钟的推理时间是可以接受的——因为你追求的不是响应速度,而是决策质量。
2026年实践建议:ToT 的简化替代方案。
纯正的 ToT 实现较重。在实际项目中,有两种更轻量的替代方案值得优先考虑:
Self-Consistency(自洽性采样):让模型对同一问题生成 N 个独立推理链(temperature > 0),取出现频率最高的答案。这相当于 ToT 在根节点做了一次 BFS,但没有分支展开的后续深度搜索。实现简单,30-50行代码即可,在多选题和数学题上效果接近 ToT 的 80%。
Reflexion(反思机制):让模型先回答,然后对自己的回答做结构化批评("这个推理哪里可能有问题?"),根据批评修正回答。这相当于 ToT 的 2 层搜索:答案 → 评估 → 修正答案。比 Self-Consistency 更深一步,但远轻于完整 ToT。
Table 6.7-1: CoT 系列技术对比
| 技术 | 推理路径 | 计算开销 | 适用场景 | 实现复杂度 |
|---|---|---|---|---|
| Few-shot CoT | 单一路径 | 1× | 简单推理、问答 | 低(手工写示例) |
| Auto-CoT | 单一路径 | 1×(生成时 K×) | 批量微调数据生成 | 中(聚类+采样+审核) |
| Self-Consistency | 多路径投票 | N× | 多选题、数学题 | 低(30行代码) |
| ToT | 分支搜索 | B^D× | 架构设计、代码重构 | 高(需实现搜索算法) |
| Reflexion | 反思修正 | 2× | 代码生成、问题解答 | 中(需定义批评模板) |
SGLang / Guidance:把推理控制权拿回来
推理过程的"黑盒"问题。
普通 CoT 和 ToT 都依赖于一个前提:你信任模型能自己生成合适的推理过程。但这个信任不是无限的。模型的生成过程是一个概率采样过程,它可能在以下时刻"脱轨":
- 推理完成后没有自动停止,开始胡言乱语("综上所述……此外,我还想补充……顺便提一句……")。
- 在结构化输出场景中,模型忘记遵守指定的 JSON Schema,输出了一个格式错误的字段。
- 推理链中出现循环——模型把同一句话反复说了三遍,消耗 Token 却没有任何新信息。
这些都是"黑盒生成"的典型问题:你只能告诉模型"请推理",但无法精确控制它怎么推理、什么时候停止、什么时候换方向。
SGLang 和 Guidance 就是为解决这个"控制权缺失"问题而设计的。
核心机制:在 Prompt 中插入程序控制。
SGLang 的所有操作都围绕一个核心模式:你在 Prompt 中用 Python 代码显式控制模型的生成过程。 不再是"你写一个 Prompt → 模型输出一大段文本",而是"你写一个函数,函数中用 sgl.gen() 精确控制每一段生成的 token 数、停止条件和变量绑定"。
你已经在前面的 ToT 和 Auto-CoT 代码中看到了这种模式。下面是一个更直接的对比——同一个任务在两种范式下的写法差异。
传统 Prompt 方式(黑盒):
python
prompt = f"""
问题:{question}
请一步步推理,最后给出最终答案。
"""
response = model.generate(prompt)
# 你拿到了一大段文本,需要手动解析"推理"和"答案"
# 如果模型在推理后面又加了废话,你的解析代码就挂了
SGLang 方式(可控):
python
@sgl.function
def controlled_reasoning(s, question):
    s += f"问题:{question}\n"
    s += "推理过程:\n"
    # 精确控制:最多300 token,遇到"\n最终答案:"立即停止
    s += sgl.gen("reasoning", max_tokens=300, stop=["\n最终答案:", "\n综上所述:"])
    s += "\n最终答案: "
    # 答案部分单独生成,最多100 token
    s += sgl.gen("answer", max_tokens=100, stop=["\n"])
    # 现在你可以安全地读取 s["reasoning"] 和 s["answer"],不存在解析问题
两个关键区别:
- 生成阶段化:每一步生成(推理、答案)有独立的 token 预算和停止条件。推理部分占用太多 token?调整
max_tokens。推理完成后模型还在说废话?设置stop字符强制停止。 - 输出结构化:每个生成块的文本被绑定到 Python 变量(
reasoning、answer),你可以直接通过字典访问,不需要做字符串解析。
Stop 字符的工程价值。
在传统 Prompt 工程中,"阻止模型说废话"是一个让无数工程师抓狂的问题。你可能在 Prompt 中写"请严格按要求输出,不要添加额外内容",模型会答应你"好的,我会严格按要求输出"——然后继续输出额外内容。
SGLang 的 stop 参数从根本上解决了这个问题。它不是"请求"模型停止,而是在 token 级别强制截断生成。当模型生成的 token 序列命中 stop 模式时,推理引擎直接终止生成,不返回 stop 模式之后的任何内容。
python
# 例子:用 stop 字符实现"推理→答案"的两段式强制分界
s += sgl.gen("reasoning",
    max_tokens=500,
    stop=["\n答案:", "\n最终回答:", "\n所以,"])

s += "\n答案: " + sgl.gen("answer", max_tokens=100)
这里 stop 字符 "\n答案:" 的作用是:推理部分生成了"根据以上分析"后,模型很可能想输出"答案:A是对的",但 SGLang 在检测到 \n答案: 时立即截断,不给你这个机会。然后你显式地写入 "\n答案: ",开启第二段生成。两段生成的边界是代码决定的,不是模型决定的。
Guidance:另一种控制哲学。
SGLang 的前身/姊妹项目是 Guidance(由微软开发,GitHub: guidance-ai/guidance)。两者的理念相近——都通过在 Prompt 中插入程序控制来约束生成。但它们的控制粒度不同:
- SGLang 偏向于 RadixAttention 优化(KV Cache 复用):如果你的多个 Prompt 共享相同的前缀(如 System Prompt),SGLang 会自动缓存前缀的 KV Cache,后续调用直接复用,大幅降低首 token 延迟和计算量。这在批量推理(几百个请求共享同一个 System Prompt)场景中有数量级的性能提升。
- Guidance 偏向于模板和约束的灵活表达:它的语法更接近 Handlebars 模板,支持
{{select "选项1 | 选项2 | 选项3"}}这种约束选择、{{gen "name" pattern="[0-9]+"}}这种正则约束。更适合单一请求中的复杂逻辑控制。
在2026年,两者的边界已经模糊:SGLang 也支持正则约束,Guidance 也集成了 SGLang 作为后端。选哪个取决于你的主要瓶颈——是"吞吐量"选 SGLang,是"单请求的复杂控制便利性"选 Guidance。
Table 6.7-2: SGLang vs Guidance 对比
| 维度 | SGLang | Guidance |
|---|---|---|
| 核心优势 | RadixAttention KV Cache复用,批量推理性能 | 模板语法灵活,约束表达力强 |
| 编程模型 | Python 装饰器 + sgl.gen() | Handlebars 模板 + API |
| 最适合场景 | 高吞吐推理服务(RPM>100) | 单请求复杂逻辑控制 |
| 学习曲线 | 低(就是 Python) | 低(模板语法直观) |
| 2026年生态 | 与 vLLM 并列为推理引擎双子星 | 深度集成到自部署 Agent 系统 |
Use Case 选择建议。
面对 Auto-CoT、ToT 和 SGLang/Guidance 三种技术,选择不总是非此即彼。很多时候,它们是组合使用的——SGLang 的精确控制能力本身就是实现 ToT 和 Auto-CoT 的底层工具(你刚才看到的 ToT 和 Auto-CoT 代码就是基于 SGLang 写的)。
但当你需要判断"当前场景该优先关注什么"时,以下是选择方向:
你有大量私有数据需要微调,但缺少推理标注 → 从 Auto-CoT 开始。 它帮你解决的是"标注成本"问题,不是推理质量问题。
你的任务需要多方案比较或探索性推理 → 从 Self-Consistency 或 Reflexion 开始,谨慎升级到 ToT。 大多数"我需要树搜索"的场景实际上用 Self-Consistency 就够用了。只有当你明确感知到"单次推理经常走入死胡同,需要回溯"的时候,才值得投入 ToT 的工程复杂度和延迟成本。
推理服务需要高吞吐或精确的生成控制 → SGLang 是默认选项。 如果你的系统已经基于 vLLM 构建推理服务,SGLang 可以无缝集成。如果追求极致的单请求控制体验,考虑 Guidance。
构建 Agent 系统 → 三种技术在不同环节各有用处。 规划模块可能需要 ToT(多方案搜索),执行模块用 SGLang 控制工具调用的格式边界,知识注入模块用 Auto-CoT 生成微调数据。一个问题域,多种技术,各取所长。
小结
从 6.7.1 的提示词工程(COP-STAR + DSPy),到 6.7.2 的思维链基础(Few-shot CoT + Zero-shot CoT),再到本节的三项进阶技术,我们走完了一条从"让模型听懂"到"让模型想好"的技术路径。
这条路径的核心主题是控制权的迁移。在提示词工程中,控制权在你手里——你精心设计 Prompt 的每个要素。在普通 CoT 中,控制权开始向模型偏移——你给它"一步步思考"的框架,但具体怎么思考是模型的事。在 Auto-CoT 中,你连框架都不给了——模型自己聚类、自己生成推理示例。在 ToT 中,模型不仅思考,还自我评估、自我剪枝——它成了一个自洽的搜索系统。而在 SGLang/Guidance 中,控制权又完整地回到了开发者手里——用代码精确控制每一段生成。
这不是一个谁取代谁的故事。它们构成了一个工具箱:你不知道模型在想什么的时候,打开 CoT 让它写出来;你觉得单一思路太单薄的时候,打开 ToT 让模型多走几条路;你需要精确控制输出的时候,打开 SGLang 用代码接管生成。 2026 年的一流工程师,不是记住所有 Prompt 技巧的人,而是知道在什么场景下该打开工具箱里的哪一件。